
昨天有提到「資料清理」,所以今天想再進一步了解資料清理到底要做什麼,以及遇到不同的問題時應該怎麼處理。
在開始分析之前,需要先確保拿來分析的資料是可以使用的,不然就算分析的方法沒有問題,最後得到的結果還是可能受到原始資料影響。
資料清理大概可以分成幾個部分:
N/A或是空白。good、Good、GOOD 只是大小寫不一致,但代表同一個意思。前天已經發現 N/A 不能直接拿去計算,但還沒了解遇到缺失資料時可以怎麼處理。
方法 A|直接刪除
如果這筆資料缺少的內容太多,或是已經沒有辦法使用,就可以考慮直接刪除,避免影響整體數據。
方法 B|使用平均值填補
例如 sleep_hours 出現 N/A,可以利用目前其他天的睡眠時間的總平均值來進行填補。
方法 C|保留 N/A
再來也不一定要把整筆資料刪掉。如果只有 sleep_hours 缺少資料,那麼只在需要在使用 sleep_hours 分析的時候略過這筆資料就好,其他欄位還是可以繼續使用。
經由這些方法,我發先需要對不同的功能選擇不同的處理方式,因為可能影響最後分析出來的結果。
除了缺失值之外,還有一種情況是 Outlier,也就是離群值。簡單來說就是禿然出現不符合常理,跟其他數據相差過大的數值,像是睡眠平均值在5~8小時,卻有一筆13小時的睡眠紀錄。不過Outlier不一定代表資料是錯的,也有可能那天真的睡了這麼久,所以我覺得不能預設看到極端的數據就直接刪除,而是先標記起來顯示有異常,再去確認資料的真實性。
因此在了解不同的問題之後,我也試著依目前的睡眠資料訂定一些清理規則。
1.N/A 或空白
可能發生的情況是那一天沒有記錄到,如果直接補成 0,反而會影響分析結果。所以需要使用這個欄位進行分析時應該先略過,只分析其他有資料的欄位。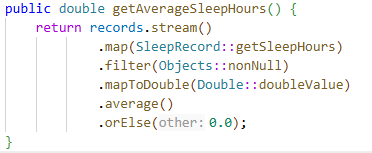
.filter(Objects::nonNull)中可以篩選資料是否為null,最後只保留不是null的東西。
2.前後多餘的空格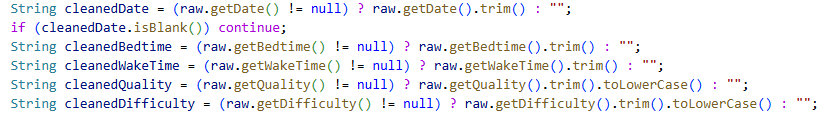
刪除空格不會改變資料原本的意思,所以可以直接利用之前學到的.trim()去除。
3.重複資料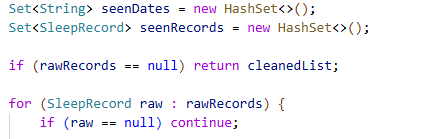
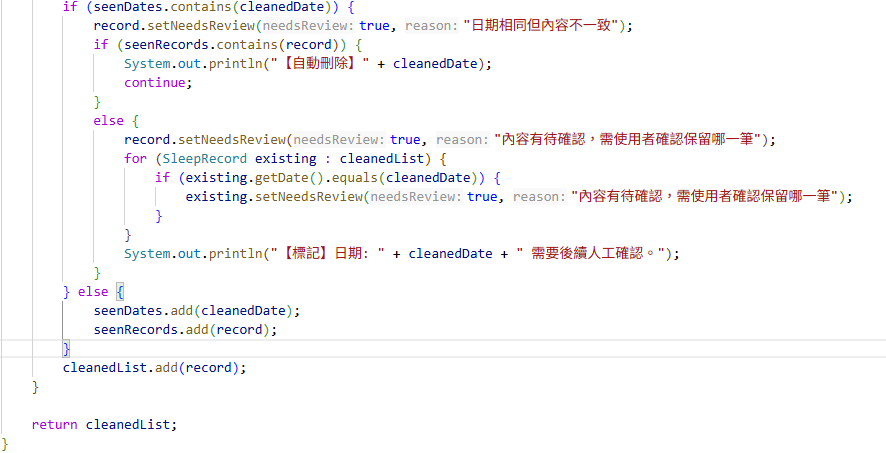
我的睡眠資料設定成一天只有一筆,所以如果同一個日期出現兩次,就代表可能有重複資料。我學到可以利用 HashSet 記錄已經出現過的日期。當程式再次遇到相同日期重複內容的資料時,就保留第一筆,把後面重複出現的資料刪除。但如果日期相同,內容卻不完全一樣,就先標記這兩筆資料,再讓使用者決定要保留哪一筆。
4.極端數據(Outlier)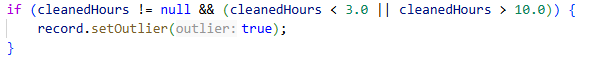
目的是當某項睡眠數據明顯和其他資料差很多,先標記為可能的Outlier。所以我先根據自己平常的睡眠情況設定一個簡單的判斷範圍。利用setOutlier(true)將這筆資料標記起來,先確認這筆資料是不是輸入錯誤,如果資料本身沒有錯再保留。
今天最大的發現是不同的資料清理方法本身可能影響最後的分析結果,所以比起讓程式直接把有問題的資料刪掉,我覺得先找出問題、訂定規則,再決定怎麼處理會比較適合。


 iThome鐵人賽
 看影片追技術