
處理了一下目前定義的資料清理的問題,讓需要分析的資料盡量可以維持一致。但我發現另一個問題,在第四天設定的分析中關於「任務量是否與入睡時間有關?」和「任務難度是否與睡眠品質有關?」的關係要如何判定程式跑出來太片面了。原本我的想法比較簡單,只要觀察資料的變化,看看任務比較多的時候是不是也比較晚睡,就可以判斷兩者之間有沒有關係。但如果只是「看起來很像有關」,真的就代表它們有關係嗎?所以今天想進一步了解,到底可以怎麼判斷兩個資料之間的關係。在判斷資料之間的關係之前,可以先了解目前的資料大概長什麼樣子。而其中最簡單的方法就是之前已經使用過的平均值、最大值和最小值。
描述統計是在判斷資料之間的關係之前,先了解目前的資料大概長什麼樣子,例如前面使用的平均值、最大值和最小值。以目前的睡眠資料:平均睡眠時數、最長睡眠時數、最短睡眠時數、不同睡眠品質的平均睡眠時數。如果 good 的平均睡眠時數比 bad 高,就可以說在目前這份資料中,睡眠品質為 good 的紀錄有比較高的平均睡眠時數。然而這並不代表睡得越久就一定會造成比較好的睡眠品質。
這個分析的結果會落在 -1 到 1 之間,常被用來描述兩個數值變數之間的線性關係。
簡單來說:
接近 1 → 越接近正相關
接近 0 → 線性關係較不明顯
接近 -1 → 越接近負相關
因此我拿這個概念思考:任務量是否與入睡時間有關?
例如當任務量增加的同時,入睡時間也經常增加,就可能得到正的相關係數。但這不能直接代表「兩個資料有關」。因為相關係數的大小、資料量,以及資料中有沒有特殊值,都可能影響結果。
從上面的概念就可以得出相關不代表因果,假設最後真的發現:任務越多的日子,通常也睡得越晚。這並不能歸因於是任務變多,所以造成我比較晚睡。因為也可能存在其他原因,可能是當天情緒不佳導致失眠而晚睡。所以應該要找到更好量化兩個資料之間的關係。
再來是「任務難度是否與睡眠品質有關?」他和前面tasks、bedtime的相關性又不太一樣。
以目前設定的是:
difficulty = easy / medium / hard
quality = good / normal / bad
然而它們並不是一般的連續數字。之前將它們轉換成數字方便計算,例如:easy = 1、medium = 2、hard = 3
但這並不等同於hard實際等於easy的三倍。
我發現目前的資料最多只能幫助我觀察兩者是否一起變化,不能因此直接判斷因果關係。更重要的是透過這些資料,了解不同的分析方法到底在做什麼。沒想到理解資料分析不只是把公式寫進程式而已,還要思考資料能不能使用、應該使用什麼分析方法,以及分析結果到底代表什麼。
回到原本的 SleepAnalyzer,重新處理「任務量與入睡時間」的分析,打算在分析流程加入相關係數的計算,讓分析除了觀察資料變化,也能有數值作為判斷的依據。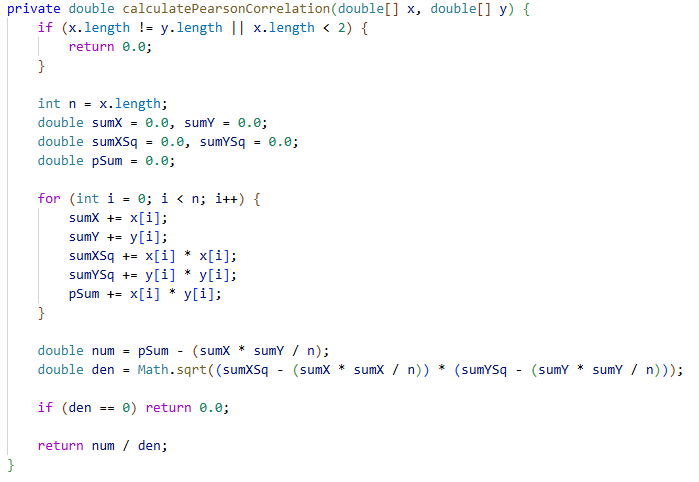
if (x.length != y.length || x.length < 2)先檢查要比對的數據數量是否一致跟總數不能低於2,不然無法計算相關係數。接著加入皮爾森相關係數的計算。calculateCorrelation()會先分別計算任務量與入睡時間的平均值,再比較每一筆資料和平均值之間的差距,最後計算出兩組資料的相關係數。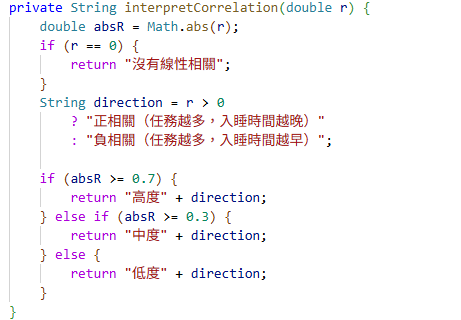
利用interpretCorrelation()判斷結果。再使用Math.abs()取得的絕對值,用來判斷相關程度是低度、中度還是高度相關,最後根據r > 0判斷結果是正相關還是負相關。


 iThome鐵人賽
 看影片追技術