
前一天先說明了這次準備遷移的微服務、container 與外部依賴服務,從今天開始就正式進入 Kubernetes 的主題。
首先我想從 Control Plane 開始,並先認識四個主要參與 Kubernetes 叢集生命週期的元件:API Server、etcd、Scheduler 與 Controller Manager,
預期上是希望能夠先釐清 Kubernetes 底層是怎麼運作的,
以及分別由哪些服務角色維持、協調與控制整個叢集,
了解這些角色之後,後續在看 Pod 為什麼會被派發到某個 Node、如何被建立,以及 Deployment 的 Rolling Update 為什麼能持續替換版本時才會有更具體的畫面。
Kubernetes 叢集運作時,Node 大致可依責任區分為 Control Plane Node 與 Worker Node。
所謂 Node,可以先把它理解成提供 CPU、Memory、網路與儲存資源給 Kubernetes 使用的一台主機,
而在企業環境中,它通常是一台安裝 Linux 的 VM,但也可能是實體伺服器。
Control Plane Node 負責叢集的管理與決策,Worker Node 則負責實際運作 Pod,當然也有服務是 Control Plane 與 Worker 都需要一起運作的,例如監控類的 Prometheus。
兩類 Node 的數量、資源大小與分布方式,會直接影響叢集的可用性與可配置資源,
例如 Control Plane 是否具備高可用性,Worker Node 是否有足夠 CPU/Memory 讓 Scheduler 分派 Pod,都是後續會遇到的議題。
在 Docker Compose 的概念中,我們常常是下達一個立即命令:把某個 container 跑起來或是下架,但在 Kubernetes 中,操作的概念比較偏向是描述結果,例如「我要三個 api-a Pod,而且它們必須使用這個 image」,而這樣的描述是期望狀態(desired state)。
實際上跑著幾個 Pod、它們在哪個 Node、是否健康則是實際狀態(actual state)。
Control Plane 會不斷觀察兩者是否一致,當兩者狀態不一致時,就會開始嘗試對叢集這些不一致的資源進行一系列的溝通與動作(例如重新啟動 Pod),直到整體狀態都達到當初宣告的期望狀態,
這就是 Kubernetes 能讓 Pod 自我修復與滾動更新的基本概念。
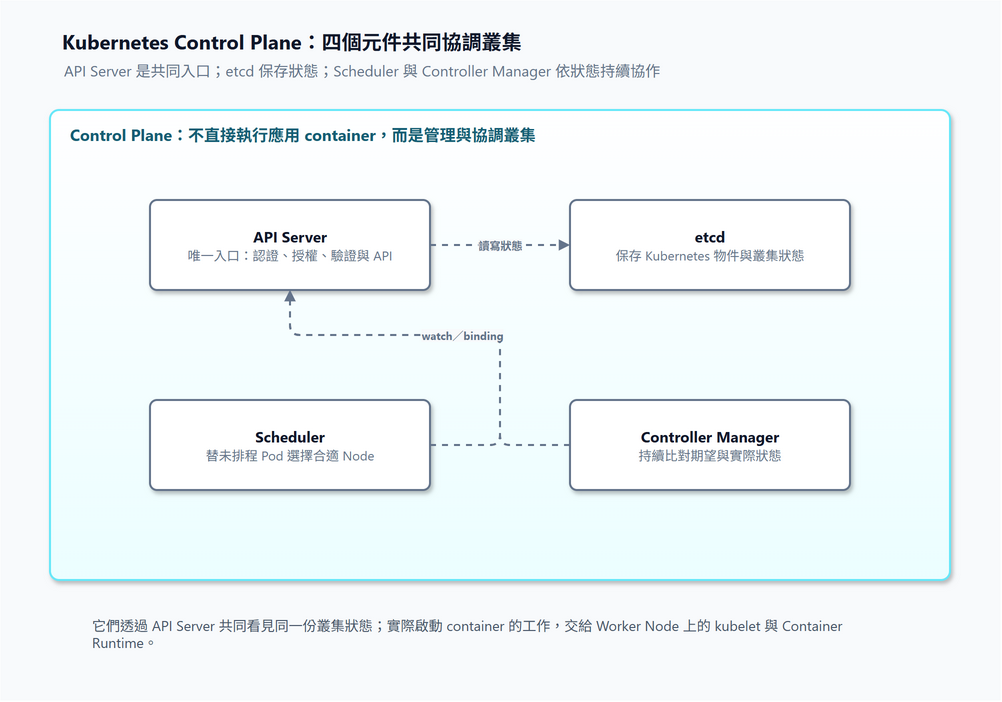
| 元件 | 角色 | 主要責任 | 它不負責什麼 |
|---|---|---|---|
| API Server | 叢集的唯一受理窗口 | 驗證請求、認證、授權、准許控制,並提供所有元件共同使用的 API | 不直接替你挑 Node 或執行 container |
| etcd | 叢集的記憶 | 保存 Kubernetes 物件與叢集狀態 | 不會主動建立或修復 Pod |
| Scheduler | 排班/派工者 | 為尚未綁定 Node 的 Pod 選出合適 Node | 不會在 Node 上啟動 container |
| Controller Manager | 持續巡邏的管理者 | 用控制迴路讓實際狀態回到期望狀態 | 不會自己取代 API Server 成為窗口 |
這四個元件通常在 Control Plane Node 上運作,而相對的,真正執行應用程式 container 的是 Worker Node;
Worker Node 上的 kubelet 才會依照分派給自己的 PodSpec 呼叫 Container Runtime。
當我們輸入:
kubectl apply -f api-a-deployment.yaml
kubectl 是操控 Kubernetes 最重要的工具,後續開始進行部署時都會跟這個工具脫離不了關係。
以套用 YAML 情境來看,送出 kubectl apply -f api-a-deployment.yaml 指令就是在告訴 Kubernetes 我們希望的狀態,
而這個指令的背後實際上是把 YAML 轉成 HTTPS API 請求送往 API Server。
而 CI/CD、Kubernetes Dashboard、Operator 與其他 control-plane 元件也走同一個入口,
這個設計讓所有變更都能用一致的身分驗證、權限控管來建立操作限制。
一個建立或更新的請求大致會經過四道關卡:
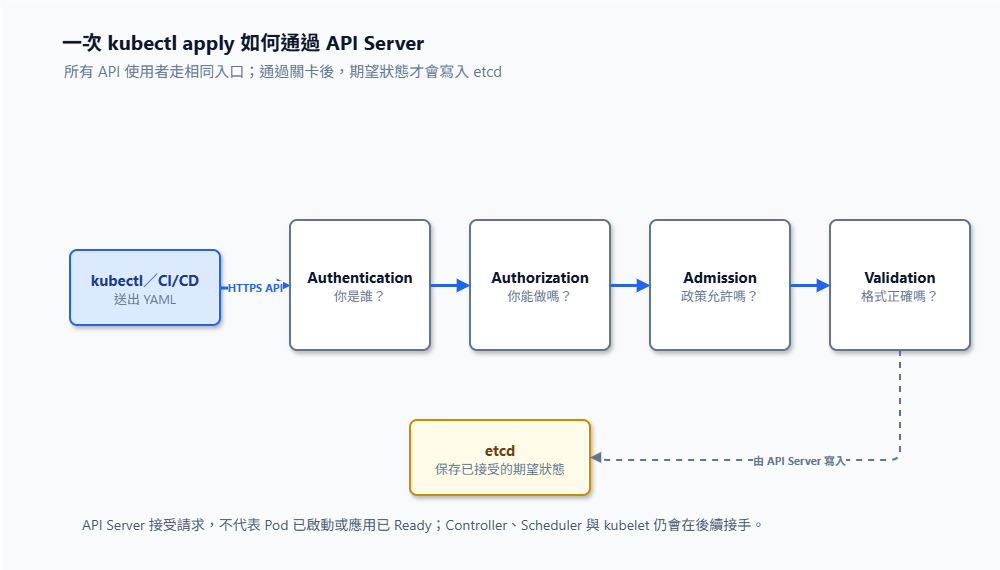
API Server 是狀態的最主要入口,不會負責工作排程,也沒有直接部署服務的能力,
而是與其他元件溝通,透過 watch API 看到物件變化之後再做回應。
etcd 是一個分散式 key-value 儲存系統,
Deployment、Pod、Service、ConfigMap、Secret 等 Kubernetes 物件的宣告與狀態,
都以 API Server 管理的形式保存其中,
以及當 Control Plane 故障後能否回復,etcd 的資料與備份也會是必要的達成條件。
因此有兩個重要原則:
在受管控 Kubernetes 平台中,etcd 通常由平台團隊維護,並且規劃與處理備份、還原的相關規範。
當 Controller 建立一個新的 Pod 時,Pod 一開始可能還沒有 nodeName,
而 Scheduler 會監視這些尚未被排程的 Pod,
依據多個條件去選出最合適的 Node,然後透過 API Server 回寫綁定結果。
它的工作可以大概如下:
所以如果 K8s 規劃者不清楚整個 AP 系統的 CPU、Memory 資源使用率,後續將這些容器部署到 K8s 內時,
設定這些 Pod 的資源最高、最低需求限制時就很容易沒有頭緒或是設計出偏離現實的配置,如此就會導致 Pod 無法被正確啟動並且以為是 Worker Node 資源不足,進而再擴充 Node 的資源,甚至是實體機的硬體設備導致浪費。
Scheduler 做完決策後不會替 Node 啟動 container,而是在被選中的 Node 透過 kubelet 看到屬於自己的 Pod 後,才會透過 Container Runtime 拉取 image、建立 container,並回報狀態。
Controller Manager 是多個 controller 的集合,每個 controller 都遵循這樣的流程:
觀察(observe)→ 比對(diff)→ 調整(act)→ 再觀察,所以並不是在送出 kubectl apply 後只執行一次,而是持續不斷的運作。
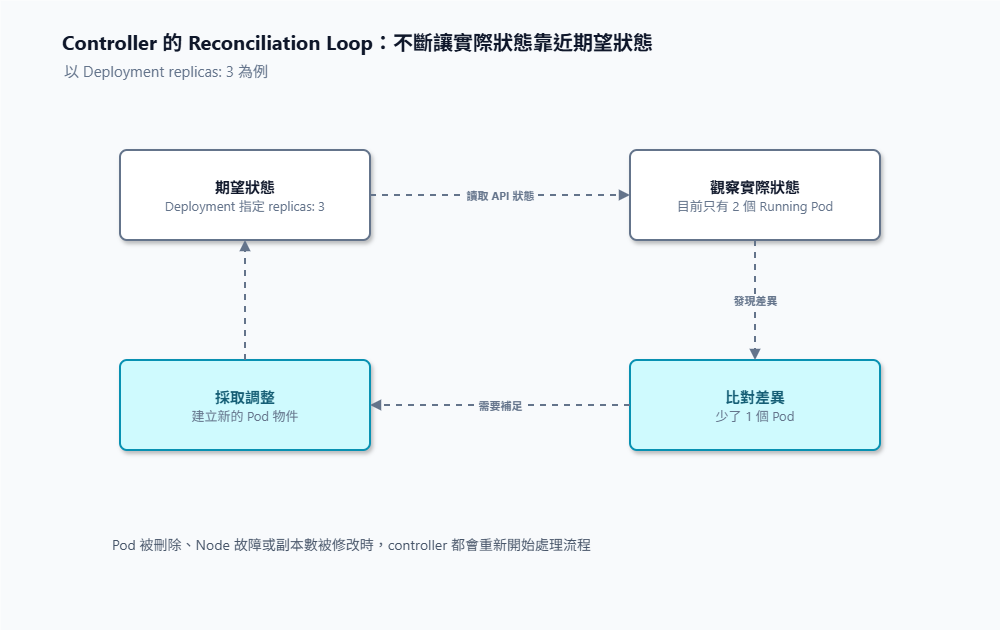
以 Deployment 為例:
replicas: 3,Deployment Controller 看到這個期望。除了 Deployment 與 ReplicaSet,還有 Node Controller、Job Controller、EndpointSlice Controller 等許多 controller,每個 Controller 都有不同職責,藉此維持各種資源的期望狀態。
現在把四大元件透過「部署三個 api-a 副本」的例子來說明整個流程:
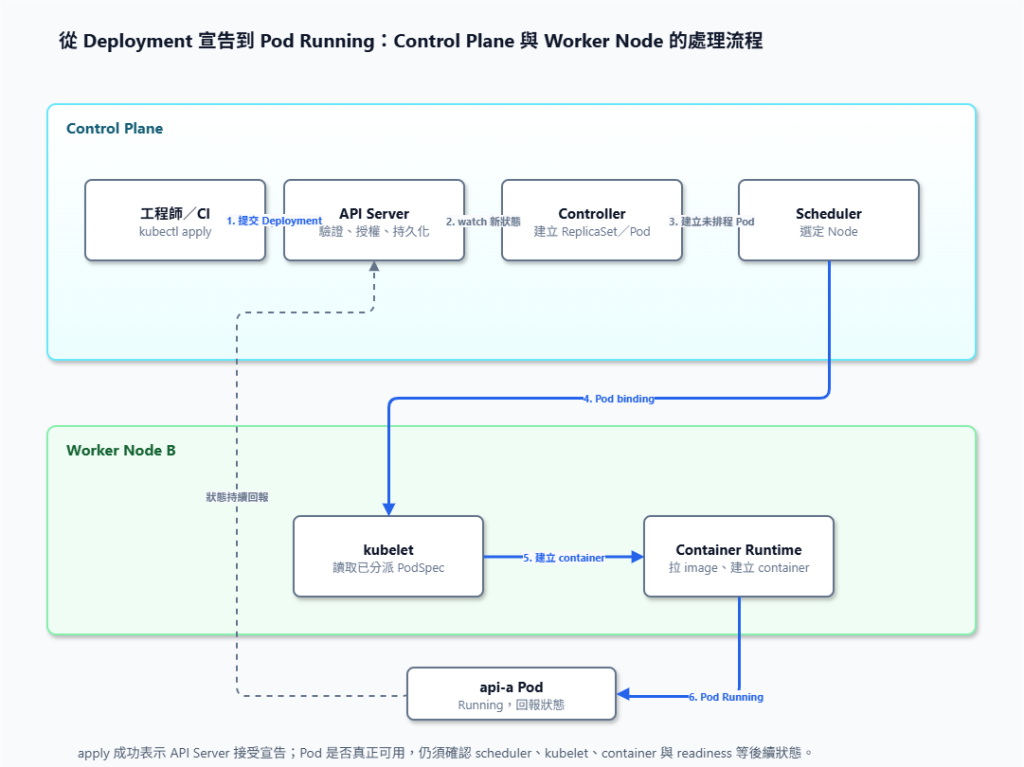
注意這不是一條單向的流程,第 6 步之後,Kubernetes 仍會持續確認目前的實際狀態是否符合我們在 Deployment 中宣告的目標,
如果 Pod 異常、被手動刪除、Node 不可用,或是我們修改了副本數,Controller 就會再次採取動作,
盡量把叢集恢復成原本要求的狀態。
今天先認識了 Kubernetes Control Plane 的四大元件:
下一篇會接著說明 Worker Node:kubelet、Container Runtime 如何接手已經被排程的 Pod,了解 container 是如何在 Worker Node 上運行。


 iThome鐵人賽
 看影片追技術