
Day27 說了 Harbor 跨站複寫,讓不同站點都能取得需要的 image。接著就有另一個問題:服務部署在兩個站點,使用者的請求要送去哪裡?其中一站無法提供服務時,流量又怎麼切換?
今天會透過站點 A 與 B 的情境,說明 DNS-based GSLB 與 Istio 的分工,並且透過單站服務下線來觀察流量會怎麼被傳輸。
Kubernetes 能在叢集裡管理多個 Pod,而雙站點則可以讓服務分散到不同機房或區域,降低單一站點因為電力、網路或基礎設施故障造成的影響,如果某站點真的發生問題時,也可以有另一站作為備援繼續處理請求,讓服務不因此中斷。
不過,維護範圍也會增加:
GSLB 是 Global Server Load Balancing,用來處理多站點的一項技術,而不同產品有不同做法,今天的文章會透過 DNS-based 這一種方式的 GSLB 來說明。
假設 A、B 兩個站點都能提供 api.example.com 的服務,則大概可以把過程分成兩段:
DNS 選站完成後,HTTP 請求直接連到選中的站點,DNS-based GSLB 負責的是回應 DNS 解析結果。
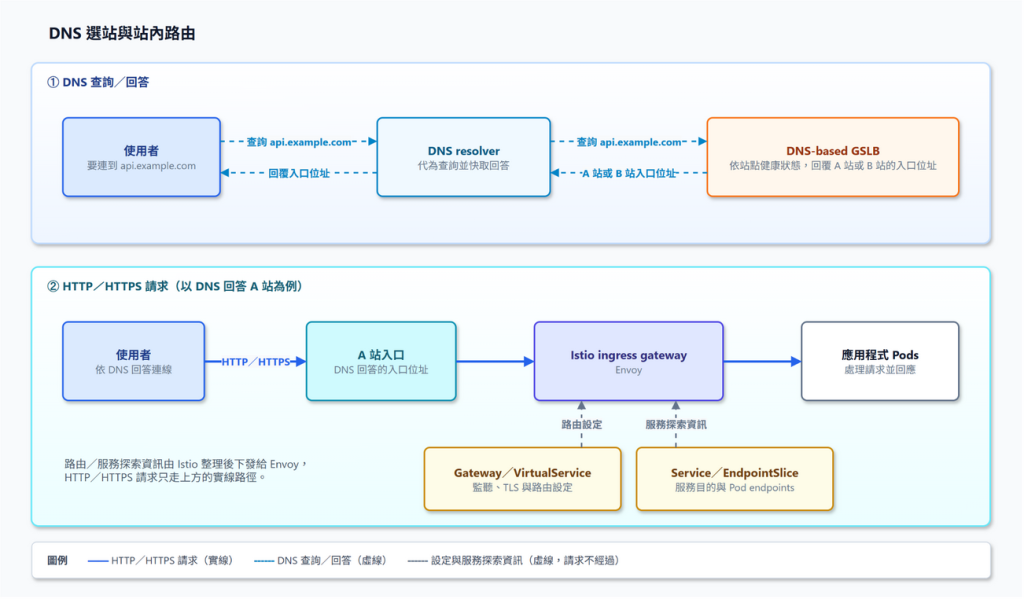
例如這次回覆 A,請求就進入 A,之後 A 的健康檢查失敗,而 B 仍可服務,選站規則可以讓後續 DNS 回答改選 B。
DNS 權重影響的是 DNS 回答的選擇。resolver 快取、用戶數與連線重用,都會影響實際流量,所以 DNS 權重與 HTTP 請求比例可能有落差。
沿用 A、B 兩站,可以採兩種常見安排:
Active/Active 能持續使用兩站資源,要安排好資料寫入與狀態一致性。Active/Standby 的日常流量比較集中,備援站則要定期驗證;需要擴容或啟動元件時,準備時間也會影響恢復速度,納入選站前要確認服務已就緒。
這些名稱要搭配範圍來看。某個 API Gateway 有兩台主備設備,說明的是那一層設備的安排;跨站服務如何切換,則由跨站健康判斷與流量規則處理。
GSLB 選擇用戶端接下來連到哪一站。進入該站後,就回到 Day21 說過的 Istio 入口與路由:
/api 送到 api-a。Gateway、VirtualService 是設定資源,請求由 ingress gateway 的 Envoy 依設定處理。Istio 整理路由與服務探索資訊後下發給 Envoy,Envoy 可以選擇對應的 Pod 轉送請求。
站內 Pod 的 readiness 影響可選的服務 endpoints;跨站健康檢查則影響站點是否繼續被納入選擇。兩者各有自己的觀察範圍。
假設 A 的 API 發生問題,B 仍可正常服務。這個故障切換過程叫 failover,會受到下面幾件事影響:
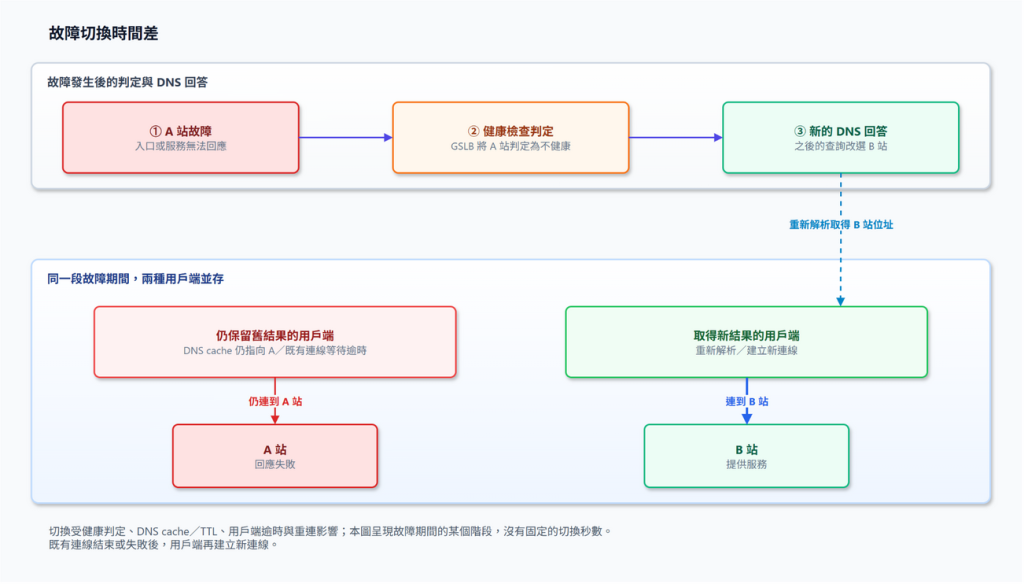
TTL 控制 DNS 紀錄的快取時間。較短的 TTL 通常能讓舊結果較快到期,也會增加 DNS 查詢次數。
例如 TTL 設為 30 秒,實際恢復時間仍受到上述因素影響。DNS 回答更新後,既有連線會持續到結束或失敗,後續由用戶端重新建立連線。
健康檢查也要選好內容:TCP 檢查觀察連接埠能否接受連線;HTTP 檢查則指定 Host、路徑與預期狀態碼。路徑要能反映服務能力,並避免每次都執行昂貴的業務操作。
流量能到 B,接著要看 B 是否具備完整的服務條件:
資料同步越即時、備援容量越完整,通常需要更多成本;可以依服務允許的恢復時間與資料落差選擇安排。
A 修復後,重新讓它接回流量的過程叫 failback。可以先確認服務、資料與容量已恢復,再逐步納入,或安排手動切回。是否自動恢復選站,取決於產品與設定。
驗證時,可以記錄故障發生、健康狀態更新、請求成功率與恢復時間,讓切換流程有實際數據可看。
我在一個雙站專案裡,先把外部與內網流量分開整理:
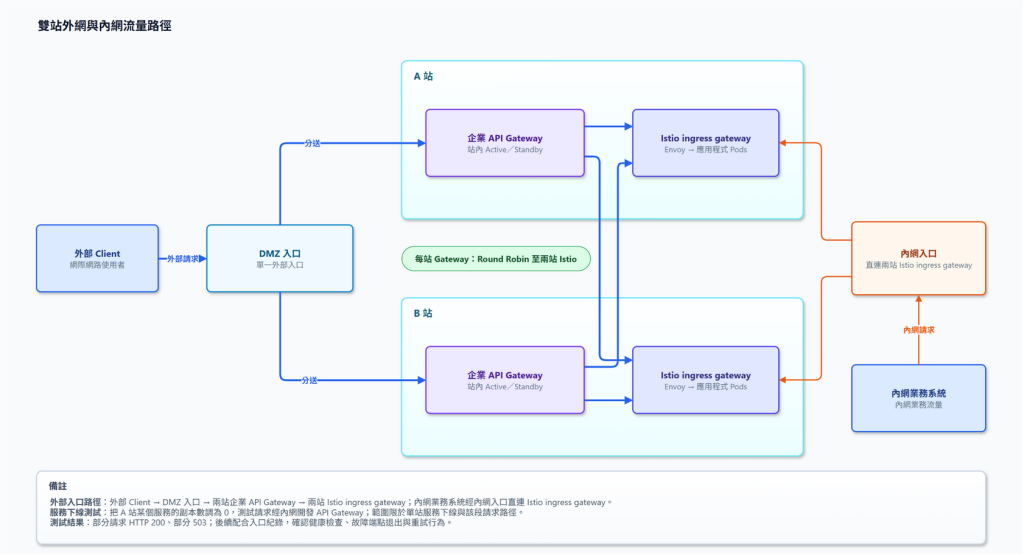
這個案例的跨站分流由 API Gateway 處理,與前面用來說明概念的 DNS-based GSLB 情境分開看。
後來透過內網開發環境的 API Gateway執行測試,暫時把 A 站某個服務的副本降到 0,維持 10 分鐘,B 站服務持續就緒。
九個完整下線分鐘裡,約一半請求成功,另一半收到 HTTP 503;A 站服務恢復後,觀察區間的請求回到全部成功。
這次能確認的是:在當時的路徑與設定下,單站服務下線時仍有部分請求失敗。後續可以配合入口 log 或 trace,確認故障端點何時退出分流,以及健康檢查與重試如何運作。
這次測的是 API Gateway 到服務的路徑,以及 A 站的一個服務下線。外部 DMZ、機房故障與 DNS/GSLB 切換,要各自安排驗證;詳細測試方式留到後面的 k6 文章。
整理雙站架構時,我會先畫出實際流量路徑,再標示每一層的健康判斷與切換責任。這樣看到錯誤時,就比較清楚要從哪一段開始確認。


 iThome鐵人賽
 看影片追技術