
規格寫好了,背後的理由也交代了,接下來就能請 Claude 改程式嗎?
還有一件事:我認為該改的地方,真的找對了嗎?
有次為了確認一個跑在 Claude Code 上的排障 Agent 能不能幫忙查線上問題,我準備了幾個客服回報,以及自己查程式後寫下的預期答案。原本想拿這份「答案卷」驗收它,結果其中一題,它交回來的結論跟我不同。如果照我的答案往下開發,很可能修錯地方。
照我的答案評分,它應該拿零分。可是沿著它提供的位置查下去,我最後在答案卷上寫的是:
初版答案卷在此項寫錯了。Agent 正確,初版答案卷錯誤,以下為更正後內容。
遇到這種分歧,到底該相信誰?我後來改的,是先把差異變成可以查證的問題。我的答案,也要一起接受檢查。
這也決定了開發要從哪裡動手。若把錯的呼叫路徑交給 Claude,它可能很快修好一段與報表無關的程式。這篇先把缺陷的位置與驗收依據查清楚,尚未執行修補。
這次問題來自薪資系統:下個月才生效的扶養親屬,被算進了這個月。計薪結果錯,下載的報表人數也錯。
不用先懂薪資規則。這題的關鍵是:兩個地方出現相似症狀,我以為它們共用了同一段程式。
計薪端的日期邊界確實有問題。計算期間的結束點多包含了次月第一天,讓原本不該納入的資料進來。至於報表,我認為它也使用那支有日期條件的查詢,因此把預期答案寫成「往呼叫端追」。
Claude 卻指出:報表走的是另一支查詢,根本沒有日期過濾。
這時候不用先爭論誰比較懂系統。我們的分歧可以縮成一句話:報表入口,到底呼叫哪一支查詢?
Claude 交回的分析附了入口與呼叫位置。我照著引用追,看到報表入口呼叫另一支列表查詢。它的 WHERE 只有公司、員工與薪資群組;生效日出現在 SELECT 裡,卻沒有參與過濾。後面的 LINQ 計數也沒檢查日期。
兩條路徑共用資料表,卻沒有共用那段過濾邏輯。修好計薪端的日期邊界,不會讓報表一起變正確。
| 問題 | 我的原判斷 | 查證後 |
|---|---|---|
| 計薪結果錯 | 日期邊界多算一天 | 這部分判斷成立 |
| 報表人數錯 | 與計薪端共用過濾邏輯,往呼叫端追 | 另一條路徑沒有日期過濾 |
| 如何修正 | 把問題當成共用路徑追查 | 兩處分開確認、分開修 |
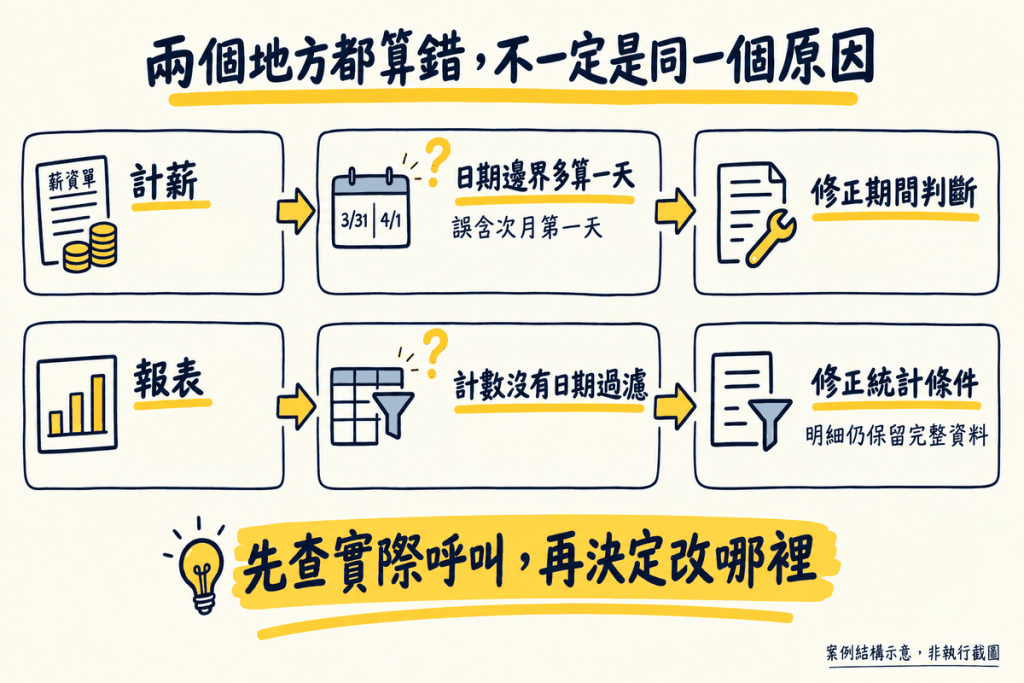
依案例結構重繪,非執行截圖;兩個症狀相似,不代表共用同一個原因。
還有一個不能漏的條件:報表明細原本就需要列出未生效與已失效的親屬。若直接在列表查詢加日期過濾,人數可能對了,明細卻少了資料。要處理的是統計條件,不能順手刪掉明細。
用 C# 偽碼表達:
var detailRows = LoadDetailRows(); // 明細保留完整資料
var count = detailRows.Count(r => IsValidFor(r, period)); // 統計才判斷期間
這兩行只標出「明細」與「統計」的範圍不同;IsValidFor 的條件要依確認過的報表規則寫,不是已驗證的修復。
這次讓我改答案的,是實際呼叫鏈與需求條件對得起來。單看「報表沒有日期過濾」這句結論,還不夠。
這是作者真實工作中的更正經驗,已隱去客戶、金額與內部名稱,本篇也沒有重新執行當時的商業程式。當時的 Agent 跑在 Claude Code 上,除了 Grep 還接了程式碼索引工具;後面用教學示範 repo 重跑時只開 Read、Grep、Glob,是為了讓核對程式能對回工具回傳。找位置的工具可以換,只要回傳帶檔名與行號,這套核對就成立:先找檔案,再讀入口與被呼叫的方法,最後把結論連回引用位置。
這裡要分開三件事:
| 檢查 | 能回答什麼 | 不能直接推出什麼 |
|---|---|---|
| 引用的位置存在,對應內容出現在工具回傳 | 這份引用有可核對的來源 | Claude 一定理解正確 |
| 入口、查詢與計數支持它的推論 | 這次差異有理由讓我更正答案 | 修改程式後一定符合需求 |
| 修正後重現原問題,再跑驗收與回歸 | 修法在所驗情境下是否有效 | 整個系統都沒有問題 |
本篇做到的是覆核分析、更正答案;沒有重跑歷史商業程式,也沒有宣稱修復通過。
如果 Claude 只交結論,沒有足以核對的依據,我不會因為它講得肯定就改答案。但這也不代表我的答案因此成立。證據不足時,差異先留下來待查,不急著判任何一方贏。
我保留原判斷,補上更正理由,也把查證結果整理成後續開發要注意的範圍。報表那題的評分依據跟著更正,相關舊評分仍需重新檢查。
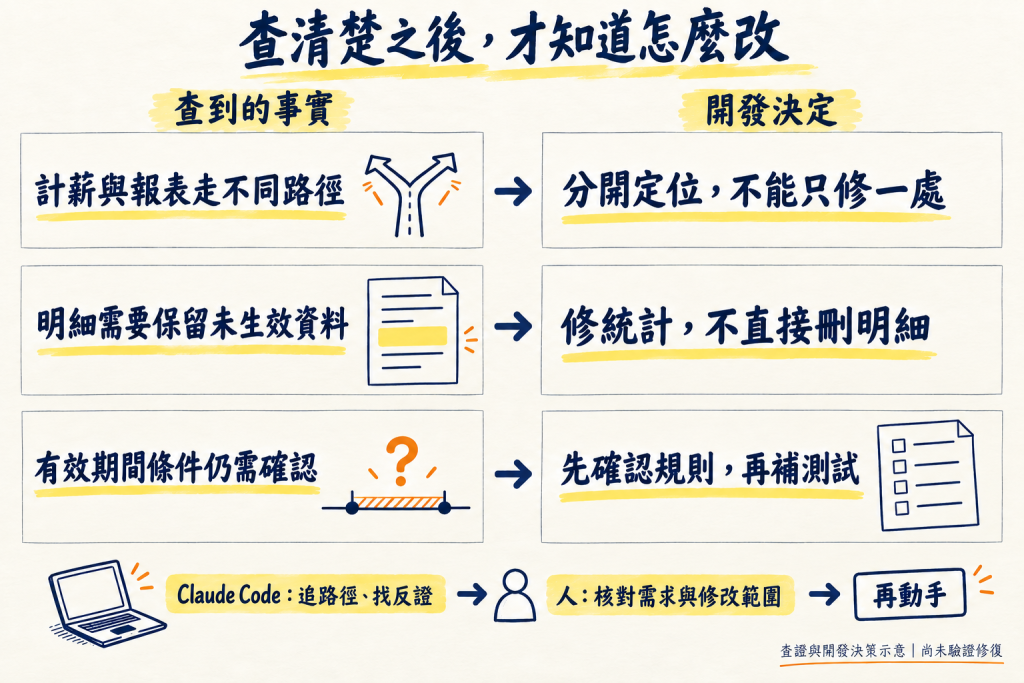
查證與開發決策示意,非執行紀錄。這次尚未執行修補與回歸,完成的是分析,還不能宣布修好。原先懷疑的共用查詢也不能順手修改。
讀程式能幫我確認「現在怎麼做」;「應該怎麼做」,仍須回到需求。 查到某段程式沒有過濾日期,不代表可以立刻加條件,還得先確認這段輸出原本要提供什麼。
這也是技術管理者要承擔的事:我訂了驗收標準,仍要讓執行者有機會提出反證。否則再好的審查流程,都可能只是在要求大家符合我寫錯的答案。
回頭看,我用的方法其實跟大家教的一樣:不讓 Claude 看到我的答案、它錯了就把規則寫下來、找一個乾淨 context 的 reviewer 去推翻結果而不是讓做事的自己打分。這套循環守的是 AI 那一側。這次答案卷錯了,我才看見循環少了半邊:我的判斷一直是量尺,從來不在被驗的範圍內。出考卷的人同時當評審,偏誤只是換了個宿主。
更正紀錄因此要同時留給人和 Claude:哪個判斷被推翻、修改範圍如何改變、哪些需求仍待確認。下一個開發動作才不會繼續沿用錯的前提。
原始商業程式不能公開,我另外用七個 C# 檔重建這個結構:報表走沒有日期過濾的列表查詢;計薪端走另一支有日期條件的查詢。這個 repo 只供唯讀分析,沒有編譯,也不是原系統的修復驗證。
我保留一份故意寫錯的答案卷 v1,但沒有提供給 Claude。給它的是症狀與查核問題,要求每個結論附上實際讀到的檔案路徑與行號,沒讀到就說沒讀到。
runner 使用 claude -p --tools Read,Grep,Glob。這個旗標是從它的工具表拿掉 Write、Edit、Bash,不是在提示裡叫它別改;「先不要修改程式」因此不靠自律。三次實跑的結論一致:報表沒有走我原先以為的那支查詢。關鍵入口如下:
Reports/DependentReportController.cs:20
   19|         {
>  20|             var rows = _repo.ListForPayrollGroup(companyId, employeeId, payrollGroupId);
   21|             var total = _count.Count(rows);
第 20 行讓我們知道要追的是 ListForPayrollGroup,再往下查它的過濾條件,以及第 21 行的計數實作。只看到方法名稱,還不能完成整個判斷。
Read 與 Grep 的工具回傳本來就帶檔案位置與行號,--output-format stream-json --verbose 會把每筆回傳原文留在 trace 裡,因此可以拿來核對 Claude 最後寫出的引用;聊天視窗貼結論,沒有這一層。引用仍可能寫錯,所以我用 check_citations.py 逐筆檢查,而不是看到行號就接受。核對三項:檔案是否存在、行號是否在範圍內、該位置是否出現在 trace 的 Read 或 Grep 工具回傳。它檢查引用來源,不會自動證明推論正確。
| 既有實跑 | 交付結果 | 引用來源檢查 |
|---|---|---|
| 有工具,三次 | 都指出報表與計薪端不共用過濾邏輯 | 13/13、11/11、13/13 通過 |
無工具(--tools ""),同提示兩次 |
有回覆、exit code 0,但沒有 JSON 或引用 | 沒有可驗證的交付 |
| 無工具,另改提示要求猜測,兩次 | JSON 完整,結論方向大致正確 | 共 20 筆引用,0 筆通過 |
最後一組刻意改了提示,要求它在不能讀檔時提供最佳猜測,用來測試核對能否抓出無依據引用,不是一般使用下的幻覺率。它甚至註明行號是推測,但仍提供了不存在的路徑或超出檔案範圍的行號。
即使這次猜對,沒有查證依據,我仍然無法接受這份診斷。 光比結論,猜的那份也可能得分;把來源與推論分開檢查,才看得到差別。
這組小實驗支持的是:引用來源可以檢查,而且檢查能抓出這些刻意設計的壞引用。三次結果一致不代表大型系統也有同樣表現,更不能只靠行號存在就接受根因。
不一定要正式建一套考卷。下次 Claude 的分析與你的判斷不同,可以先這樣做:
還有一個我後來才想到的動作:盲測跑完,另開一個乾淨 session,把我的答案卷當成待審的 PR 丟給它,叫它找每一題的反證。兩個 session 互不見面,一個測它,一個測我。
可以直接貼給 Claude Code:
我目前認為:[原判斷]。
你提出的是:[不同判斷]。
請先不要修改程式,從實際入口追查這個差異。
每個結論附檔案路徑、行號與支持它的程式內容。
區分已讀到的事實、推論,以及仍需確認的需求。
找不到依據就列為未確認,不要補猜測的引用。
這是供讀者使用的新操作範例,不是前面歷史實跑的原提示。互動模式下按 Shift+Tab 進 plan mode,或用 claude --permission-mode plan 啟動,Claude 只能讀檔回答、不能改,等於把「先不要修改程式」交給工具而不是提示。跑完仍要由你核對證據。
這段提示如果在幾次不同任務裡都用得上,我會把共通原則整理進 CLAUDE.md:遇到分歧先查依據,分開事實、推論與未知,不要為了符合答案而修改結論。當次的問題與判斷留在任務裡,檔案只留下下次仍適用的做法。
寫進檔案後,我還會另開 session,確認規則有載入,再換一個案例檢查:我的答案錯時,它能不能提出反證?我的答案對時,會不會硬找問題?資料不足時,是否願意保留待查?這是後續重用的做法,本文尚未驗證這段規則放進 CLAUDE.md 後的效果。
這次更正答案,下次保留查證的方法。
Day 8 附件公開後,可以在 lab 目錄執行以下指令,先用保存的材料練習:
python check_citations.py r1 r2 r3 guess-1 guess-2
這個指令讀取保存的 trace 與教學示範 repo,不呼叫模型,也不修改程式。你會看到正常組的引用對應內容,以及猜測組的路徑或行號錯誤。接著挑一個通過的引用,往下追呼叫鏈,自己判斷它是否足以推翻答案卷 v1。
最後留一筆簡短更正即可:原判斷、反證位置與版本、修訂理由、受影響的驗收項目。保留這些,下次接手的人才能理解你為什麼改答案。
原本我在驗收 Claude,最後被修正的卻是自己的答案。幸好這個分歧在修改程式之前被查了出來。
下次遇到類似問題,我可以先請 Claude Code 幫忙:
Claude 負責把可查的依據攤開;我仍要核對推論,確認需求,決定這次接受哪些修改。找不到依據的地方,就先留下來,不能讓猜測直接變成規格。Claude Code 不只可以幫我把程式寫出來,也可以在動手之前,幫我發現自己想錯了哪裡。
參考資料:
本文實作說明
notools-1、notools-2 保持提示但移除工具(--tools ""),未交回有效 JSON;guess-1、guess-2 同時改用要求猜測的提示,共 20 筆引用皆未通過檔案與行號檢查。這是核對機制的測試,不是一般使用的錯誤率。官方文件
--tools、--permission-mode plan、--output-format stream-json。另有 --json-schema 可強制輸出結構,本篇未用;它能逼出 JSON,逼不出有依據的引用。借鏡
實作材料
check_citations.py。閱讀既有紀錄不需呼叫模型;重新執行 Claude runner 會消耗用量,輸出不保證相同。

 iThome鐵人賽
 看影片追技術