

Day 04 列出的問題中,有一條是「如何規模化取得每支相機的內部光學參數 (intrinsics)?」,今天就來講一下。
得來速計時系統的第一步,是把相機畫面裡的車子對應回真實世界車道上的某個位置:這台車現在排在第幾台?前保桿有沒有越過點餐窗口那條線?從進入車道到領餐總共花了幾秒?只要牽涉到「畫面上的像素」和「地面上的公尺」之間的換算,就一定繞不開相機校準 (Camera Calibration)。相機校準分成兩部分,單相機校準 (Single Camera Calibration) 以取得內部參數 (Intrinsics),以及多相機校準 (Multi-camera Calibration) 以取得外部參數 (Extrinsics)。
相機校準就是解出一組能描述「3D 世界如何被投影成 2D 影像」的參數,這組參數分成內部和外部兩類:
K (OpenCV 文件裡講的 Camera Matrix 就是指它) 加上變形係數 (Distortion Coefficients),描述的是「這支相機自己」的光學特性,相機不管搬到哪裡都不會變[R|t],R 是旋轉矩陣 (rotation matrix)、t 是位移向量 (translation vector),描述的是相機相對於世界座標原點的鏡頭指向和位置,只要相機被移動就會改變所以「相機相對於店內世界座標系」的外部參數,要等相機鎖上店面的牆、固定不動之後才解得出來,這是之後多相機校準那一天的主題。今天要談的內部參數則和安裝位置無關,出貨前就能在產線上量完。等一下會看到,單相機校準的過程中其實也會順手解出外部參數,但那是相機相對於「手上那張棋盤格」的位置,跟店裡的世界座標系是兩回事。
即使是同一條產線、同一批次、同一型號的數位相機,每一支之間仍然有製造與組裝上的個體差異 (公差),會直接影響影像的輸出。校準要量的就是下面四項 — 前兩項是鏡頭的光學變形,同型號之間量級接近但係數仍有差異;後兩項則直接受組裝精度影響:
fx, fy:鏡頭焦距除以感光元件的像素間距,所以單位是 pixel。鏡頭本身的焦距公差,加上鏡頭鎖進機構時與感光元件的距離誤差,都會讓這個值在同型號之間出現差異cx, cy,單位也是 pixel如果這些公差大到會影響最終的定位與計時結果,那就只能每一支相機都個別校準、各自算出自己的內部參數。早期我們還不確定公差的影響有多大,只能先設計一套能規模化校準上千支相機的流程;後來產品在客戶端上線、累積了實際數據,才確認同一批相機的個體公差對計時結果的影響可以忽略不計。所以現在的做法改成每一批抽幾支校準、整批共用同一組參數,不必每一支都跑一遍。不過下面介紹的流程還是以「單支相機」為單位描述,因為不管是抽驗還是整批重校,跑的都是同一套腳本。
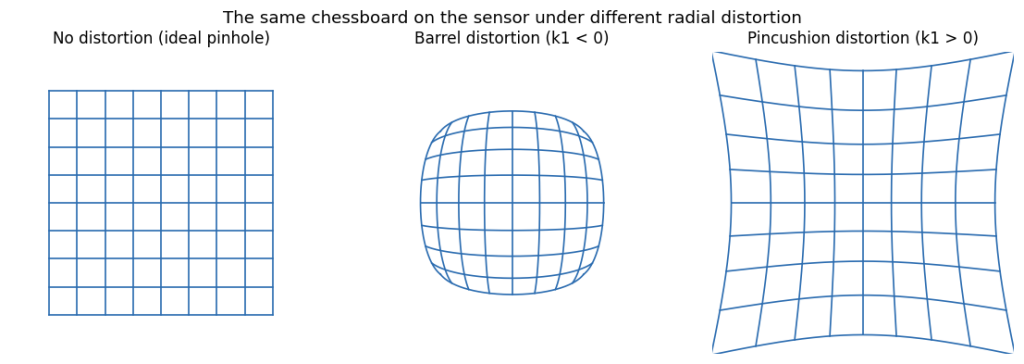
Day 04 提過我們刻意挑 HFoV 廣一點的相機以減少相機數量,代價就是桶狀變形也跟著明顯,不校準的話畫面邊緣的車子位置會差很多。
單相機校準 (Single Camera Calibration) 的意思就是:只需要這一支相機自己,加上一張尺寸已知的棋盤格,就能把上面這些係數全部解出來,不需要其他相機、也不需要任何安裝現場的場景資訊。
先看 Distortion Coefficients。OpenCV 用的變形模型是把「理想針孔相機該投到的位置 (x, y)」修正成「實際投到的位置」。要注意 (x, y) 是正規化座標 (3D 點除以深度、還沒乘上 K 之前的值),不是像素座標,r 則是這個點到光軸的距離,也就是 r² = x² + y²:
Radial Distortion:
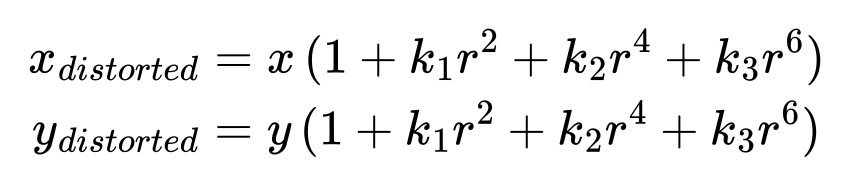
Tangential Distortion:
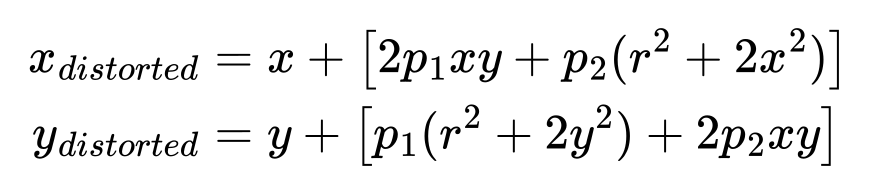
把 (x, y) 修正成 (x_distorted, y_distorted) 之後再乘上 K,才是影像上實際的像素座標。標準模型下要求解的就是 (k1, k2, p1, p2, k3) 這五個係數。不過 OpenCV 的 calibrateCamera() 在這裡給了很大的彈性:可以用 CALIB_RATIONAL_MODEL 把模型擴充到 k4, k5, k6 (分母項,對廣角鏡頭的邊緣擬合得比較好),預設這些高階項都是零;也可以用 CALIB_ZERO_TANGENT_DIST 直接假設鏡片和感光元件完全平行,不去解 p1, p2。
我們某一批共 48 支相機最後採用的組合是:
flags = (cv.CALIB_ZERO_TANGENT_DIST | cv.CALIB_RATIONAL_MODEL
         | cv.CALIB_FIX_K5 | cv.CALIB_FIX_K6)
翻成白話就是:不解切向變形 (工業相機的組裝精度夠好,硬解只會把雜訊解進去)、打開 rational model 拿到 k4 來處理廣角鏡頭邊緣,但把 k5, k6 固定為零避免過度擬合 (在沒有設 CALIB_USE_INTRINSIC_GUESS 的情況下,CALIB_FIX_K5/K6 會把對應係數直接固定為 0)。這組 flags 沒有理論推導的成分,是拿同一批影片反覆試出來、測試資料上的誤差最低的那一組,後面會講怎麼量。
再看 Intrinsic Matrix,就是把 fx, fy, cx, cy 四個值排成一個 3x3 矩陣:
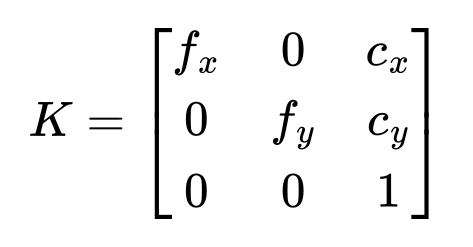
把 K 和 [R|t] 串成投影矩陣 (Projection Matrix) P = K[R|t],就是「世界座標系上一個 3D 點,會落在照片上哪一個 2D 像素」的完整公式:
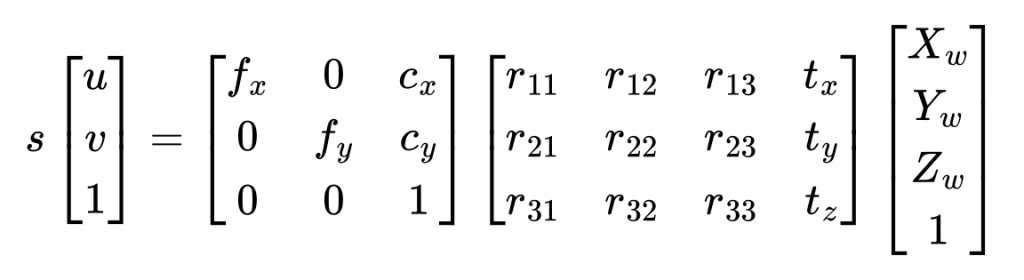
公式左邊的 s 是比例係數,等於這個點在相機座標系下的深度:3D 投影成 2D 之後,深度資訊全被壓縮在這個數字裡。
反過來要從照片推回真實世界就沒那麼直接:一個像素反投影出去只是一條射線,s 未知,必須再補一個約束才解得出來。得來速的情境有一個天然的約束 — 車子都在地上跑,所以可以假設 Z_w = 0,把上面的公式退化成地面與影像之間的單應性矩陣 (Homography),再用地面上已知的實際距離 (例如車道寬度、標線間距) 把尺度定下來。得來速計時要算的「這台車距離點餐窗口還有幾公尺」,本質上就是這個換算。而任何一項內部參數校歪了,這個換算就會跟著歪,多相機之間的結果也對不起來。
用張正友在 1998 年提出的 張氏校準法:拿一張格子尺寸已知的平面棋盤格,在相機前面以不同的位置和角度拍很多張,因為棋盤格上每個角點 (corner) 的相對座標是已知的,就能反推出相機的內部參數和每一張照片各自的外部參數。OpenCV 幾乎把相關的功能都寫好了,官方教學 用三十行程式碼就能跑出結果。
那問題來了:教學都寫好了,為什麼還需要一份 SOP?因為教學裡的「拍十幾張棋盤格照片」這件事,在產線上是不可控的。不同的操作人員拍出來的照片,棋盤格的分布位置、傾斜角度、涵蓋範圍差異極大,同一支相機給兩個人校準,可能一個算出來邊緣誤差 0.3 pixel、另一個 1.5 pixel。我們要的是一個跟操作人員無關的流程。
整個流程分成錄影和後處理兩段。錄影在硬體廠商的產線上做;後處理則是四支 Python 腳本接力:從影片抽出角點、畫出角點分布圖、跑 100 次抽樣校準、挑出最佳結果並彙整,每一支都能批次處理整批相機。
教學裡「拍十幾張照片」的步驟,在產線上換成用我們提供的錄影輔助工具錄一段影片。工具的畫面上會疊九個點 (四個角落、四邊中點、正中央),並即時偵測棋盤格的位置:操作人員手持棋盤格在鏡頭前移動,棋盤格「掃過」哪個點,那個點就消失;九個點都清光,影片就自動存成一支 mp4,檔名是這支相機的 MAC Address,後面所有的中間產物都沿用這個命名。
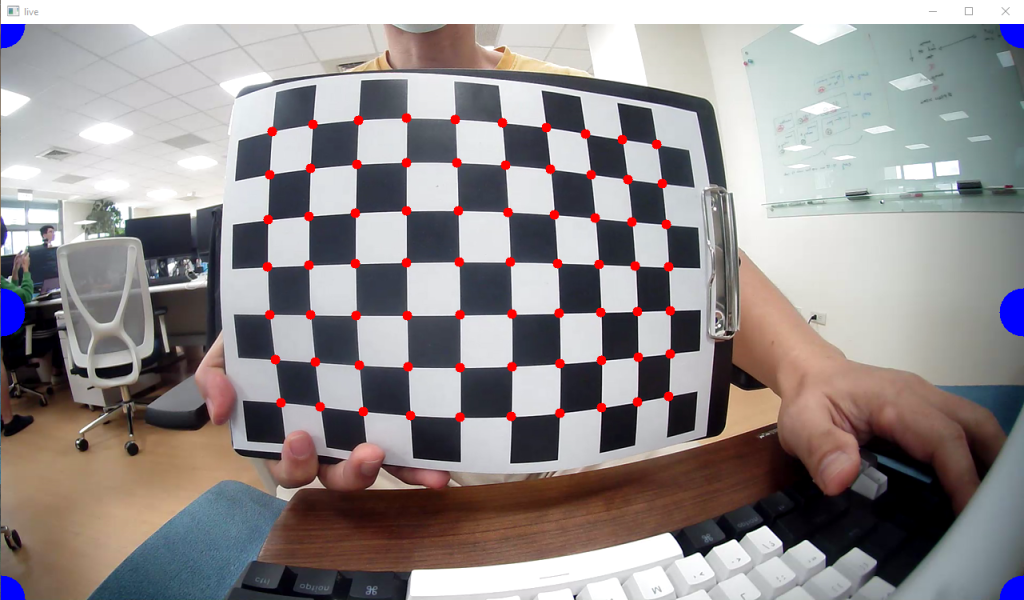
這個設計的目的是用九個點強制操作人員把棋盤格帶到畫面的每一個角落。變形係數的估計特別依賴畫面邊緣的樣本 — 變形項是隨 r 的高次方成長的,畫面中央附近幾乎看不出差別,只有靠近邊角的角點才能提供足夠的資訊。可是人的本能就是把東西擺在畫面中央,如果沒有這種強制機制,收到的影片八成都是棋盤格在中間晃來晃去,邊緣完全沒有樣本。
拿到 mp4 之後,第一支腳本逐幀跑 cv.findChessboardCorners(),有找到棋盤格的 frame 就把角點座標收進一個 list,整支影片跑完後連同 frame 編號與影像尺寸一起存成一個 pickle 檔:
import pickle
from collections import namedtuple

import cv2 as cv

Frame = namedtuple("Frame", "idx corners")

PATTERN = (9, 6)  # 棋盤格內部角點數 (寬 x 高)
MAC = "A1B2C3D4E5F6"  # 這支相機的 MAC Address,所有中間產物都沿用
cap = cv.VideoCapture(f"{MAC}.mp4")
# calibrateCamera() 要的是 (w, h),先從 cap 問出來,不要依賴迴圈裡的變數
img_size = (int(cap.get(cv.CAP_PROP_FRAME_WIDTH)),
            int(cap.get(cv.CAP_PROP_FRAME_HEIGHT)))
frames = []       # 每個元素是 Frame(idx, corners),corners 形狀為 (54, 1, 2)
i = 0
while True:
    ok, frame = cap.read()
    if not ok:
        break
    gray = cv.cvtColor(frame, cv.COLOR_BGR2GRAY)
    found, corners = cv.findChessboardCorners(gray, PATTERN)
    if found:
        # 把角點精修到 sub-pixel,這一步對最後的誤差影響很大
        corners = cv.cornerSubPix(
            gray, corners, (11, 11), (-1, -1),
            (cv.TERM_CRITERIA_EPS + cv.TERM_CRITERIA_MAX_ITER, 30, 0.001))
        frames.append(Frame(i, corners))
    i += 1

with open(f"{MAC}.corners.pickle", "wb") as f:
    pickle.dump({"img_size": img_size, "frames": frames}, f)
一支一兩分鐘的 30fps 影片總共兩三千個 frame,其中通常有上千個能成功找到棋盤格,全部收在同一個 pickle 檔裡,後面的腳本只要讀這一個檔案就好。
第二支腳本讀取這個 pickle 檔,把所有 frame 的所有角點畫成一張 Scatter Plot:
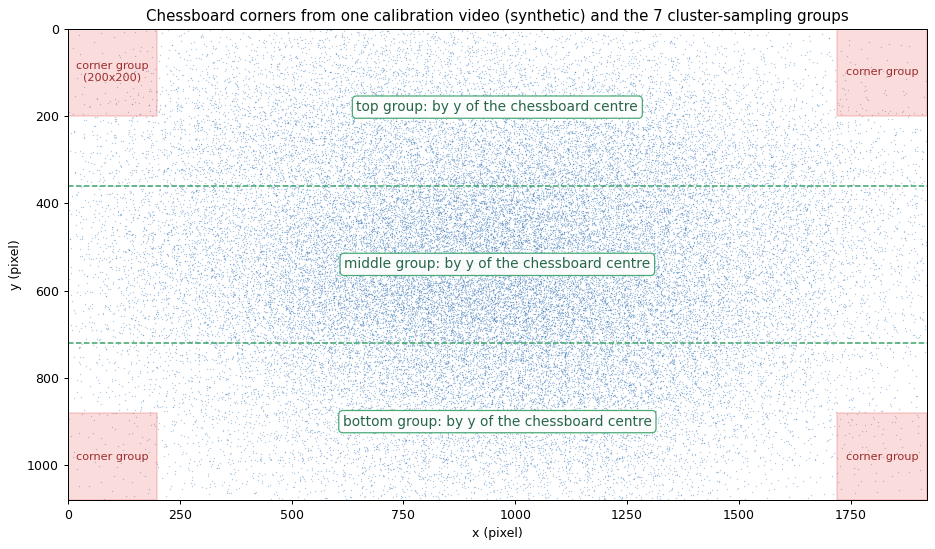
每一支相機都會產出這樣一張圖,可用肉眼檢查取樣是否均勻。
這張圖要看的是兩件事:四個角落的 200x200 區域內有沒有樣本,以及上、中、下三個區帶是否都有覆蓋 — 圖上的紅框和綠線就是下一節 cluster sampling 的分組邊界。錄影工具雖然強制掃過九個點,但「錄影時掃過」不保證「事後偵測得到」:棋盤格傾斜角度太大或移動太快 (動態模糊) 的 frame,角點偵測是會失敗的。某個角落整片空白,代表那個區域沒有可用的樣本,這支影片就得退回重錄,不必等校準跑完才從誤差數字發現異常。
上千個 frame 不可能全部丟進 calibrateCamera(),而且棋盤格停在相近位置的那些 frame 等於重複樣本,再多也沒幫助。OpenCV 教學的做法是「挑個十幾二十張」,但要挑哪幾張?前面說過,每個操作人員移動棋盤格的習慣不同,有人偏中間、有人偏邊緣,如果直接隨機抽,抽到的樣本分布就會繼承這個偏誤。更麻煩的是,錄影輔助工具會要求把畫面上九個點全部清掉,而有些相機的邊角特別難清,操作人員會在那裡反覆嘗試,結果反而累積出一大堆邊角的樣本。也就是說,不管操作習慣偏中間還是偏邊角,把全部 frame 一視同仁地隨機抽,抽出來的分布都會歪掉。
我們的做法是:
random.shuffle() 之後對切,一半當測試資料,另一半當訓練資料。測試資料完全不參與校準,只用來評估結果好不好。這個切分的 seed 一定要固定下來,否則最後一支腳本「用同一個 seed 重跑一次抽樣」時訓練集會跟著變,重現不出同一組參數。calibrateCamera()。四個角落組本來就是最稀有的樣本,某一組湊不滿 10 個時就整組取用,所以實際數量有可能少於 70。calibrateCamera() 自己回傳的 ret,只反映那 70 個訓練用 frame 的擬合狀況,留著當參考欄位。def calibrate_with_seed(frames, seed, img_size, flags):
random.seed(seed)
# 某一組湊不滿 10 個就整組取用,不然 random.sample() 會直接拋 ValueError
sample = [f for group in cluster(frames)
for f in random.sample(group, min(10, len(group)))]
# BOARD_3D 是棋盤格角點的已知 3D 座標:(54, 3) 陣列,Z 全為 0、
# 以實際格子邊長為間距。所有 frame 共用同一份
obj_pts = [BOARD_3D] * len(sample)
img_pts = [f.corners for f in sample]
ret, mtx, dist, rvecs, tvecs = cv.calibrateCamera(
obj_pts, img_pts, img_size, None, None, flags=flags)
return ret, mtx, dist
def reprojection_mae(frames, mtx, dist):
errs = []
for f in frames:
# 用測試資料自己的 corners 解出這一張的外部參數,再投影回去比對
_, rvec, tvec = cv.solvePnP(BOARD_3D, f.corners, mtx, dist)
proj, _ = cv.projectPoints(BOARD_3D, rvec, tvec, mtx, dist)
# 取每個角點的歐氏距離再平均,不是逐座標軸取絕對值
errs.append(np.linalg.norm(proj - f.corners, axis=-1).mean())
return float(np.mean(errs))
rows = []
for seed in range(100):
ret, mtx, dist = calibrate_with_seed(train, seed, IMG_SIZE, flags)
rows.append({
"seed": seed,
"MAE": reprojection_mae(train, mtx, dist),
"TEST_MAE": reprojection_mae(test, mtx, dist),
"RMSE": ret, # calibrateCamera() 自己算的訓練誤差
"fx": mtx[0, 0], "fy": mtx[1, 1], "cx": mtx[0, 2], "cy": mtx[1, 2],
**{f"k{i+1}": v for i, v in enumerate(dist.ravel()[[0, 1, 4, 5]])},
})
pd.DataFrame(rows).to_csv(f"{MAC}.csv", index=False)
為什麼要分訓練和測試?因為 calibrateCamera() 回傳的誤差是拿校準時用的那些照片自己算的,就跟用訓練資料評估模型一樣,永遠會好看。另外它回傳的 ret 是所有角點歐氏距離的 RMS,我們自己算的 MAE 取的是平均,RMS 一定大於或等於平均,所以這兩個數字不能直接對照,只能各自跟自己比。真正該關心的是這組參數用在沒參與校準的 frame 上準不準,這才是相機裝到店裡之後會遇到的情境。有了 TEST_MAE,前面提到的 flags 組合要怎麼選也就有了客觀依據,哪一組 flags 的 TEST_MAE 最低就用哪一組,不用靠感覺。
不過這裡有兩個弱點要先交代清楚。第一,隨機對切出來的訓練和測試資料其實不完全獨立:影片是 30fps 錄的,相鄰 frame 幾乎是同一張圖,隨機打散之後測試集裡一定混進了訓練集某張的近複製品,所以 TEST_MAE 會比真正的泛化誤差樂觀一些。要切得乾淨一點,可以改成按時間分段 (前半訓練、後半測試),或先把連續 frame 併成一段、再以段為單位分配。第二,下一節會用 TEST_MAE 從 100 組候選裡挑最好的一組,那一刻測試資料的角色其實已經變成 validation set,被挑中的那組 TEST_MAE 也就帶有選擇偏誤。真要嚴謹就得切成訓練/驗證/測試三份,用驗證集挑 seed 和 flags、留測試集報告最終品質。我們當初沒有這樣做,因為這個數字的用途是「在同一支相機的 100 組候選之間排序」和「擋掉明顯錄壞的影片」,這兩件事對絕對值的偏誤不太敏感 — 但如果要拿 TEST_MAE 去對客戶宣稱精度,就必須補上這一刀。
最後一支腳本讀 csv,找到 TEST_MAE 最低那一筆的 seed,用同一個 seed 重跑一次抽樣和 calibrateCamera(),把 mtx、dist 連同 seed、TEST_MAE、MAE 一起存起來 (rvecs, tvecs 是那 70 張棋盤格各自的外部參數,出貨後用不到,就不留了)。整批相機跑完後,所有結果會以相機 MAC Address 為 key 彙整成一個 summary pickle 檔:
df = pd.read_csv(f"{MAC}.csv")
best = df.loc[df["TEST_MAE"].idxmin()]
_, mtx, dist = calibrate_with_seed(train, int(best.seed), IMG_SIZE, flags)

summary[MAC] = {
    "seed": int(best.seed), "TEST_MAE": best.TEST_MAE, "MAE": best.MAE,
    "mtx": mtx, "dist": dist,
}
with open("48cams_summary.pickle", "wb") as f:
    pickle.dump(summary, f)
這個以相機 MAC Address 為 key 的檔案就是整個流程的產出。之後 edge server 一連上相機、讀到 MAC Address,就能自動載入對應的內部參數,這也是 Day 04 那條「如何自動偵測並設定各種廠牌和型號的相機」得以成立的前提之一:相機參數是什麼,出貨前就已經知道了。前面提到現在改成整批共用一組參數,做法是把抽驗出來的那組參數寫進該批每一支相機的 MAC 底下,查表的介面不變,edge server 那一端完全不用改。
單相機校準的理論將近三十年前就成熟了,OpenCV 教學也早就寫好了,但要讓產線人員能正確地批次操作、每一支相機都校出一致的品質,中間的距離就是這篇文章:錄影輔助工具用九個點把「棋盤格掃過畫面每個角落」變成流程的一部分,cluster sampling 抹平操作習慣造成的取樣偏誤,訓練/測試對切加上固定 seed 的 100 次抽樣讓挑參數有客觀依據、結果也能重現。這套流程的產出只涵蓋內部參數,而 TEST_MAE 的兩個統計弱點也還在:拿來做批內排序和擋掉錄壞的影片已經夠用,要對外宣稱精度就得補上訓練/驗證/測試的三份切分。等相機出貨、裝到店裡固定好,下一步就是求解外部參數,把多支相機統一到同一個世界座標系上,那又是另一個故事了。
本系列由 Berry AI 工程團隊出品。更多工程實戰紀錄都在 Berry AI 技術部落格。


 iThome鐵人賽
 看影片追技術