
Day8 拆完 AGENTS.md 的載入規則,今天量它值多少。
pytest 是綠的,問題只有 check.py 看得到)。AGENTS.md。那份檔案寫了五條規則:驗收要跑 check.py、新增 endpoint 要改三處、錯誤要用 AppError、產生檔不能手改、不能有魔術數字。gpt-5.6-luna。| 任務 | 條件 | 成功 | 成本中位數 | tokens 中位數 | 工具呼叫 |
|---|---|---|---|---|---|
| T1 修分頁 bug | 有 AGENTS.md | 5/5 | $0.0023 | 15,731 | 8 |
| T1 修分頁 bug | 無 AGENTS.md | 5/5 | $0.0026 | 16,648 | 11 |
| T2 新增 endpoint | 有 AGENTS.md | 5/5 | $0.0077 | 70,762 | 29 |
| T2 新增 endpoint | 無 AGENTS.md | 5/5 | $0.0067 | 46,721 | 25 |
| T3 修 CI 檢查 | 有 AGENTS.md | 5/5 | $0.0031 | 28,569 | 14 |
| T3 修 CI 檢查 | 無 AGENTS.md | 5/5 | $0.0040 | 46,686 | 19 |
30 次執行,30 次成功。
這不是我想看到的結果,但它是資料。如果這系列只承諾「量成功率」,今天這篇就只能寫「沒有差異」然後收工——而那會錯過真正發生的事。
把每次執行有沒有跑過專案規定的驗收指令 scripts/check.py 攤開來看:
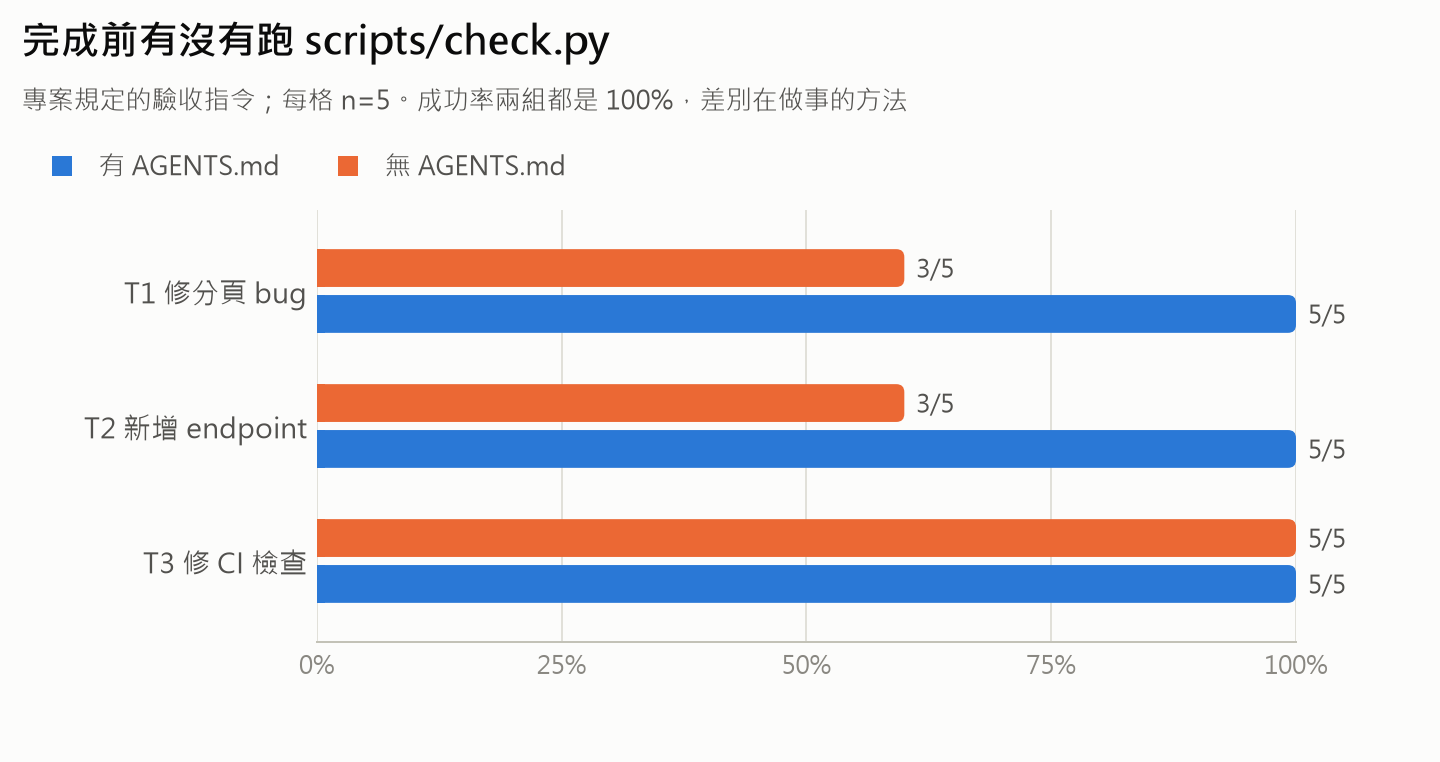
| 任務 | 有 AGENTS.md | 無 AGENTS.md |
|---|---|---|
| T1 修分頁 bug | 5/5 | 3/5 |
| T2 新增 endpoint | 5/5 | 3/5 |
| T3 修 CI 檢查 | 5/5 | 5/5 |
有 AGENTS.md 的 15 次執行,15 次都跑了驗收指令;沒有的話,T1 和 T2 各有 2 次直接交差。
那為什麼這 4 次「沒驗收」還是成功了?因為它們做對了。這正是這個實驗最該講清楚的一件事:
沒跑驗收 ≠ 失敗,但它是下一次會失敗的原因。
證據在校準那一輪就出現過:T4 拆常數任務、沒有 AGENTS.md 的那組,有一次執行只跑了 pytest(綠的)就回報完成,結果 import 排序沒過 ruff,判定失敗。它不是不會做,是不知道要驗到哪裡才算做完。
AGENTS.md 真正買到的東西,是把「什麼叫做完」講清楚。這在成功率上看不出來,要等到任務的驗收標準比較刁鑽時才會現形。
成本的部分要小心講。把每個任務的最小/中位/最大攤開:
| 任務 | 條件 | 成本範圍 |
|---|---|---|
| T2 新增 endpoint | 有 AGENTS.md | $0.0048 – $0.0088 |
| T2 新增 endpoint | 無 AGENTS.md | $0.0049 – $0.0087 |
| T3 修 CI 檢查 | 有 AGENTS.md | $0.0027 – $0.0035 |
| T3 修 CI 檢查 | 無 AGENTS.md | $0.0039 – $0.0056 |
更值得說的是:校準那一輪(n=3)跑出來的 T2,方向是反過來的——當時「沒有 AGENTS.md」比較貴(100K vs 75K tokens)。同一格條件,n=3 和 n=5 給出相反的結論。
這就是為什麼這系列從 Day1 就說要報分佈、不報平均。如果我只跑一次、或只看中位數,今天這篇可以寫成「AGENTS.md 省了 30% token」——完全站不住腳。
另一半的帳也要算。那份 AGENTS.md 有 1,145 個字元,被塞進 system prompt 之後,每一次模型呼叫的輸入固定多 354 個 token——五個任務量出來都是 354,一個不差(量法見 Day14)。
所以完整的結論是:
在這組任務上,
AGENTS.md每次請求多花 354 個 token,換到的是「一定會照規矩驗收」這個行為,以及一個任務(T3)上明確的 token 節省。它沒有讓 agent 變得更會寫程式。
AGENTS.md 防住什麼,得設計更刁鑽的驗收標準——校準時的 T4 就是一個例子。AGENTS.md 的那組 5 次都先讀了 README.md(裡面指向完整的驗收說明),其中 2 次再翻到 CONTRIBUTING.md,最後 5 次全部都跑了 check.py。換一個沒有這種線索的任務(例如 T1、T2),驗收率就掉到 3/5。AGENTS.md 的邊際價值,跟任務本身給了多少線索有關。
Day10 換一個把知識交給 agent 的方式:Skills。它跟 AGENTS.md 最大的差別是「不用的時候不用付錢」,但也多了一個新的失敗模式——模型可能根本不去讀它。


 iThome鐵人賽
 看影片追技術