
把「我覺得這樣比較好」換成「我量過,差多少,有多不確定」。
Day1 到 Day8 拆 harness 的構造,Day9 到 Day17 開始量,Day18 到 Day21 補上可觀測性,Day22 逼出 compaction、Day23–24 補上統計,Day25 到 Day28 換方向去量「限制 agent」的代價,Day29 回頭把記錄變成可以重算的資產。
今天把所有東西攤開:可以直接用的清單、完整資料、我做錯的事、以及沒能回答的問題。
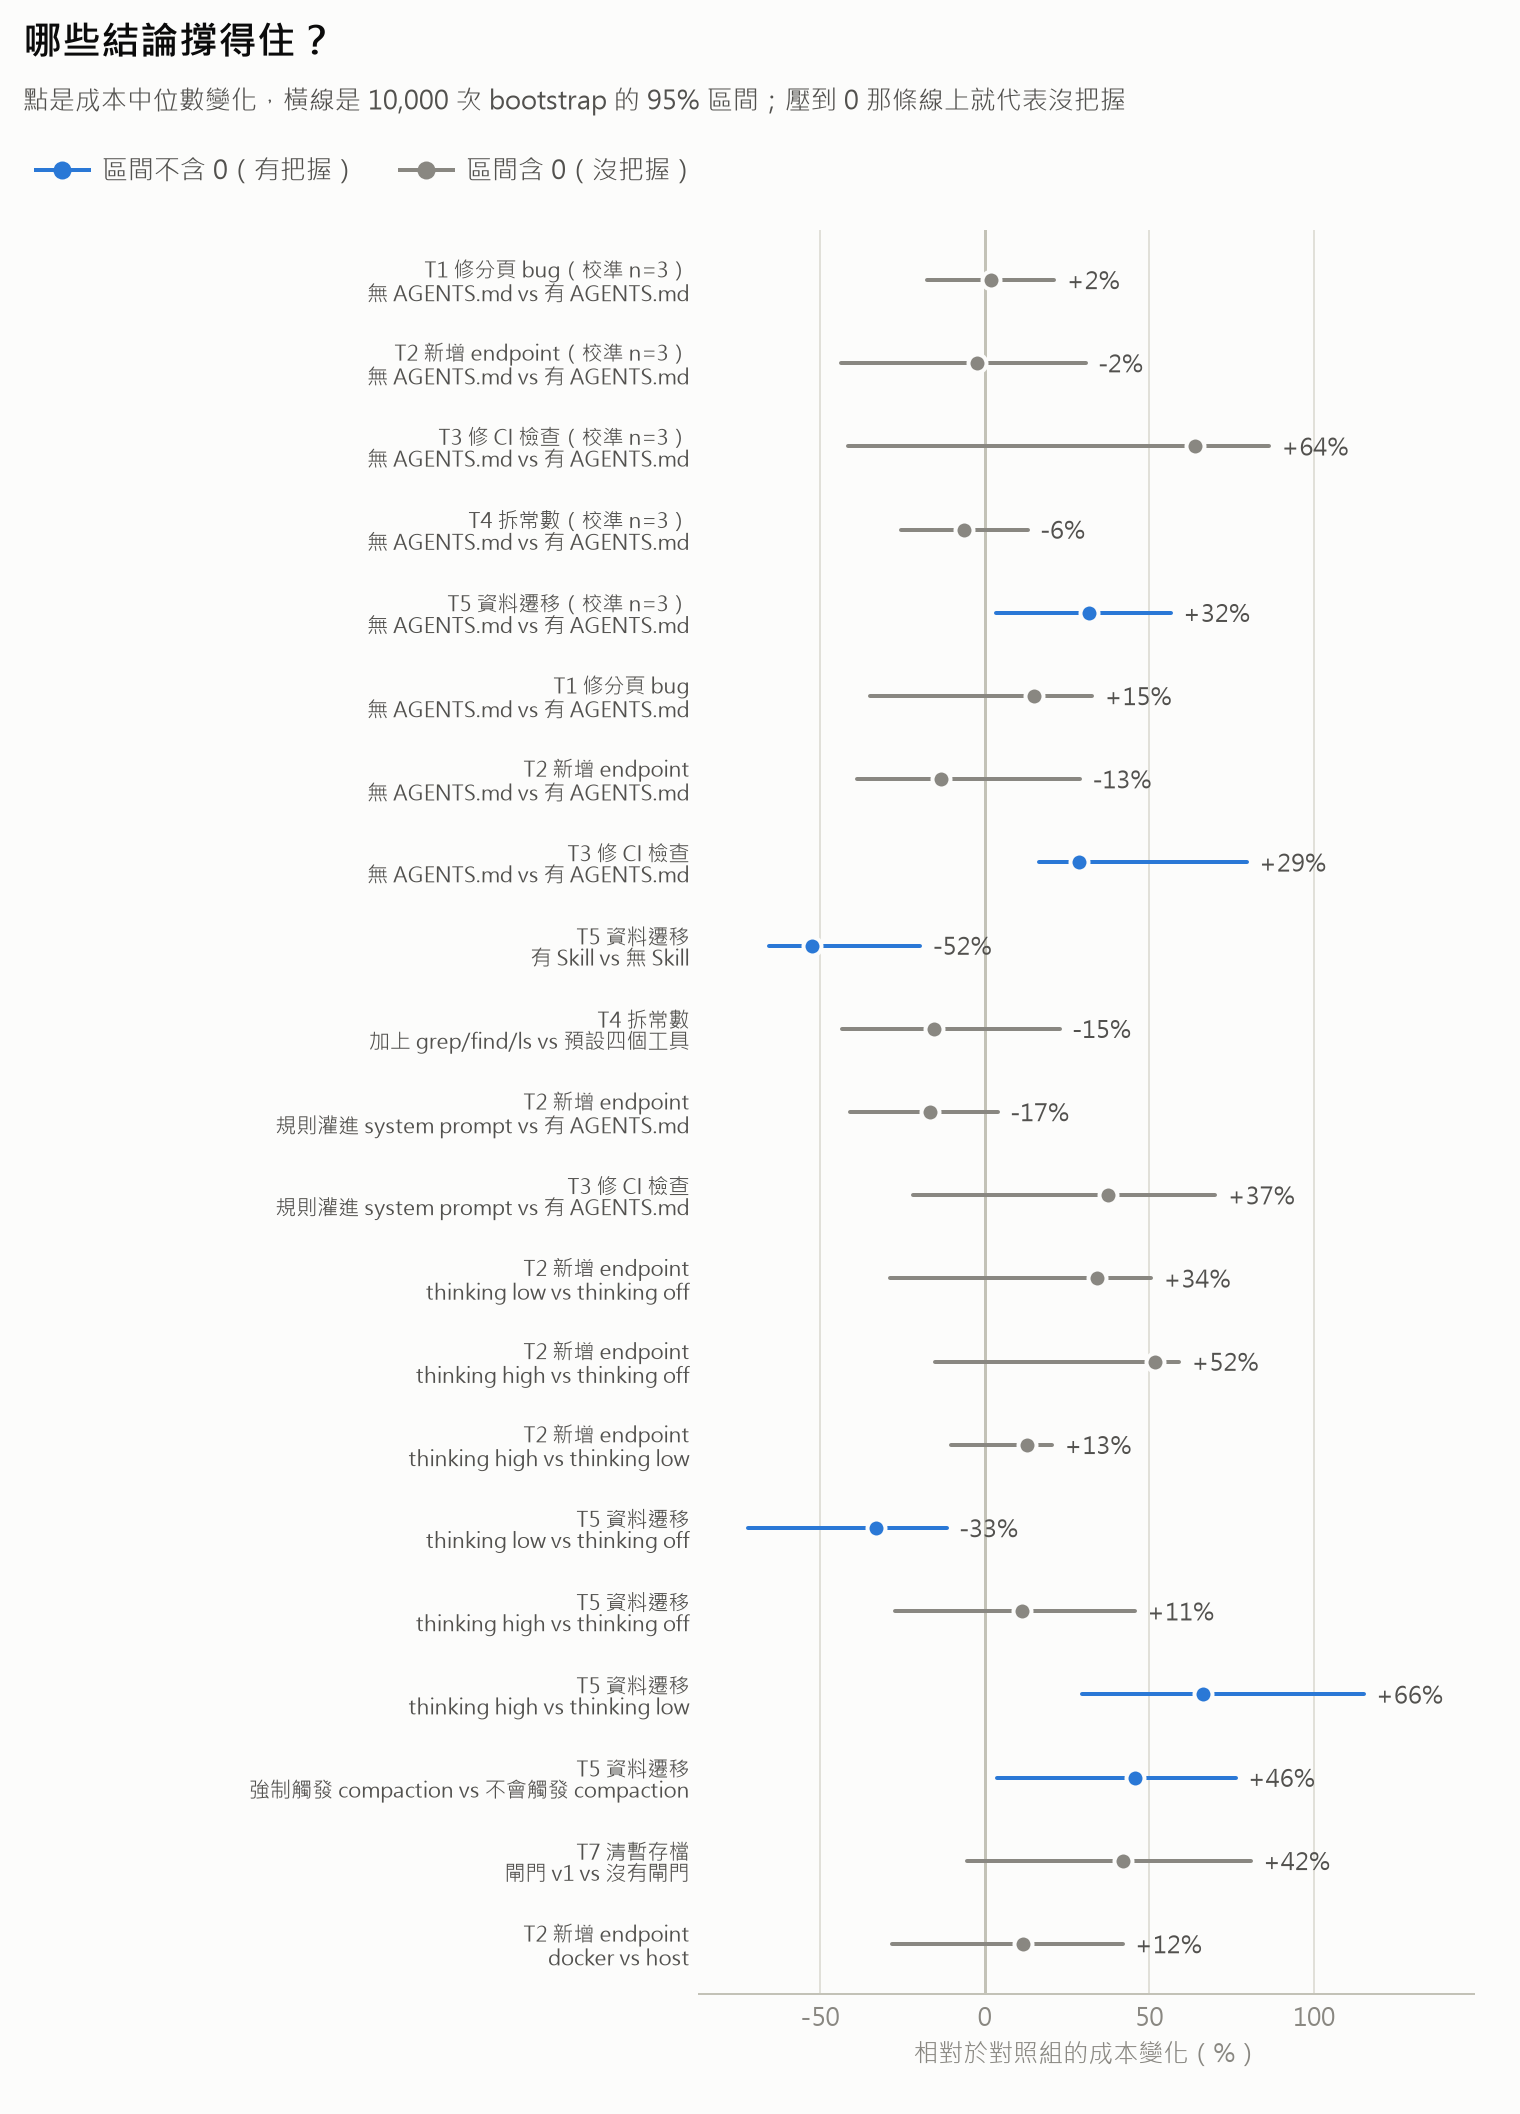
21 組比較裡,只有這 6 組的 95% 區間不含 0:
| 結論 | 數字 | 95% CI | 出處 |
|---|---|---|---|
| 把流程知識寫成 Skill,省一半成本 | −52.4% | −65.3% ~ −19.5% | Day11 |
| 流程型任務把 thinking 從 low 調到 high,貴 66% | +66.2% | +29.5% ~ +115.1% | Day17 |
| 流程型任務把 thinking 從 off 調到 low,省 33% | −33.0% | −71.7% ~ −11.5% | Day17 |
| 強制觸發 compaction,整體帳單多 46% | +45.7% | +3.9% ~ +76.2% | Day22 |
| 沒有 AGENTS.md,T3 這種「要自己找驗收方式」的任務貴 29% | +28.7% | +16.5% ~ +79.6% | Day9 |
| 校準組的 T5(n=3,擦邊) | +31.6% | +3.4% ~ +56.5% | Day9 |
如果你只想帶走一句話:
把「這個專案的流程」寫成 Skill,是這 30 天量到 CP 值最高的一件事。
它不給模型新知識,只是省掉它自己摸索流程的那幾輪——而那幾輪佔了一半的帳單。
這些比較的區間都含 0,成本上我不敢下結論,但它們改變了 agent 做事的方法,而且是可重現的觀察:
| 觀察 | 證據 | 出處 |
|---|---|---|
AGENTS.md 真正買到的是「照規矩驗收」 |
跑 check.py 的比例 5/5 vs 3/5 |
Day9 |
多給 grep/find/ls 沒有讓它更快 |
tokens 中位數 61,261 vs 60,664,agent 直接用 bash 繞路 | Day13 |
規則放 AGENTS.md 或灌進 system prompt,行為一樣 |
兩組成功率、工具序列都沒差;選哪個看規則「屬於誰」 | Day15 |
| thinking 不是單調的 | 規格明確的任務越想越貴;流程型任務中間最便宜 | Day17 |
| 容器隔離的執行期成本量不出來 | 成本 +11.6%、時間 +6.4%,區間都含 0 | Day28 |
這些是從原始碼、文件或單次量測直接得到的,沒有不確定性的問題:
| 事實 | 出處 |
|---|---|
Pi 預設只開 read/bash/edit/write 四個工具,system prompt 是工具開關的函式(2,198 字元 ≈ 550 token) |
Day12、Day14 |
| Skills 用 progressive disclosure:prompt 裡只放名字與描述,內容要模型自己去讀 | Day10 |
| 快取命中的 input 只要原價的十分之一——比 token 數不等於比成本 | Day14、Day28 |
| wall-clock 裡只有 39% 在等模型,14% 在跑工具,47% 是 harness 自己的開銷 | Day20 |
在 -p 一次性模式下,compaction 只發生在 agent_end 之後,摘要不會被這次執行用到 |
Day22 |
| session 檔是 append-only 的事件記錄,狀態是 fold 出來的,所以所有指標都能重算 | Day29 |
0.84.3 的 telemetry 是一份完整但沒接上的藍圖:契約、conformance suite 都在,AgentHarness 卻有約 20 個未實作操作 |
Day19 |
全部在 howisyour/my_first_pi_agent_project(MIT)。
| 實驗 | 執行次數 | 成功 | 花費 |
|---|---|---|---|
calib_luna 校準 |
30 | 29 | $0.1699 |
e09_agents_md |
30 | 30 | $0.1332 |
e11_skills |
10 | 10 | $0.0651 |
e13_search_tools |
10 | 10 | $0.0658 |
e15_system_prompt |
20 | 20 | $0.1070 |
e17_thinking |
30 | 30 | $0.2363 |
e22_compaction |
10 | 10 | $0.0908 |
e22b_compaction_threshold |
3 | 3 | $0.0303 |
e26_tool_gate |
10 | 7 | $0.0637 |
e26b_tool_gate_v2 |
5 | 5 | $0.0271 |
e28_sandbox |
10 | 10 | $0.0783 |
| 合計 | 168 | 164 | $1.07 |
附帶 168 份完整 session(6,129 筆事件、10 MB)、每次執行的 diff、以及所有圖表的產生程式。路徑、使用者名稱、主機名稱都已經過濾。
repo 導覽:
bench/fixtures/taskapp/   受測專案(64 個檔案、5 條專案慣例)
bench/tasks/              6 個任務,每個都有參考解與隱藏測試
bench/runner/             harness 無關的 runner(adapter / 判定 / 指標 / 重算)
bench/extensions/         Day25-26 的刪除閘門 v1、v2 與單元測試
lab/trace/                Day19-20 的 OTel adapter 與 trace 包裝
analysis/                 所有表格與圖表的產生程式
experiments/              設定檔、原始結果、圖
docker/Dockerfile         Day28 的容器
重現任何一組數字:
python -m bench.runner.cli run experiments/configs/e11_skills.json
python -m analysis.evals
不想花錢、只想驗算我貼出來的數字:
python -m bench.runner.recompute # 從存下來的 session 重算全部指標,0.3 秒
這一段我認為比上面的結論更有用。
1. 先做保護,才去驗證風險存不存在。
Day25 我花了一整天做刪除閘門,Day26 才發現沒有閘門的五次執行,agent 一次都沒有想刪那個受保護的目錄——它五次都先用 git ls-files 查過。順序反了。
2. 閘門不懂 shell,擋掉了正確的指令。
v1 把 rm -rf .cache tmp && git status && python check.py 整條擋掉,因為它把 && 後面的字都當成刪除目標。9 次攔截裡有 8 次是誤擋,成功率從 100% 掉到 40%。 修法不是憑想像補 regex,而是把 session 裡 agent 真的下過的指令抄出來當測資。
3. 帳單漏算了一整筆。
compaction 產生摘要那次模型呼叫的 usage 掛在 compaction 記錄上,不在 assistant 訊息裡,而我的指標只走 assistant 訊息。Day22 的結論因此從「+22%,沒把握」變成「+45.7%,有把握」。
4. 設計了一個測不到目標的實驗。
Day22 想測「agent 被摘要之後會不會失憶」。跑完才發現壓縮永遠在 agent_end 之後發生——摘要從來沒進到任何一次請求裡。要測的東西一次都沒測到。
5. 照著不存在的功能寫大綱。
原本 Day23–24 要用 pi evals。它不存在,是我憑印象寫下的。Day19 的 telemetry 也一樣——契約完整到讓我以為它已經在跑了。
6. 拿 n=3 的校準數字當初步結論在講。
Day9 的校準跑了 3 次,T3 量到 +63.8%;正式用 5 次跑,同一個比較變成 +28.7%。點估計掉了一半以上,只有方向站得住。Day23 做完 bootstrap 才看清楚這件事有多不牢靠。
這六件事有一個共同點:它們全部是被「記錄」抓出來的,不是被我想出來的。
gpt-5.6-luna。所有百分比都可能隨模型改變,撐得住的只有方向。把 30 天濃縮成一張清單:
這 30 天最讓我意外的不是任何一個百分比,而是:
我原本以為在寫一個「怎麼調教 agent」的系列,結果寫成了一個「怎麼量自己有沒有在亂講」的系列。
harness engineering 真正的內容,好像就是這個:agent 的行為是隨機的,你唯一能控制的是它的輸入和你的量尺。前者決定它做什麼,後者決定你知不知道自己做了什麼。
所有程式碼、資料與圖表都在 howisyour/my_first_pi_agent_project,歡迎拿去改、拿去跑、或是拿去證明我哪裡量錯了——那正是把資料全部公開的原因。


 iThome鐵人賽
 看影片追技術