
昨天的文章中直接調用了 milvus 的 search 功能來找相似的向量,但具體是怎麼做到並沒有細究,今天希望來瞭解一其中的原理與細節,並在 milvus 試做 IVF、HNSW 等 ANN Index 方法。
Search 本質上就是 vector similarity search,目前 Milvus 對一般 dense float vector 支援三種 metric_type:
metric_type |
意思 | 越像代表 |
|---|---|---|
COSINE |
Cosine Similarity | 越大越像 |
IP |
Inner Product | 越大越像 |
L2 |
Euclidean Distance | 越小越像 |
使用 create_collection() 時,Milvus 會自動幫我們建立 Vector Index,而 metric_type 用來指定搜尋時要如何衡量 Vector 的相似度,如果沒有指定,預設是 COSINE。
milvus_client.create_collection(
    collection_name=collection_name,
    dimension=dimension,
    metric_type="IP"
)
Cosine Similarity 看的是兩個 Vector 之間的夾角有多小,夾角越小代表方向越接近,也通常表示兩者越相似。
公式: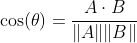
結果越接近 1 代表方向越相似,0 代表幾乎沒關係,-1 則代表方向完全相反。
很適合拿來比較文字 Embedding,因為我們通常比較在意「語意方向像不像」。
IP 是 Inner Product,直接把兩個 Vector 對應位置相乘後全部加起來。
公式: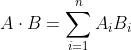
COSINE 基本上就是 Normalize 後的 IP,反過來說 IP 就是考慮了 Vector 長度後的 COSINE。分數越大通常代表越相似。
L2 就是 Euclidean Distance,可以直接想成兩個 Vector 在空間中的直線距離。
公式: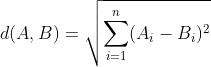
和 COSINE、IP 相反,L2 是數字越小越相似,因為代表兩個 Vector 在空間中的位置越靠近。
但 Milvus 為了省掉沒必要的計算,實際計算 L2 時不會做最後的平方根,而是直接回傳平方距離,不影響最後的 Ranking。
重點來了,該決定何時用哪種 metric_type呢?答案其實很簡單:優先看使用的 Embedding 模型建議搭配哪一種 Metric。舉例來說,昨天使用的 paraphrase-multilingual-MiniLM-L12-v2 這類 Sentence Embedding 模型通常會使用 COSINE 來比較語意相似度。
實際上不少主流的託管式 Embedding API 都會直接輸出 normalized vector,主打就是一個防呆,像是 OpenAI 的 text-embedding-3-small 預設會做 L2 normalization,所以 IP 和 COSINE 算出來會得到一模一樣的結果,就連 L2 也會得到相同的排序,只是分數形式不同。
講到資料庫就絕對繞不開 Index 的概念,Milvus 支援了多種 Index Types:
FLAT 是一個例外,甚至能 argue 這種到底能不能算一種 Index,因為他根本沒有另外存其他資料結構,就只是把 Query Vector 跟所有 Vector 都暴力算一次相似度而已。
另外前面提到 Milvus Lite 目前只支援 FLAT 而已,即使指定了其他 index type,Lite 也還是使用 FLAT。
建 Index:
index_params = milvus_client.prepare_index_params()

index_params.add_index(
    field_name="vector",
    index_type="FLAT",
    metric_type="COSINE"
)

milvus_client.create_index(
    collection_name=collection_name,
    index_params=index_params
)
IVF 之所以叫 Inverted File,是因為它不是從「某個 Vector 要去哪裡」的角度存,而是反過來建立:
每個 cluster / centroid 底下,有哪些 Vector?
先跑 K-means 把 Vector 分成很多 cluster,用 centroid 來代表每個 cluster,Query 來時,先找靠近 Query 的 centroid,只搜尋那些 cluster,而不是整個 dataset,適合用在資料量大、需要高 throughput 的情境。
IVF 有 2 個主要參數:nlist:用來控制 cluster 的數量。nlist 越大,Vector Space 會被切得越細,每個 cluster 裡的 Vector 越少,但建立 Index 的成本也會增加。nprobe:用來控制搜尋時要檢查多少個 cluster。nprobe 越大,搜尋範圍越廣,通常 Recall 會更高,但搜尋速度也會變慢。
建 Index:
index_params = milvus_client.prepare_index_params()

index_params.add_index(
    field_name="vector",
    index_type="IVF_FLAT",
    metric_type="COSINE",
    params={
        "nlist": 128
    }
)

milvus_client.create_index(
    collection_name=collection_name,
    index_params=index_params
)
搜尋時:
results = milvus_client.search(
    collection_name=collection_name,
    anns_field="vector",
    data=[query_vector],
    limit=3,
    search_params={
        "params": {
            "nprobe": 8
        }
    },
    output_fields=["text"]
)
HNSW 是一個多層的 Graph-based 資料結構,單獨看一層 Graph,它會讓彼此接近的 Vector 互相連成 Graph,在搜尋時從一個 Vector 進去,之後沿著 Graph 一路往相似度更高的方向走。
為什麼要多層?如果只有一層 Graph,搜尋時可能要經過很多節點才能慢慢靠近 Query,因此 HNSW 加入了 Hierarchical 的概念:先在節點較少的高層快速做大範圍移動,找到大概的位置後,再一層一層往下做更精細的搜尋,最後到包含所有 Vector 的 Layer 0 找出最近鄰。
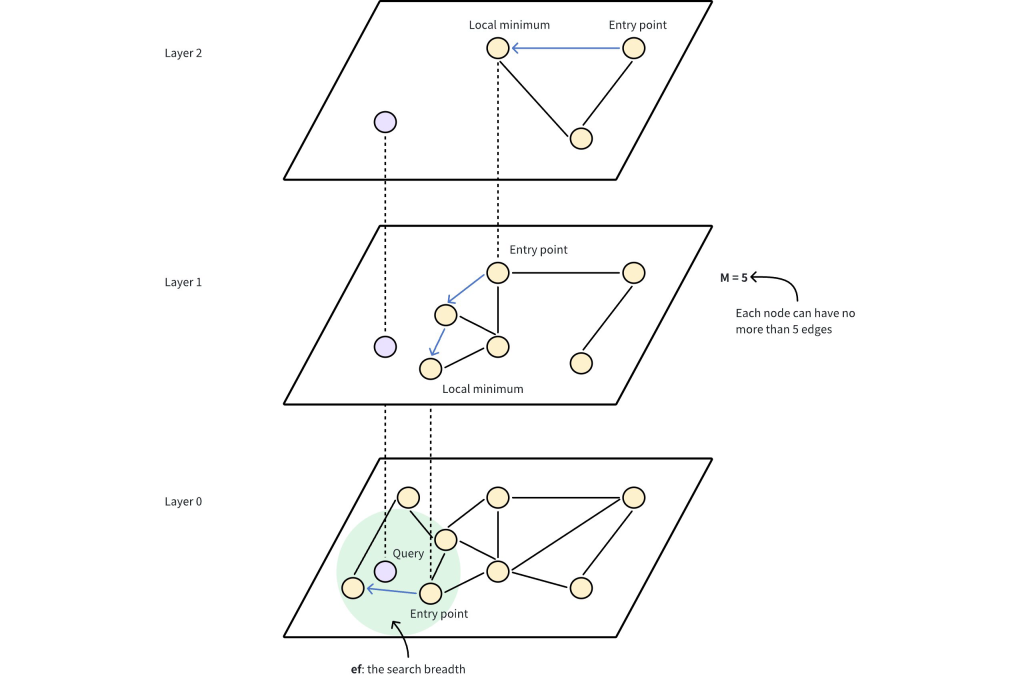
(Image Source: https://milvus.io/docs/hnsw.md)
HNSW 有 3 個主要參數:M:控制每個節點最多可以連多少個鄰居。M 越大 Graph 通常越密,越大通常 Recall 越高,但會增加記憶體使用量與建 Index 的成本。efConstruction:控制建立 Graph 時會考慮多少候選鄰居。越大通常能建立品質更好的 Graph,但建 Index 的時間也會增加。ef:控制搜尋時保留多少候選節點繼續探索 (只作用在最底層)。ef 越大通常 Recall 越高,但搜尋延遲也會增加。
建 Index:
index_params = milvus_client.prepare_index_params()

index_params.add_index(
    field_name="vector",
    index_type="HNSW",
    metric_type="COSINE",
    params={
        "M": 16,
        "efConstruction": 100
    }
)

milvus_client.create_index(
    collection_name=collection_name,
    index_params=index_params
)
搜尋時:
results = milvus_client.search(
    collection_name=collection_name,
    anns_field="vector",
    data=[query_vector],
    limit=3,
    search_params={
        "params": {
            "ef": 32
        }
    },
    output_fields=["text"]
)
那插入新資料時 Milvus 具體來說是如何更新 index 呢?
方法其實跟搜尋時很類似,由一個指數分布的隨機機制決定它最高出現在第幾層,走到哪就插到哪,Milvus 現在的 HNSW 底層實作使用的是 hnswlib,我們改用 python 來重寫看看:
from math import log, exp
from random import random

M=5

# 抽 Layer
mult_ = 1 / log(M)
level = int(-log(random()) * mult_)

# 反推至少進 Layer i 的機率
for i in range(5):
    prob = exp(-i/mult_)
    print(f"至少進 Layer {level}: {prob * 100:.2f}%")
可以算出,假設 M = 5,則插入一個新的 Vector 的機率:
至少進 Layer 0: 100.00%
至少進 Layer 1: 20.00%
至少進 Layer 2: 4.00%
至少進 Layer 3: 0.80%
至少進 Layer 4: 0.16%
另假設總資料量是 N,那總層數大致會落在:
log(N, M)
可以算出,假設 M = 5、N = 1_000_000,最高層大約會是 8.58。
從以上公式能看出,當 M 越小,Vector 被抽到更高 Layer 的機率就越高,理論上層數也會越多。不過實務上不用太糾結 M 對層數的影響。Milvus 的 HNSW 更主要還是把 M 視為控制每層 Graph connectivity 的參數。
HNSW 的優點是 Graph 導航效率很好,在資料能放進記憶體的前提下,通常可以做到很低的 query latency,而且高 Recall 表現很好;缺點就是 Graph 本身要吃不少 RAM,M 越大還會更吃。
IVF 則是先把資料分 cluster,搜尋時只會看一部分 cluster。它的結構比較簡單、Index Build 通常更快,而且額外記憶體成本也比 HNSW 小;但如果想把 Recall 拉得很高,就得提高 nprobe,等於掃更多 cluster,速度優勢會逐漸縮小。
另外一個考慮點是 filter ratio,如果 metadata filtering 已經把候選資料砍掉很多,IVF 往往比 Graph-based index 更合適;如果過濾後只剩非常少的資料,甚至直接 FLAT 都可能比較划算。
Index 建好了,最接近的是床。


 iThome鐵人賽
 看影片追技術