
討論測試之前,先把「錯」分成三個層次:
三者的關係是:人犯下 error,在程式裡留下 fault,fault 被執行到時才表現為 failure。測試能直接觀察到的只有 failure,fault 和 error 都要從 failure 往回推。一個 fault 如果從來沒被執行到,測試就看不見它。
測試(testing)是用一組 test case 執行程式,觀察是否發生 failure。一個 test case 至少包含兩個部分:輸入與預期輸出。
以軟體測試教科書常用的三角形問題為例:輸入三邊長,判斷能組成哪一種三角形。
| 輸入 (a, b, c) | 預期輸出 |
|---|---|
| (5, 5, 5) | 正三角形 |
| (5, 5, 3) | 等腰三角形 |
| (3, 4, 5) | 不等邊三角形 |
| (1, 2, 5) | 無法構成三角形 |
只有輸入不算 test case。沒有預期輸出,執行完也無從判斷對錯。決定「預期輸出是什麼」的依據稱為 test oracle,這往往是測試中最難的部分。
依照測試的範圍,常見的分法是 V-model:
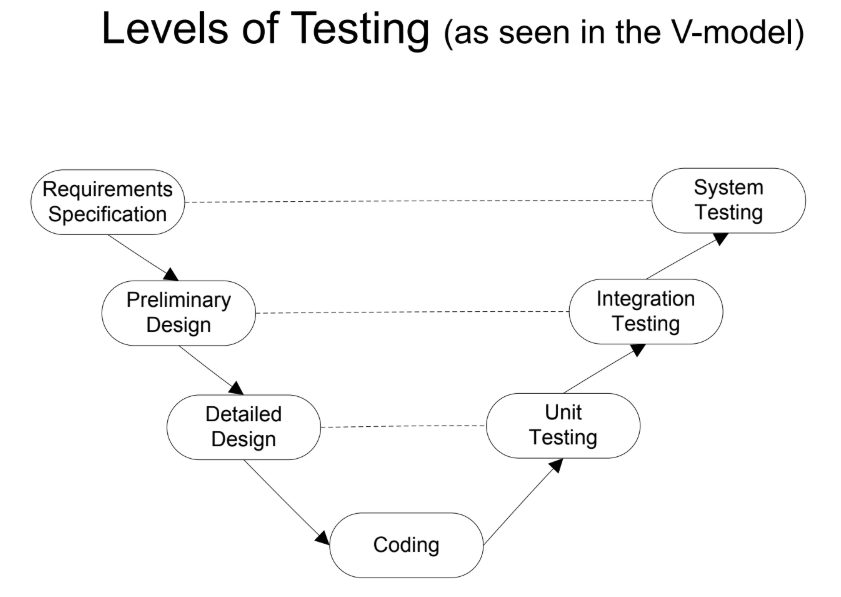
圖片來源:Paul C. Jorgensen, Byron DeVries, Software Testing: A Craftsman's Approach, 5th Edition
左邊從需求一路細化到程式碼,右邊把程式碼逐層組回去並驗證。虛線表示每一層測試對照的依據:
| 對照的依據 | 測試層級 | 驗證的對象 |
|---|---|---|
| Requirements Specification | System Testing | 整個系統是否滿足需求 |
| Preliminary Design | Integration Testing | 模組之間的介面與互動是否一致 |
| Detailed Design | Unit Testing | 單一函式或類別是否照設計運作 |
V-model 是一種偏瀑布式的開發流程,但它指出的對應關係不受開發流程限制:每一層測試,都是拿程式去對照某一份預期。
2024 年 7 月 19 日,資安公司 CrowdStrike 推送了一份例行的偵測規則更新。更新發布後,全球約 850 萬台 Windows 電腦陸續藍屏、無法開機,航空、銀行、醫院與電視台的系統同時停擺。光是 Delta 航空就取消了數千個航班,並表示損失約 5 億美元。
根據 CrowdStrike 事後公布的根因分析,問題出在一個欄位數量的不一致:規則的範本定義了 21 個輸入欄位,負責比對的程式卻只提供 20 個。這份更新第一次用到了第 21 個欄位,程式讀取超出範圍的記憶體而崩潰。
這個 fault 並不是那天才出現的。它早已存在於程式中,只是先前的測試與規則從未執行到第 21 個欄位。報告中列出的改善項目,第一項就是補上相關的測試。
同一個 fault,在不同時間點被發現,處理的代價截然不同:
回頭看 V-model,這個差距來自回溯的距離。越右上方發現的 failure,越需要沿著左側往回推,才能找到最初的 error。CrowdStrike 的 fault 如果在開發階段被一個 test case 執行到,修正成本只是幾行程式;到了 850 萬台電腦上,它變成了一場需要逐台手動修復的事故。
Jorgensen 用一張文氏圖描述程式行為:
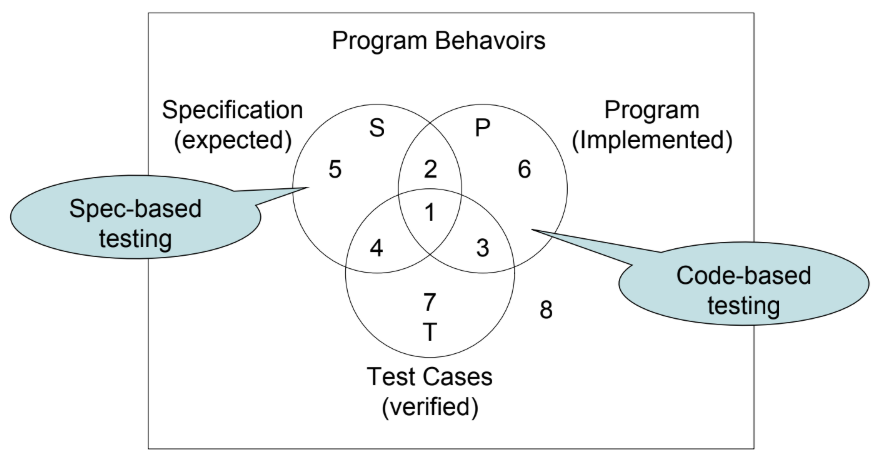
圖片來源:Paul C. Jorgensen, Byron DeVries, Software Testing: A Craftsman's Approach, 5th Edition
理想情況下三個圈完全重合,實際上一定會錯開。S 和 P 的落差對應兩種 fault:
T 圈的作用,是把這些落差找出來。區域 4 是需求有寫、測試有驗、但程式沒做到——測試會失敗,fault 被發現了。區域 5、6 則是落差存在,卻沒有任何測試涵蓋,只能等使用者遇到。
測試的目標,是讓區域 1 盡可能大。
Dijkstra 有一句常被引用的話:
Program testing can be used to show the presence of bugs, but never to show their absence.
測試只能執行有限的輸入,而大多數程式的輸入空間都遠大於此。三角形問題只有三個整數,組合數就已經無法窮舉。所以測試通過,只代表在 T 圈涵蓋的範圍內沒有發現 failure,不代表程式正確。
這也是為什麼「怎麼挑選 test case」本身是一門學問。
圖上標出了挑選 test case 的兩個方向:
| 方法 | 別名 | 依據 | 找不到的問題 |
|---|---|---|---|
| Spec-based testing | Functional、Black-box | 需求規格 | 需求沒寫、程式卻做了的行為(區域 6) |
| Code-based testing | Structural、White-box | 程式碼結構 | 需求有寫、程式卻沒做的行為(區域 5) |
兩者各有盲點。Spec-based 只看需求,不知道程式偷偷多做了什麼;code-based 只看程式,無從得知有什麼該做卻沒做。實務上兩種方法互相補充。
| 語言 | 代表工具 | 使用例子 |
|---|---|---|
| Python | pytest | pytest:執行 test_*.py 裡的測試 |
| JavaScript / TypeScript | Vitest、Jest | npx vitest run:執行專案測試 |
| Go | go test |
go test ./...:執行所有套件的測試 |
| Rust | cargo test |
cargo test:執行專案測試 |
| C++ | GoogleTest | 建置後透過 ctest 執行 |
| Java | JUnit 5 | mvn test 或 gradle test |
Go 和 Rust 將測試工具內建在語言的工具鏈中,其他語言則需要額外安裝測試框架。
測試給 coding agent 的,是一個可以自己執行、自己判斷的完成條件:
讀取需求與測試 → 修改程式 → 執行測試 → 依失敗訊息修正
失敗訊息會指出哪個 test case、預期輸出是什麼、實際輸出是什麼。這比自然語言描述的需求更精確,agent 不需要猜「做到什麼程度才算完成」。
AI 也能寫測試,而且很快。常見的做法是先請 AI 實作,再請它「幫這段程式補上測試」。
這時 AI 手上唯一的依據就是實作本身,它寫出的是 code-based testing,而且預期輸出是從程式的行為抄來的。如果實作誤解了需求,測試會照著同樣的誤解寫下預期輸出。結果是全部通過,但這些測試落在區域 3:有實作、有驗證,卻不在需求裡。
這類測試少了 oracle。它只能證明程式和自己一致,無法發現 fault of omission,也不會縮小區域 5。
比較穩的分工,是讓 oracle 留在知道需求的人手上:


 iThome鐵人賽
 看影片追技術