
昨天認識了 Pod,它是 Kubernetes 真正啟動的最小單位,也是可替換的執行個體。那如果 API 要長期維持三個一樣的 Pod 達到有容錯的能力,當某一顆被刪除或 Node 故障時又要補回來,難道要自己一直 kubectl apply 新 Pod 嗎?
在 Kubernetes 的世界裡是不需要的,透過 Deployment 去建立應用服務的 Pod,由它宣告 Pod 的副本(replica)的期望數量,並交給 Kubernetes 的 Controller 持續維持。
當我們 apply 一份 Deployment 時,並不是 API Server 立刻直接生出所有 Pod 或是單一個底層元件去直接幫我們建立好 Pod,而是由多個 Controller 接力工作:
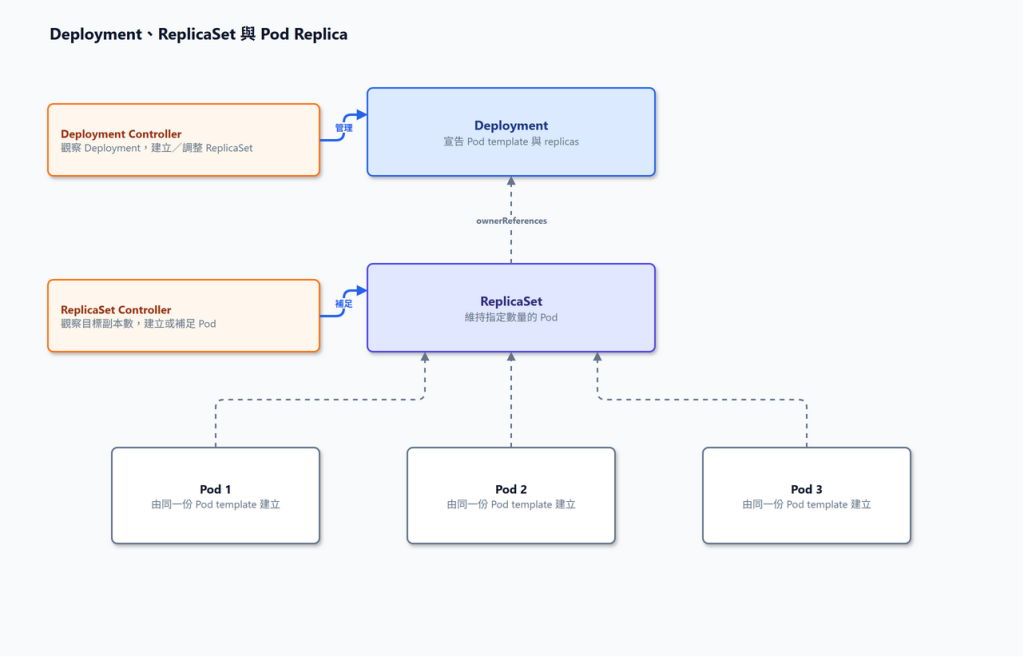
kubectl apply 將 Deployment 的宣告送給 API Server。這邊省略掉了拉取 Image 的細節。
在 Day 5 提到的控制迴路,這裡也能看到具體的應用:
Deployment、ReplicaSet 與 Pod 之間有緊密的相依關係,這也是在查看一個 Pod 時,能追查它屬於哪個 ReplicaSet,再往上追到哪個 Deployment。
Pod replica 的運作方式並不是把同一個 container 複製三次塞進同一個 Pod,而是由同一份 Pod template 建立出三個獨立的 Pod,每一個 Pod 都有自己的 Pod IP、container、生命週期。
Deployment 的 Pod template 比較像一個建立 Web API 執行個體的藍圖,三個 Pod 副本則是依同一份藍圖所建立的三個獨立執行個體,因此其中一顆 Pod 發生問題時可以被替換,而不會直接把其他兩顆一起帶走。
下面是一份簡化過的 Deployment YAML 範例:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: backend-api
spec:
  replicas: 3
  selector:
    matchLabels:
      app: backend-api
  template:
    metadata:
      labels:
        app: backend-api
    spec:
      containers:
        - name: api
          image: example.registry/backend-api:1.0
這個範例最重要的是三個區塊:
| 欄位 | 意義 |
|---|---|
.spec.replicas |
希望同時存在幾個符合條件的 Pod。 |
.spec.selector |
Deployment 與 ReplicaSet 用來辨識哪些 Pod 是自己管理對象的條件,用 SQL 理解就是 SELECT * FROM template.metadata.labels WHERE app = "backend-api" (這個解釋方式連我自己很喜歡 XD) |
.spec.template |
建立新 Pod 時所使用的藍圖,包含 labels、container image、Port、Volume 等設定。 |
一些較舊的教材會出現 ReplicationController 這一個 Controller,目前雖然還能夠在 Kubernetes 中使用,但它已經被視為過時的元件,基本上新的服務都不建議再用它,不過呢我還是想簡單分辨這兩者的差異。
| ReplicationController | ReplicaSet | |
|---|---|---|
| 主要工作 | 維持指定數量的 Pod | 同左 |
| Pod 的啟動方式 | 建立 Pod 後仍交給 Scheduler、kubelet、Runtime | 同左 |
| selector | 舊式 equality-based selector | 支援較完整的 set-based selector |
其實都是在維持期望的 Pod 副本數量,差異主要在於 selector 的能力。
ReplicaSet 支援較靈活的 label selector,例如可以表達「environment 屬於 dev 或 test」、「有 release 這個 Label」,或「沒有 maintenance 這個 Label」之類的條件,而 ReplicationController 就只支援「 key=value 」這種舊式的相等比對。
以下先看 ReplicationController 的 selector 範例:
apiVersion: v1
kind: ReplicationController
metadata:
  name: backend-api-legacy
spec:
  replicas: 3
  selector:
    app: backend-api
    environment: dev
  template:
    metadata:
      labels:
        app: backend-api
        environment: dev
    spec:
      containers:
        - name: api
          image: example.registry/backend-api:1.0
可以看到在 spec.selector 中,ReplicationController 只能使用簡單的 key-value 方式來選擇 Pod。
以下再用一份 ReplicaSet YAML 展示 matchExpressions 的四種運算子。實際使用時,所有 matchLabels 與 matchExpressions 條件都必須同時符合(AND)條件:
apiVersion: apps/v1
kind: ReplicaSet
metadata:
  name: backend-api
spec:
  replicas: 3
  selector:
    matchLabels:
      app: backend-api
    matchExpressions:
      - key: environment
        operator: In
        values: [dev, test]
      - key: workload
        operator: NotIn
        values: [batch]
      - key: release
        operator: Exists
      - key: maintenance
        operator: DoesNotExist
  template:
    metadata:
      labels:
        app: backend-api
        environment: dev
        workload: service
        release: stable
    spec:
      containers:
        - name: api
          image: example.registry/backend-api:1.0
| 條件 | 意義 |
|---|---|
matchLabels |
app 必須等於 backend-api;每組 key-value 都是相等比對。 |
In |
environment 必須存在,且值為 dev 或 test。 |
NotIn |
workload 不可為 batch;此條件也會匹配沒有 workload Label 的 Pod。 |
Exists |
Pod 必須有 release 這個 Label,不限定其值。 |
DoesNotExist |
Pod 不可以有 maintenance 這個 Label。 |
範例中的 template 建立的是 environment: dev 的 Pod,而 selector 設定為可以接受 dev 或 test,所以如果後續將 template.metadata.labels.environment 改成 test,ReplicaSet 仍然會認為這些 Pod 符合管理條件。
假設我們想同時執行 backend-api 的穩定版與測試版,卻讓兩個 Deployment 都只用 app: backend-api 去選擇 Pod:
# 正式版
apiVersion: apps/v1
kind: Deployment
metadata:
  name: backend-api-stable
spec:
  replicas: 2
  selector: # selector 是相同的
    matchLabels:
      app: backend-api
  template:
    metadata:
      labels:
        app: backend-api
        version: stable
    spec:
      containers:
        - name: api
          image: example.registry/backend-api:1.0
---
# 測試版
apiVersion: apps/v1
kind: Deployment
metadata:
  name: backend-api-test
spec:
  replicas: 1
  selector: # selector 是相同的
    matchLabels:
      app: backend-api
  template:
    metadata:
      labels:
        app: backend-api
        version: test
    spec:
      containers:
        - name: api
          image: example.registry/backend-api:1.1
兩份 Deployment 的 selector 都只使用 app: backend-api 篩選,因此用這個條件查詢時,穩定版與測試版的 Pod 都會出現在結果中:
kubectl get pods -l app=backend-api
Deployment 建立的 ReplicaSet 會額外使用 hash 區分不同 Pod template,並透過 owner reference 記錄管理關係,所以不會說兩個 Deployment 會互相刪除對方的 Pod 或是不知道會建立哪一個版本的 Pod。
但真正的問題是兩個 Deployment 的 selector 範圍重疊,其他依 selector 找 Pod 或計算 Pod 的操作可能把兩個版本一起納入,造成無法預期的管理結果,Kubernetes 不會禁止這種行為,因此應讓不同 Deployment 使用互不重疊的 selector。
例如,讓 Deployment 各自加入不同的 version 條件,並確保 Pod template 也帶有對應 Label。以下是兩份 Deployment 的 selector 與 template 片段:
# Stable Deployment 的 selector/template 片段
selector:
  matchLabels:
    app: backend-api
    version: stable
template:
  metadata:
    labels:
      app: backend-api
      version: stable
# Test Deployment 的 selector/template 片段
selector:
  matchLabels:
    app: backend-api
    version: test
template:
  metadata:
    labels:
      app: backend-api
      version: test
這樣兩個 Deployment 各自只選自己的 Pod。若 Service 要同時把流量送到這兩組 Pod,Service 可以只用共同的 app: backend-api selector。Deployment 的管理 selector 應區分清楚;Service 的 selector 則可依流量需求選取一組或多組 Pod。
一般情況下,不需要,也不建議手動管理 Deployment 擁有的 ReplicaSet。
Deployment 比 ReplicaSet 多了一層「發布管理」能力,當我們修改 .spec.template,例如把 image 版本從 1.0 改成 1.1,Deployment Controller 會建立新的 ReplicaSet,再增加新 ReplicaSet 所屬的 Pod 以及減少舊 ReplicaSet 的 Pod。
舊 ReplicaSet 也保留了 revision 資訊,讓未來可以查看歷史或 rollback。
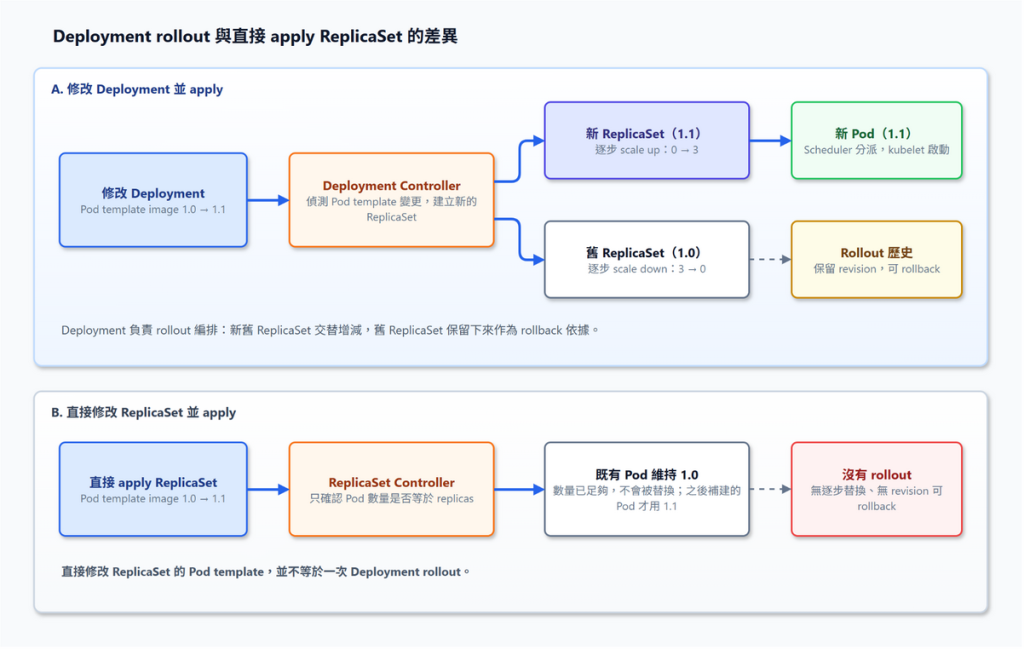
因此實務操作通常是:
修改 Deployment
  ↓
kubectl apply Deployment
  ↓
Deployment Controller 自動處理 ReplicaSet
  ↓
ReplicaSet 自動處理 Pod
只有在真的需要自行設計 Pod 更新策略,或工作負載根本不需要更新時,才可能直接管理 ReplicaSet。對大多數 Web API 而言,直接使用 Deployment 比較合理。
假設 Deployment 的 replicas 是 3,目前也有三顆 Pod。若手動刪除其中一顆,ReplicaSet Controller 很快會看到「目前只有兩顆」,於是建立另一顆新的 Pod 補到三顆。
這不是那顆 Pod 自己復活,而是 Controller 根據期望狀態建立了新的替代品。新的 Pod 名稱、Pod IP、所在 Node 都可能不同,因此程式不應依賴某一顆特定 Pod 的名稱或 IP。
今天我們看到,Deployment 被宣告並套用後,會由 Deployment Controller 建立 ReplicaSet,再由 ReplicaSet Controller 依照副本數建立 Pod。
我們也比較了 ReplicaSet 和 ReplicationController:兩者都維持指定數量的 Pod,ReplicaSet 則支援更有彈性的 matchLabels 和 matchExpressions,可以用 Label 表達更細緻的選擇條件。
Deployment 建立 ReplicaSet 時,會使用 pod-template-hash 區分不同 Pod template 版本,Pod 的 ownerReferences 則記錄它由哪個 ReplicaSet 管理。
因此,當兩個不同 label 的 Deployment 使用不同的 Pod template 時,即使兩邊都有共同的 app Label,各自的 ReplicaSet 仍能辨識所管理的版本。不過,如果只用 app 查詢 Pod,這兩種 label 的 Pod 都會被列出,若要再分辨版本,就需要再增加更多篩選條件去區分。
記住,用 SQL 的 WHERE 條件來理解可以很快明白!
當我們進一步使用金絲雀部署或藍綠部署時,像 version 這類 Label 就能協助區分版本與控制流量,後續文章會再針對這種部署策略進行分享。


 iThome鐵人賽
 看影片追技術