
前幾把一堆零散回饋整理成五張需求卡,每一張都有證據 ID,每一張看起來都該做。今天要回答的問題比前九天都難:五張都對,先做哪一張?
這個問題沒有正確答案,只有「講得出理由的答案」。所以今天的重點是讓它把排序背後的假設攤開,然後把決定權交回會議桌上。
排優先級最常見的失敗,是排完沒人記得為什麼,因為 排序的輸入沒有留紀錄。
AI 在這裡能幫的,正好就是留痕:把每個分數的依據、每個假設的來源、每個「如果這個數字變了排序會怎樣」都寫下來。
本文用四個維度打分,每個維度 1–5 分:
公式:
初步分數 = (影響程度 × 急迫性 × 證據信心) ÷ 開發成本
MoSCoW 分類法也是常見選項,Must、Should、Could、Won't 四格直觀,小團隊十分鐘能分完。我沒有用它,原因是它只給結論不給理由:一張卡被放進 Must,三週後沒人記得是誰、憑什麼放進去的。加權公式的好處不在數字精確,而在每個乘數都逼你交出一句理由。
公式的限制:四個維度相乘,任何一格差一分,總分就會大幅跳動。
這代表公式對分數很敏感,也代表它適合拿來「找出哪個假設最關鍵」,後面的敏感度分析就是為此存在。
① 定義量尺:四個維度各寫出 1、3、5 分的具體判準,貼在評分表最上方。
② 逐卡打分:每個分數旁邊附一句依據,證據信心必須引用需求卡上的回饋編號。
③ 算分並標記同分:套公式算分,分數差距在 15% 以內的卡片視為同分。
④ 做敏感度分析:對每張卡問一次「哪一格改一分,排序會翻?」把會翻的那一格標出來。
⑤ 記錄決策與覆核條件:寫下決策者、日期、以及「看到什麼數據就要重排」。
第 ③ 步的 15% 是我自己的經驗值,僅供參考。
四個 1–5 分的數字相乘再相除,差一兩分的卡片實際上分不出高下,硬排先後只會製造假精確。
以下分數與成本皆為教學用模擬資料。
① RC-01 找到第一件工作
② RC-02 呈現角色可行行動
③ RC-03 理解專案脈絡
④ RC-04 提供合時機指引
⑤ RC-05 從邀請抵達工作區
排出來 RC-01 領先,RC-03 與 RC-02 分數差距在 15% 以內,視為同分並列第二。
再看敏感度:RC-01 的影響分數建立在「多數成員首登時沒有任務」這個假設上。如果登入事件資料顯示七成成員首登時已有指派任務,影響分數掉到 2,RC-01 就會落到 RC-03 後面。這一格,是五張卡裡最值得先花半天去查的一格。
情境:將模擬規則套用到投資內容型 App 改版後收集的真實使用者回饋,跑完第一輪排序後,第一名是一張證據信心 4 分的需求卡。
盲點:同一位使用者透過 App Store、客服、社群三個管道抱怨同一件事,清洗規則誤將其視為三筆獨立資料,導致證據信心被灌水。
本質:規則本身無誤,但前提錯誤,真實資料中,一個生氣的使用者可能跨管道重複發聲。
背景:
FlowBoard 團隊有五張新成員啟用需求卡,兩週內要選一到兩張做概念驗證。

任務:
① 檢查每張卡的四個分數是否都有卡片上的證據支持,特別檢查證據信心引用的回饋是否來自不同使用者。
② 依公式計算各卡分數,數字照原樣輸出,不要四捨五入。
③ 找出每張卡「改一分就會翻轉排序」的那一格。
④ 列出建議先查證的資料,以及建議進入概念驗證的卡片組合。

輸入:
【需求卡全文】
【評分量尺與各卡分數】

規則:
① 只複核,不改分數。認為分數有問題就標記並說明,不要自己改。
② 每一個判斷都要引用卡片上的回饋編號。
③ 分數差距在 15% 以內視為同分,要明確標出。
④ 你的輸出是討論材料,不是決定。不要出現「應該優先做」這種句子。

輸出:
A. 計算複核表
B. 各卡支持理由與潛在反證
C. 敏感度分析:每張卡最關鍵的一格
D. 建議會議議程:先查什麼、再討論什麼
【RC-01 找到第一件工作】
計算複核:(5 × 5 × 3) ÷ 2 = 37.5,與輸入一致。
支持理由:F03、F11、F32 三筆回饋,來自三位不同成員(依卡片標示)。
潛在反證:卡片未記錄首登時已有指派任務的成員比例。若比例偏高,影響分數的 5 分缺乏支撐。
敏感度:影響分數若降為 2,總分變為 15.0,排序落至 RC-03 之後。此為五張卡中最敏感的一格。
建議查證:調閱近 30 天新成員首登事件與任務指派紀錄。
輸出裡「與輸入一致」是事實,「三位不同成員」是依卡片標示的轉述,「若比例偏高則缺乏支撐」是推論。三種性質要分得清楚,讀的人才知道哪一句可以直接信、哪一句要自己去查。
① 每個分數的依據,是需求卡上的證據,還是評分者的印象?
② 證據信心引用的回饋,來自幾位不同的使用者?
③ 敏感度分析標出來的那一格,有沒有辦法在一週內查證?
④ 決策紀錄上有沒有寫「看到什麼數據就重排」?沒有的話,這次排序下週就會被推翻。
第 ② 題就是真實戰場那一節教我的。
這個 Skill 主要是多了算分腳本。
因為語言模型做乘除法會出錯,尤其一次算五張卡、還要比較差距百分比的時候。判斷交給模型,算術交給程式,這是值得養成的 Claude Code 習慣。
建立 .claude/skills/priority-review/SKILL.md:
---
name: priority-review
description: 複核需求卡的優先級評分,計算分數、標記同分、找出敏感假設,把決策留給人。
---

請依以下步驟執行:
① 讀取輸入的需求卡與評分表,不改動任何分數。
② 呼叫 `python3 .claude/skills/priority-review/scripts/score.py` 計算分數與同分群,不要自己心算。
③ 逐卡檢查證據信心引用的回饋編號是否來自不同使用者,發現重複來源就標記。
④ 對每張卡找出「改一分就翻轉排序」的那一格。
⑤ 輸出格式固定為:計算複核表、支持理由與反證、敏感度分析、建議會議議程。
⑥ 不要下「應該優先做」的結論,結尾提醒團隊由人決策並記錄覆核條件。
建立 .claude/skills/priority-review/scripts/score.py:
import json
import sys

cards = json.load(sys.stdin)
for card in cards:
    card["score"] = (card["impact"] * card["urgency"] * card["confidence"]) / card["cost"]

cards.sort(key=lambda c: c["score"], reverse=True)
for i, card in enumerate(cards):
    tie = ""
    if i > 0 and abs(card["score"] - cards[i - 1]["score"]) / cards[i - 1]["score"] <= 0.15:
        tie = "(與上一張同分)"
    print(f'{card["id"]}\t{card["score"]:.1f}{tie}')
執行指令:
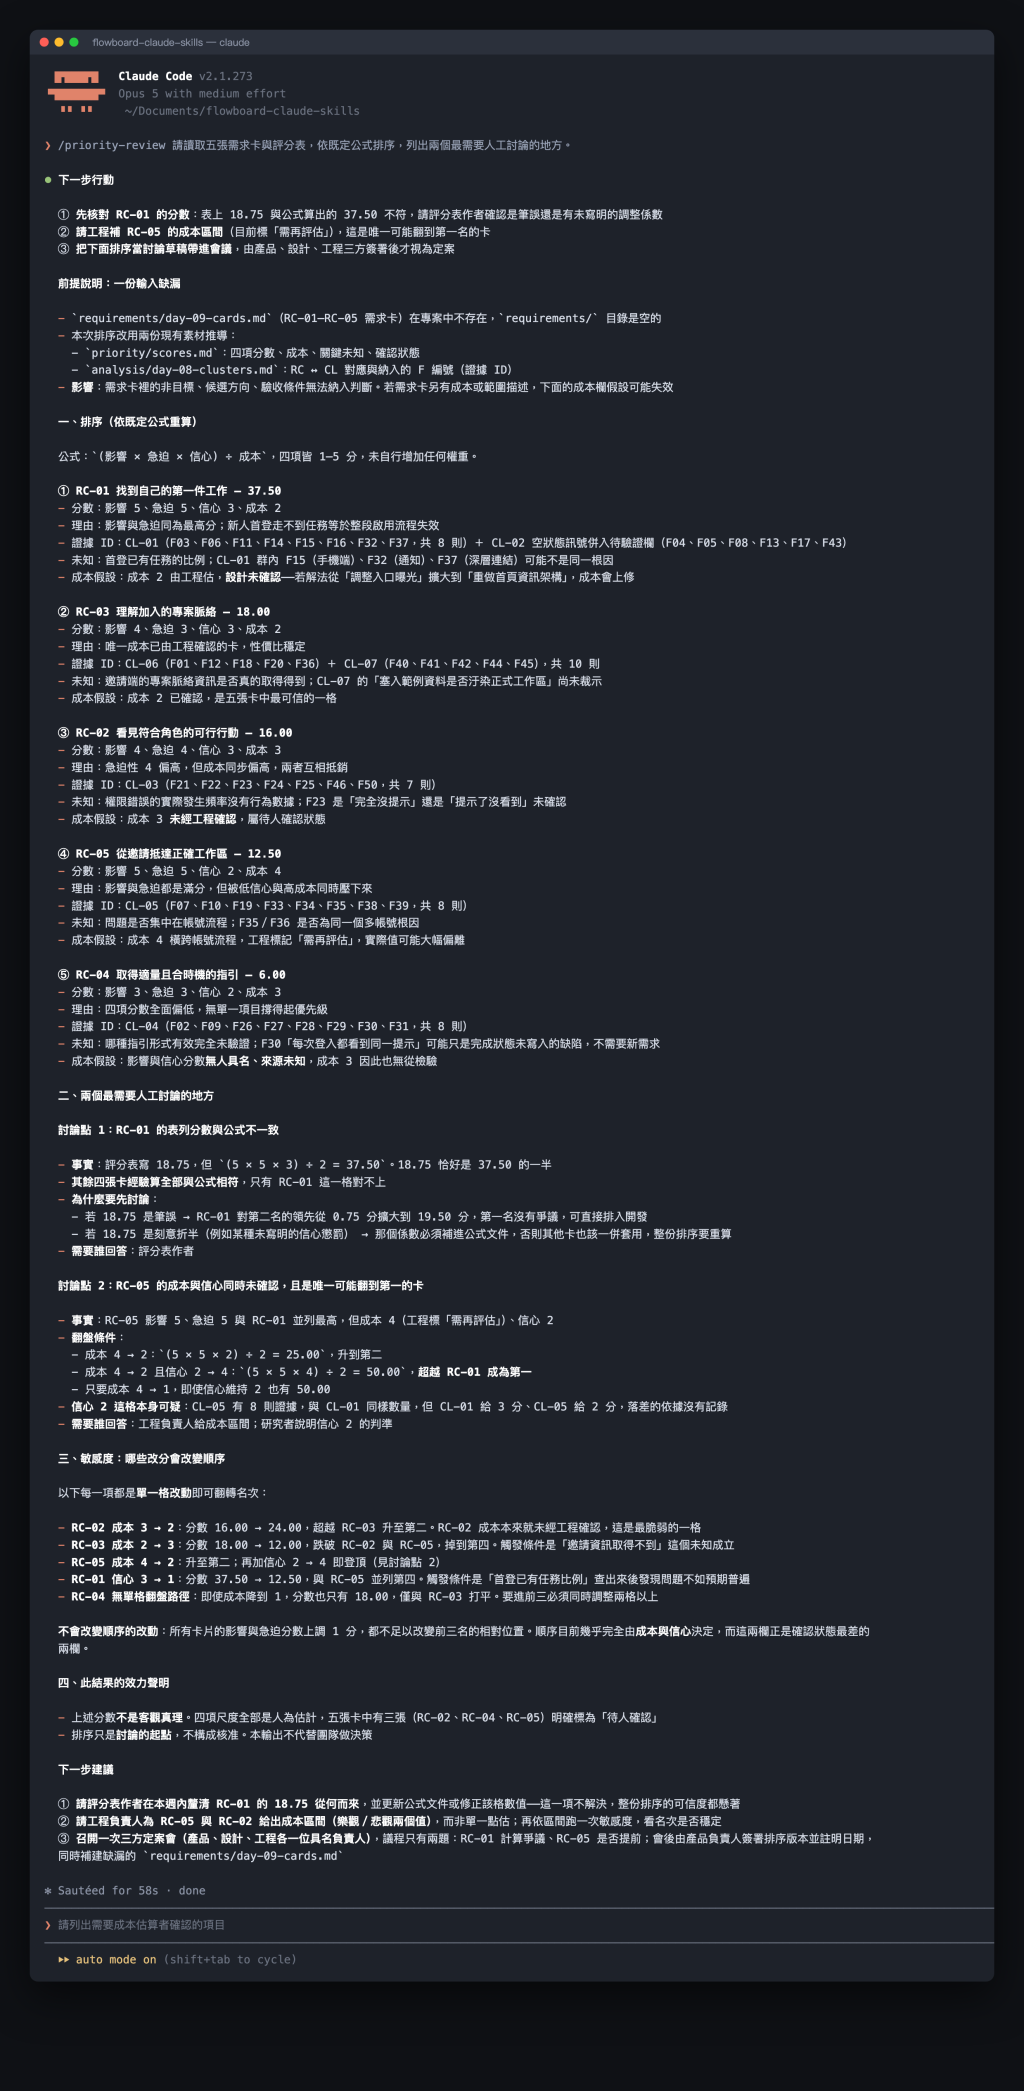
/priority-review 請讀取五張需求卡與評分表,算出排序,並指出最需要人工先查證的兩個地方。
執行後,終端機會列出公式、每張卡的輸入分數、同分標記與待查證清單:
今天帶走一份需求優先級評估表,包含:


 iThome鐵人賽
 看影片追技術