
Day 9 把 PM 的兩句話變成能開工的規格,Day 10 定落點與驗法,今天動手寫程式。
要改的是同一個訂單取消功能:已付款、尚未出貨,而且還沒取消的訂單,取消後要提出退款要求。 舊程式固定回傳 false,現在要讓它依規則決定。
只是,如果每次都要我喊「寫好了嗎?跑一下測試。失敗了,再改一次」,程式雖然交給 Claude,我還是坐在旁邊當傳話的人。 我想交出去的不只是寫程式,還有「改完、檢查、沒過再修」這段反覆工作。
今天想做到的是:把完成條件與修改範圍交代清楚,讓檢查結果能回到 Claude 手上;它能修的繼續修,需要決定的才停下來。 先看已經跑過的兩次開發呼叫,再把它接成有停止條件的小型回饋迴路。
先說一件我做完才知道的事:那個「它能修的繼續修」,到今天為止一次都沒有真的發生過。 四次實跑全停在第一輪,我連換小模型、抽掉規格都試過。後面會講為什麼,以及它反過來證明了什麼。
這次採測試先行,是因為規則的變動很明確:已付款的首次取消要提出退款要求,再取消一次則不能重複提出。先把這個差別寫下來,就能檢查程式是不是真的改到那裡。
這是教學訂單的規則變更,不是正式公司的退款決策。rules-v2.md 裡的 Owner 也是案例角色;RefundRequested 只是表示「需要退款」的旗標,不會真的執行退款。
Anthropic 的 AI-native SDLC playbook 與課程,把重點放在讓 Claude 取得可執行的回饋。修 Bug 適合先重現失敗,再修正;UI 工作則可以實作後操作畫面、比對與調整。不是每種工作都照同一個順序,但每種工作都需要知道做對了沒有。官方課程
把常見工作放在一起看,差別會更清楚:
| 工作類型 | 從哪裡開始 | 怎麼確認做對了? |
|---|---|---|
| 修 Bug | 先把問題重現成失敗測試 | 修正後通過,既有測試也沒壞 |
| 修改業務規則(本篇) | 先確認新規則與驗收情境 | 新行為符合要求,該保留的行為不變 |
| 重構 | 先留下既有行為的檢查 | 程式結構改了,對外行為不變 |
| 開發 UI | 依操作情境做出畫面 | 實際操作、比對預期,再修正 |
這次改的是訂單取消規則,屬於第二種。 我先確認「哪些結果要改、哪些不能變」,再讓 Claude Code 把它們寫成測試,作為修改程式時的核對依據。
Day 6 約好的完成條件,到了今天要變成能執行的檢查。Day 10 的計畫在這裡先取兩項:建立單元測試、修改訂單取消邏輯。API、安全性與通知設計沒有因為寫進計畫,就在今天一起完成。
規則與計畫準備好了,接下來是一件很容易被跳過的事:這次修改要放在哪裡?
人自己開發的時候,這個問題沒什麼重量。你一次只在一個地方工作,切錯分支自己會發現。換成 AI 驅動,同一個問題的性質就變了:
| 人驅動 | AI 驅動 | |
|---|---|---|
| 同時進行 | 一次一件,你知道自己在哪 | 可以同時開兩個 session,各自在改檔 |
| 位置感 | 記得自己在哪個分支 | 只拿到一個工作目錄,沒有你的心智模型 |
| 出錯時 | 覺得不對會停下來問 | 不會停,會照著錯的前提往下做 |
第三列才是重點。隔離不是禮貌,是煞車。出錯時你要還有一個沒被動過的地方可以回去。Claude Code 把 --worktree 做成原生旗標,就是承認了這個需求。
這是今天的第一道圍欄,圍的是檔案系統這一層。後面還會再圍兩層:能用哪些工具、誰有權寫入。三層都不是為了防它使壞,是為了出事時查得出是哪一層出的問題。
我的選擇是功能分支搭配 worktree。分支保存這件工作的提交;worktree 提供獨立工作目錄,讓原本的工作可以留在原地。同一個任務的修改、測試與修正留在同一份 worktree,不必每一步都另開一份。Git 官方說明
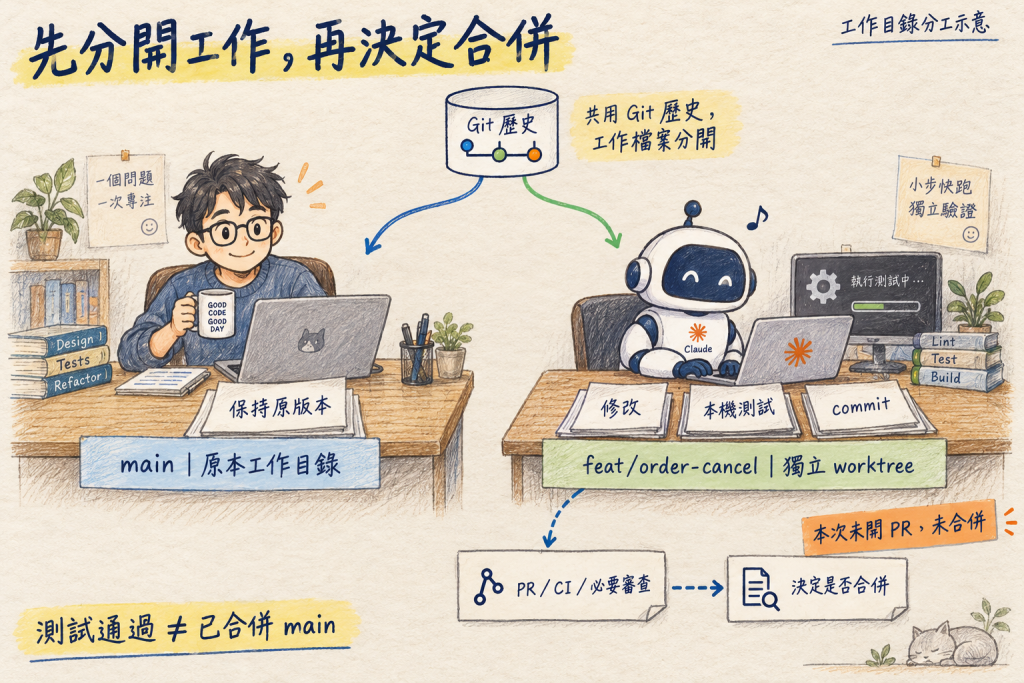
在已確認基準版本的 Git repo 根目錄,可以這樣建立:
git worktree add -b feat/order-cancel ../order-cancel-work main
cd ../order-cancel-work
這會從本機 main 建立 feat/order-cancel,並把它簽出到旁邊的新目錄。實際團隊若以其他分支或 commit 為基準,就換成那個已確認版本;尚未提交的規格與 plan.md 不會自動跟過去,開工前要先確認它們已包含在基準中。
也可以讓 Claude Code 建立自己的 worktree:在 repo 根目錄執行 claude --worktree order-cancel。這是另一種建立方式,不用接著上面兩行再做一次;起始版本與目錄行為依工具設定確認。Claude Code 官方文件
這裡補做了一次獨立驗證:把已備好的新測試與舊 Domain 放進教學 Git repo,再開功能分支與 worktree,讓 Claude Code 只改 Domain,外層執行測試。
| 核對位置 | 實際結果 |
|---|---|
| 開工基準 | SC-03 失敗,符合舊實作尚未支援新規則的預期 |
| 功能 worktree | Claude 只改 Domain,七項通過,保存本機 commit |
| 原本的 main | commit 未移動、工作目錄乾淨,仍在 SC-03 失敗 |
這證明的是本次工作目錄與分支的修改有分開。它不是下面那兩次歷史呼叫的 Git 紀錄,也沒有開遠端 PR 或合併 main。後面的回饋迴路示範仍使用獨立資料夾快照,不會因為加了這段就變成 worktree 實跑。
Worktree 也不會自動分開資料庫、連接埠或外部服務。這次只跑本機領域測試;多個 AI 同時啟動服務時,還要另外安排執行環境。只有一個任務依序做,使用一般功能分支也可以。
還沒驗過的一段:同樣的隔離在多人協作時只會更需要。兩個人各自帶著 AI 改同一個 repo,衝突不只是 Git 層的。但本篇沒有第二個人(第三幕會再回到這件事),所以這是延伸推論,不是這裡驗出來的結果。
第一層圍好了,回到開發本身:Claude 要依什麼開始改?
前面 Day 6–9 花時間釐清的,是需求為什麼要做、怎樣才算完成、現有程式有哪些限制,以及哪些決定還不能由 Claude 自己猜。到了這個訂單案例,確認後的規則整理在 rules-v2.md,要保留的理由與限制放進 CLAUDE.md;Day 10 再用 plan.md 排好修改範圍、順序與驗證方式。前面不同案例練習的方法,到這裡才接成同一份開發交付。
所以,這一次不是重新請 Claude 猜需求,而是讓它拿著已確認的規則與計畫,把驗收條件寫成可執行的測試,接棒進入開發。
輸入是 CLAUDE.md、plan.md、rules-v2.md 與現有程式。下面是原始提示的重點節錄:
只修改 tests/DomainTests/Program.cs。
依規格建立 SC-01 至 SC-07 的斷言,每個 Then 條件都要檢查。
與舊預期不同的地方,附上規則來源。
不要改 Domain、API 或規格;列出預期哪個情境失敗。
看第一行和最後一行。前者把可改的檔案鎖成一個;後者要它在跑之前先預言哪一格會紅——有了這句,下面那個紅燈才算得上證據,而不是碰巧失敗。
這次工具提供 Read、Grep、Glob、Edit、Write,沒有 Bash。Claude 寫測試,外層 Python 執行器負責實際跑 .NET。這是本次實驗的分工,不代表平常使用 Claude Code 必須拿掉執行工具。
Claude 回報了規則版本,也說明不連金流的理由。不過,念得出 CLAUDE.md 裡的字,不等於做對;接著看它寫出的測試與執行結果。
| 情境 | 出貨/付款/取消 | 規格要求的結果 | 舊程式會怎樣 |
|---|---|---|---|
| SC-01 | 否/否/否 | 取消成功(驗 Cancelled) |
一樣 |
| SC-02 | 是/否/否 | 回傳原訂單 | 一樣 |
| SC-03 | 否/是/否 | 取消成功,要求退款 | 回 false,對不上 |
| SC-04 | 否/否/否 | 不要求退款(同輸入,驗另一條規則) | 一樣 |
| SC-05 | 是/是/否 | 原訂單,不要求退款 | 一樣 |
| SC-06 | 否/否/是 | 原訂單,不要求退款 | 一樣 |
| SC-07 | 否/是/是 | 原訂單,不要求退款 | 一樣 |
SC-01 與 SC-04 的輸入欄完全相同(否/否/否),不是填表填重複了:同一組輸入要驗兩條不同的規則,SC-01 驗 BR-01「未出貨可以取消」,SC-04 驗 BR-03「未付款不提出退款」。代價是七格實際只涵蓋六種布林組合,「已出貨+已取消」那兩種沒有被測到。
其中 SC-03 檢查兩件事:
var r = Cancellation.Cancel(
    new Order(Shipped: false, Paid: true, Cancelled: false));
return r.Order.Cancelled && r.RefundRequested;
訂單要變成已取消,而且要提出退款要求。不是只確認程式執行時沒有發生例外。
外層執行器跑 dotnet run --project tests/DomainTests,得到:
PASS SC-01 未出貨可取消,不要求退款
PASS SC-02 已出貨不可取消,回傳原訂單
FAIL SC-03 已付款取消要提出退款要求
PASS SC-04 未付款取消不要求退款
PASS SC-05 已出貨已付款不可取消,不要求退款
PASS SC-06 已取消再次取消維持原狀(未付款)
PASS SC-07 已取消再次取消不重複退款(已付款)
FAIL: 1 項條件未通過
這個紅燈有意義,是因為它失敗在預期的 SC-03。 編譯失敗、專案路徑錯了,也會失敗,但不能拿來證明測試抓到了規則差異。
SC-06、SC-07 是新增情境,卻一開始就綠。舊程式固定回 false,剛好符合「再次取消不重複提出退款要求」。所以不要要求每條新測試都必須先紅,要看它是否真的區分新舊行為。
這次讀同一份規格,再加上剛剛的測試輸出:
讀取 runs/tests/tests.txt,核對紅燈原因。
只修改 src/Domain/Cancellation.cs,符合 rules-v2.md。
不得修改測試、API、規格或新增金流。
不限定分支順序,以規格要求的結果為準。
看第四行——它是刻意寫的。
Claude 保留「已出貨不可取消」的判斷,將原本固定 false 的地方改成:
var refundRequested = order.Paid && !order.Cancelled;
var cancelledOrder = order with { Cancelled = true };
return new CancellationResult(cancelledOrder, refundRequested);
它也更新了過期註解,將規則來源指向 v2。接著由外層重跑同一套測試,七項通過。
第四行是為 Day 9 那場「要不要先判斷已取消」的爭論收尾:規格限制的是結果,不是寫法,這次的組合條件也能得到要求的結果。
執行器另外比對追蹤檔案的 SHA-256:第一次呼叫只有測試檔變動,第二次只有 Domain 變動。這是檔案最終內容的事後核對,不是作業系統沙箱,也不能證明執行途中從未改過又還原。
既有實驗還有一組對照:同樣的起點與規格,允許 Claude 一次修改測試和 Domain。它也交出七項通過的結果。
我把那組產生的測試抽出來,放回舊 Domain,再跑一次,SC-03 確實失敗。這表示至少在本案例中,一次完成也能產生抓得出舊行為的測試,不能因為它同時寫了程式與測試,就認定結果不可信。
| 既有實跑 | 最終內容改變的檔案 | 如何核對測試有效? |
|---|---|---|
| 寫測試那次 | 測試檔 | 對舊 Domain 執行,SC-03 失敗 |
| 改程式那次 | Domain | 同一套測試七項通過,測試檔雜湊不變 |
| 一次完成組 | 測試檔與 Domain | 將新測試放回舊 Domain,確認 SC-03 失敗 |
拆成兩次能先留下新測試對舊行為失敗的紀錄;一次完成則可以事後交叉核對。兩種方式都有檢查成本。本次各只有一次對照,不能據此說哪種普遍更快,更不能宣稱多一道流程一定值得。
Anthropic 的應用開發實驗,也把實作與評估分工,讓實際操作結果回到下一輪;但隨模型能力提高,又移除了部分不再必要的流程。值得借鏡的是持續核對哪些檢查有用,而不是把整套多 agent 架構照抄過來。Anthropic 工程實驗
OpenAI 公開的內部開發經驗,則把應用啟動、介面、日誌與指標提供給 agent,讓它能驗證修正。這是特定環境投入後的經驗,並非裝好工具就會自動成立。OpenAI 工程經驗
今天這個小任務,不需要先成立一支 agent 團隊。先讓一份提案能被套用、檢查與退回,就已經走出只等一句「完成了」的開發方式。
前面花時間約定「怎樣才算完成」,到這裡才真正派上用場。我想接起來的是:提出修改 → 執行檢查 → 回傳結果 → 修正或停止。
控制理論管這叫閉環:輸出被量測之後回頭調整下一次輸入,而不是做完就結束。以下稱回饋迴路。
回饋迴路的關鍵,是讓它拿得到結果,也知道結果代表什麼。 完成條件決定何時可以結束這輪工作;可執行的檢查讓它知道哪裡沒做好;明確的修改範圍與停止條件,則決定哪些失敗可以繼續修、哪些問題必須交回人。
在事先允許的範圍內,修改、測試與回饋可以接著走,不必每一步都等人說「繼續」。工具操作仍依授權設定執行;需要改需求、擴大權限或接受核心風險時,仍然要停下來。本機檢查通過,也不代表 PR 已獲准合併。
這裡開始是另一套實驗,原件也分開放。 上面那兩次呼叫留在 runs/tests 與 runs/impl:各做一件事、由我在中間轉貼結果。接下來這四次留在 runs/feedback-loop-*:同一個起點,但失敗結果由程式自動送回去。
這次要改變的是:失敗結果由程式送回,不再等人轉貼。原執行器遇到實作測試失敗就停止,它不會把失敗自動送回下一次,所以這次另外補做了一個小型 runner;下面講的「輪」都是指這條回饋迴路內部的重試次數。
它沿用「新測試+舊 Domain」快照,不覆蓋前面的原件。
怎麼改、怎麼驗,分工是這樣: Claude 讀規格與失敗結果,提出 Cancellation.cs 的修改;執行器把它套進指定檔案,執行七個測試,再核對修改範圍。情境失敗就把實際輸出交回 Claude;通過就留下 diff 與測試紀錄。需要改規則或用完三輪,就停下來交給人決定。
實際執行順序如下:
src/Domain/Cancellation.cs,再跑測試。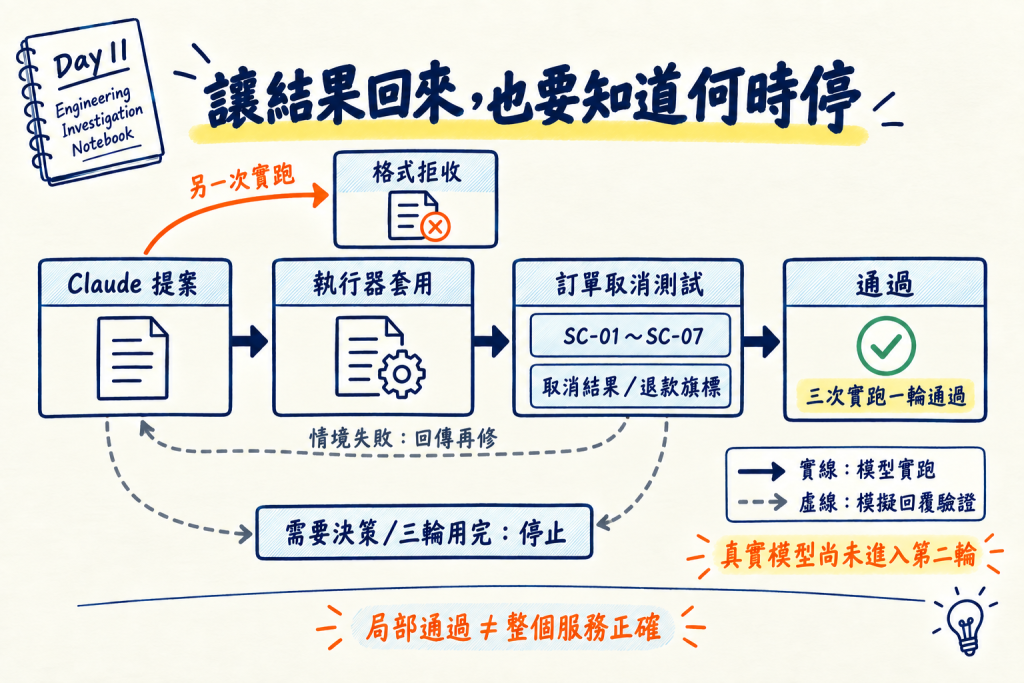
這次 Claude 只有讀取與搜尋工具,不能直接寫檔,也不能跑命令,它回傳 JSON 提案,由程式套用與檢查。讀者平常也可以讓 Claude Code 直接執行測試;這裡把寫入與測試留在外層,是為了讓「誰做了什麼」在紀錄上分得開,出事時才查得出是提案錯了、還是套用錯了。
第一次真的跑,先卡在另一個地方:Claude 在 JSON 前面加了一段說明,解析器拒收,程式尚未套用。修正為可接受一個明確的 JSON 程式區塊後,另開新目錄重跑。
修正解析器後重跑,Claude 第一輪修改就通過七項檢查,測試與規格保持不變。
回到開頭說的那件事。回饋迴路的賣點是「失敗了會自己再修一次」,但上面那次一輪就過了。沒有失敗過的失敗分支,等於沒驗過。 所以我又跑了兩次,一次比一次難:
| run | 驅動模型 | 拿掉什麼 | 輪數 | 費用 | 結果 |
|---|---|---|---|---|---|
feedback-loop-01 |
sonnet | 無 | 1 | $0.0955 | INVALID_PROPOSAL(解析器拒收,不是模型錯) |
feedback-loop-02 |
sonnet | 無 | 1 | $0.1072 | CHECKS_PASSED |
feedback-loop-haiku-01 |
haiku | 無 | 1 | $0.0386 | CHECKS_PASSED |
feedback-loop-nospec-01 |
haiku | rules-v2.md、plan.md |
1 | $0.0326 | CHECKS_PASSED |
第三次我換成小很多的模型,想看它會不會第一輪寫錯。沒有。第四次我把規格檔和計畫檔直接從工作副本刪掉,只留紅燈與程式,模擬「維運現場只有一個失敗訊息」。還是一輪就過。
能比的只有最後兩列,同一個 haiku,只差有沒有規格:模型回合(一次 run 之內模型來回的次數,不是上表的輪數)從 9 掉到 4,費用從 $0.0386 掉到 $0.0326;工具呼叫從 8 次(6 次 Read、2 次 Glob)降到 3 次,三次全是 Read,沒有一次 Glob。沒有規格可翻,它就不翻了,直接讀測試。(前兩列是 sonnet,而且 feedback-loop-01 是解析器拒收,模型與條件同時不同,不能跨列相減。兩邊也各只有一次,這是一組觀察,不是「抽掉規格比較省」的結論。)
拿掉規格還能一輪過,我原本以為是模型在猜。核對 trace 後,發現它只讀了三個檔:測試、Domain、CLAUDE.md。然後看它產出的註解:
// 已取消的訂單再次取消不重複處理(BR-04)
// 已付款的訂單取消時提出退款要求(spec v2 BR-03)
規格檔已經被我刪掉了,BR-03、BR-04 這些編號它是從哪裡看到的?答案在測試檔:
// SC-03|BR-03(改)|Given 已付款、未出貨、未取消|Then Cancelled=true、RefundRequested=true
// SC-07|BR-04(新)|Given 未出貨、已取消、已付款|Then 原訂單、RefundRequested=false(不重複退款)
七個情境的每一格都帶著規則編號、Given 與 Then。這份測試檔本身就是一份規格。 所以「只給紅燈」根本沒有藏住任何東西,紅燈連答案一起遞過去了。
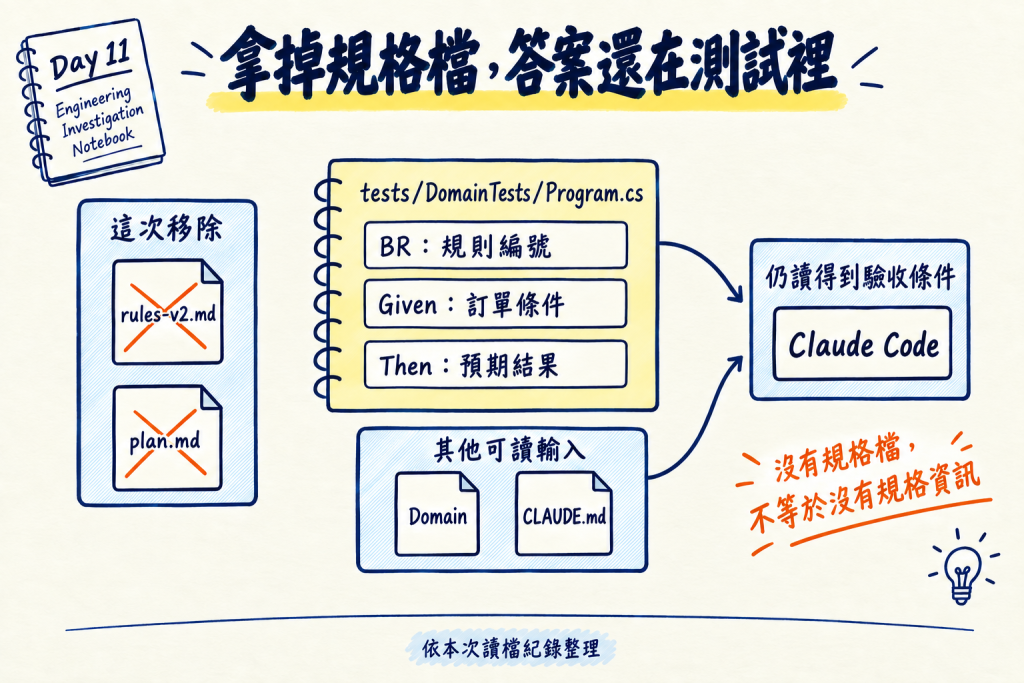
這回頭解釋了 Day 6 那件事:把驗收條件寫到這個程度,規格文件對實作者就變成可有可無。好處是交付門檻很清楚;代價是我以為自己在做一個盲測,其實沒有。要真的測失敗分支,得換一個大到單靠測試講不完的任務,那不是今天這個範圍。
那三個分支(失敗回傳、三輪停止、需要人判斷)是以模擬回覆加真實 .NET 執行驗過的,驗的是執行器,不是模型。
使用本篇實作包,需要 Python 3、.NET 9 SDK。只想看紅綠,不必呼叫模型;從包的根目錄開始:
cd runs/tests/snapshot
dotnet run --project tests/DomainTests
cd ../../impl/snapshot
dotnet run --project tests/DomainTests
第一個命令預期 SC-03 失敗、退出碼 1;第二個七項通過、退出碼 0。兩份是獨立快照,不用覆蓋檔案來猜修改前的樣子。
要讓 Claude 重新提案,回到實作包根目錄,確認 Claude Code 已安裝並登入:
python run-feedback-loop.py reader-loop-01 --max-rounds 3
想自己試試看能不能逼出第二輪,可以換小模型或把規格抽掉:
python run-feedback-loop.py reader-loop-02 --model haiku --withhold "specs/rules-v2.md,plan.md"
這會消耗模型用量,結果不保證相同。使用未用過的名稱,執行器會建立 runs/reader-loop-01,保留輸入、回覆、diff、測試輸出與 report.json。看最後的 status:CHECKS_PASSED 是本機檢查通過;NEEDS_DECISION 或 ROUND_LIMIT 則表示要停下來處理。
換成自己的工作時,先挑一個範圍小、驗收條件清楚的修改。把規格位置、可改檔案、檢查命令與停止條件一起交付。不要直接把示範的路徑、七項情境與三輪上限當成所有專案的標準。
main 不等於功能已合併。我想交出去的,不只是打字的工作,也包括那些已有判準、可以反覆檢查的修正。但七個領域情境通過,只表示訂單取消邏輯在這些輸入下符合預期。
明天把同一個旗標送過 API:取消邏輯算出的 RefundRequested 是 true,打一次 HTTP 請求出去,回應裡還是 true 嗎?
參考資料:
本文實作說明
教學訂單固定快照 885e521;開發證據包 examples/sdlc-development。同一服務的歷史快照與維運主入口分開保存,不將不同版本當成同一輪實跑。rules-v2.md 是教學規則,未串真實金流。
既有 runs/tests:SC-03 失敗;runs/impl:七項通過;runs/combined-01:一次產生測試與實作、七項通過;runs/crosscheck-01:兩套測試各放回舊 Domain,皆抓到 SC-03。既有三次模型呼叫採 sonnet、medium effort、讀寫工具、不提供 Bash,由外層測試。
回饋迴路實跑四次(2026-09-22/09-24),全部保留、未挑選;條件與結果見正文表格,每次的 prompt、trace、diff、測試輸出與 report.json 在各 runs/feedback-loop-* 目錄。模型工具皆為 Read/Grep/Glob,外層僅寫入 Domain。解析修正前後與不同模型之間各只一次,不構成成功率或能力比較。
圖表界線:工作類型表為本文整理,非官方分類;雜湊表的檔案範圍依最終內容比對,不單靠雜湊判斷測試有效;抽掉規格仍一輪通過,不能證明開發不需要規格;三輪是教學上限,通過範圍僅限七個領域情境。
test-feedback-loop.py 使用模擬模型回覆與真實 .NET 檢查控制流程;紀錄為 runs/feedback-loop-02/controller-tests.txt。它驗的是執行器的失敗回傳與停止邏輯正確,不得當成 Claude 多輪修復證據。
本篇開發與驗證為 AI/程式操作,人工分鐘未知。未證明省時、團隊減載、Owner 接受、API/通知/並行行為或正式部署。檔案檢查與唯讀工具配置不等於完整作業系統隔離。
新增 worktree 驗證:examples/day11-worktree-lab/run-01/evidence 保存 prompt、trace、diff、三次測試輸出、分支 commit 與 report.json。Claude 實際修改、程式執行測試及本機提交;不是人工 Review 或 main 合併。
官方文件與工程經驗
claude -p、工具白名單及結構化紀錄選項。實作附件
run-feedback-loop.py、四次 run 的完整紀錄、兩份快照)隨本文同日上架於 day-11/。

 iThome鐵人賽
 看影片追技術