

前言
在 Day 10 中,我們設計了針對高頻存取優化的 PostgreSQL 綱要,並在 Day 14 建立了具備 JWT 認證的 Express 後端服務。現在,系統的核心問題來了:如何將資料庫撈出來的關聯資料列(Row),乾淨、無失真且符合規範地轉換成國際標準的 HL7 FHIR Resource?
直接在 SQL 查詢或 API Controller 裡硬寫字串拼接或物件映射,會導致程式碼高度耦合、無法抽換且難以進行單元測試。
今天我們將採用經典軟體設計模式——轉接器模式(Adapter Pattern),在 Node.js (TypeScript) 中實作轉換管線,將 PostgreSQL 內部的 patients 資料列轉譯為合規的 FHIR Patient,並進一步封裝成標準批次傳輸載體——FHIR Bundle (collection / searchset)。
一、轉接器模式(Adapter Pattern)在醫療資訊的角色
轉接器模式的核心精神在於:讓介面不相容的兩個物件能夠協同工作。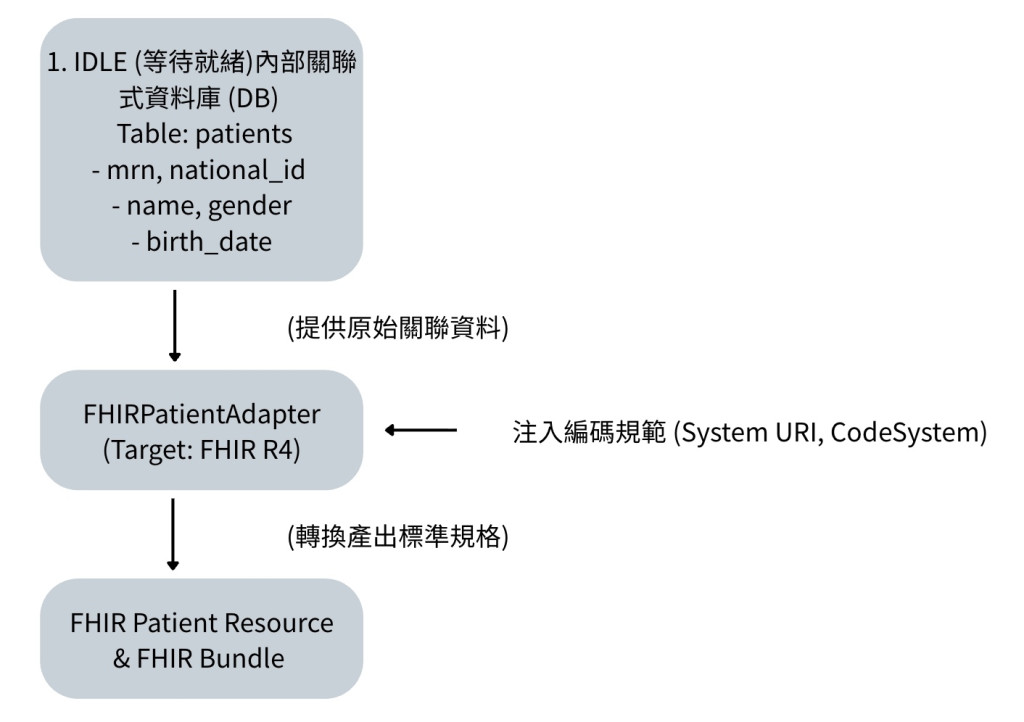
-Adaptee(內部資料庫實體): 欄位扁平、命名符合關聯式資料庫慣例(snake_case)。
-Adapter(轉換器): 負責補足醫療語意(如 LOINC/HL7 代碼系統 URI、多重識別碼物件構建、人類可讀摘要生成)。
-Target(FHIR Client / 外部系統): 僅需要面對符合 HL7 FHIR R4 規格的標準 JSON。
二、型別定義:內部實體與 FHIR 資源規格
建立型別檔案 src/types/fhir.types.ts: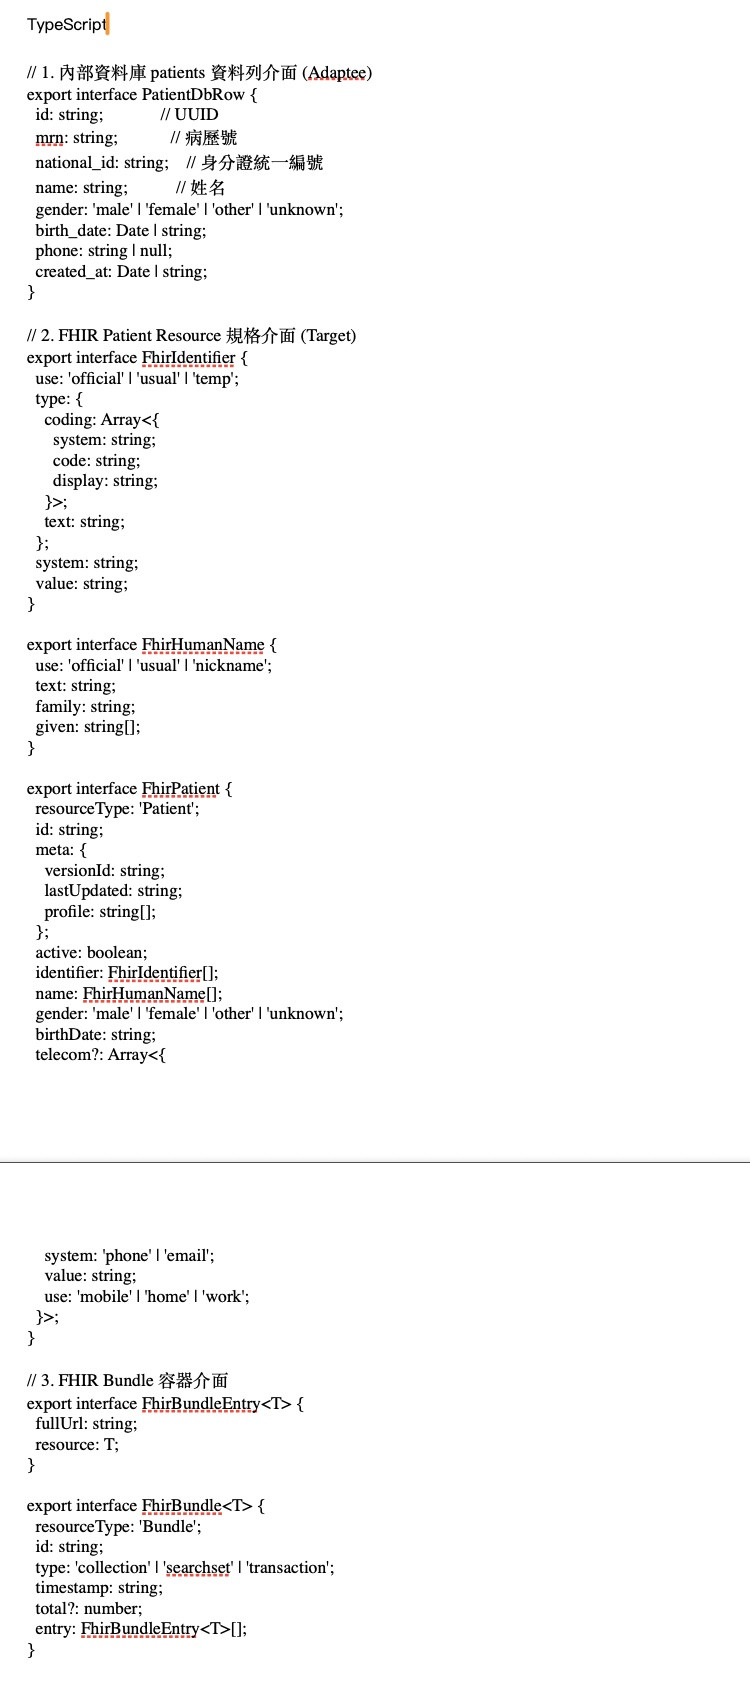
三、實作 Patient Adapter 轉換器
建立 src/adapters/fhir-patient.adapter.ts。這個類別專注於單一職責:將 DB 列映射為 FHIR Patient。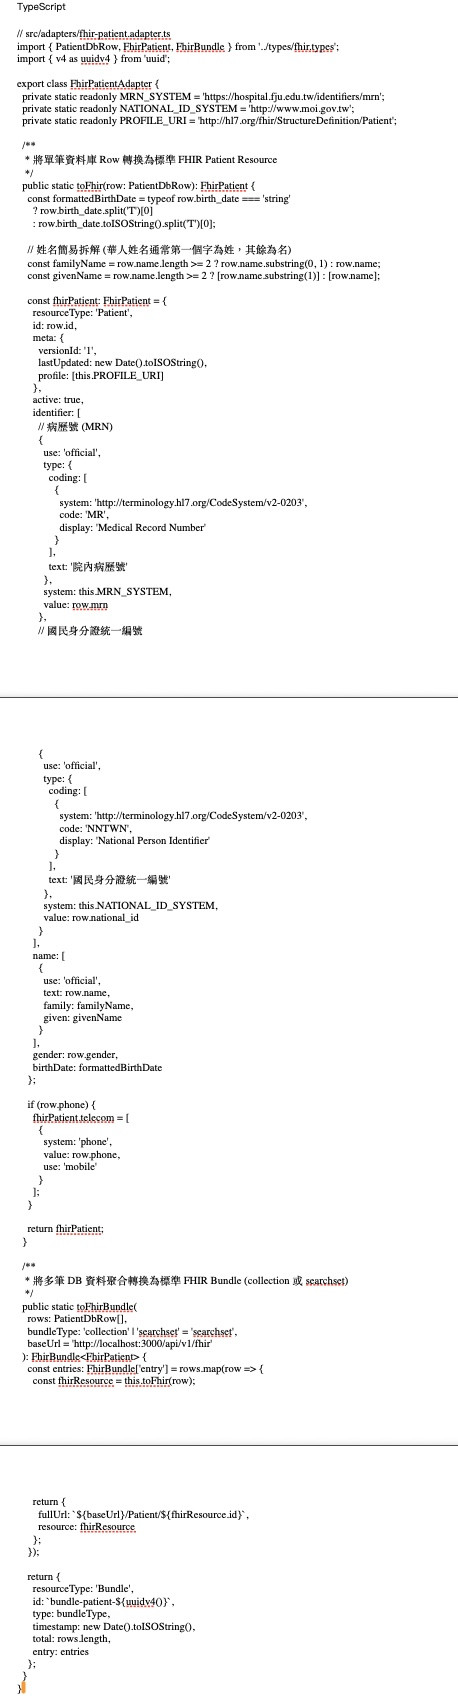
四、整合至 Express API 端點
在 Controller 層,我們從 Repository 撈出原始資料後,直接調用 FhirPatientAdapter 產出標準格式。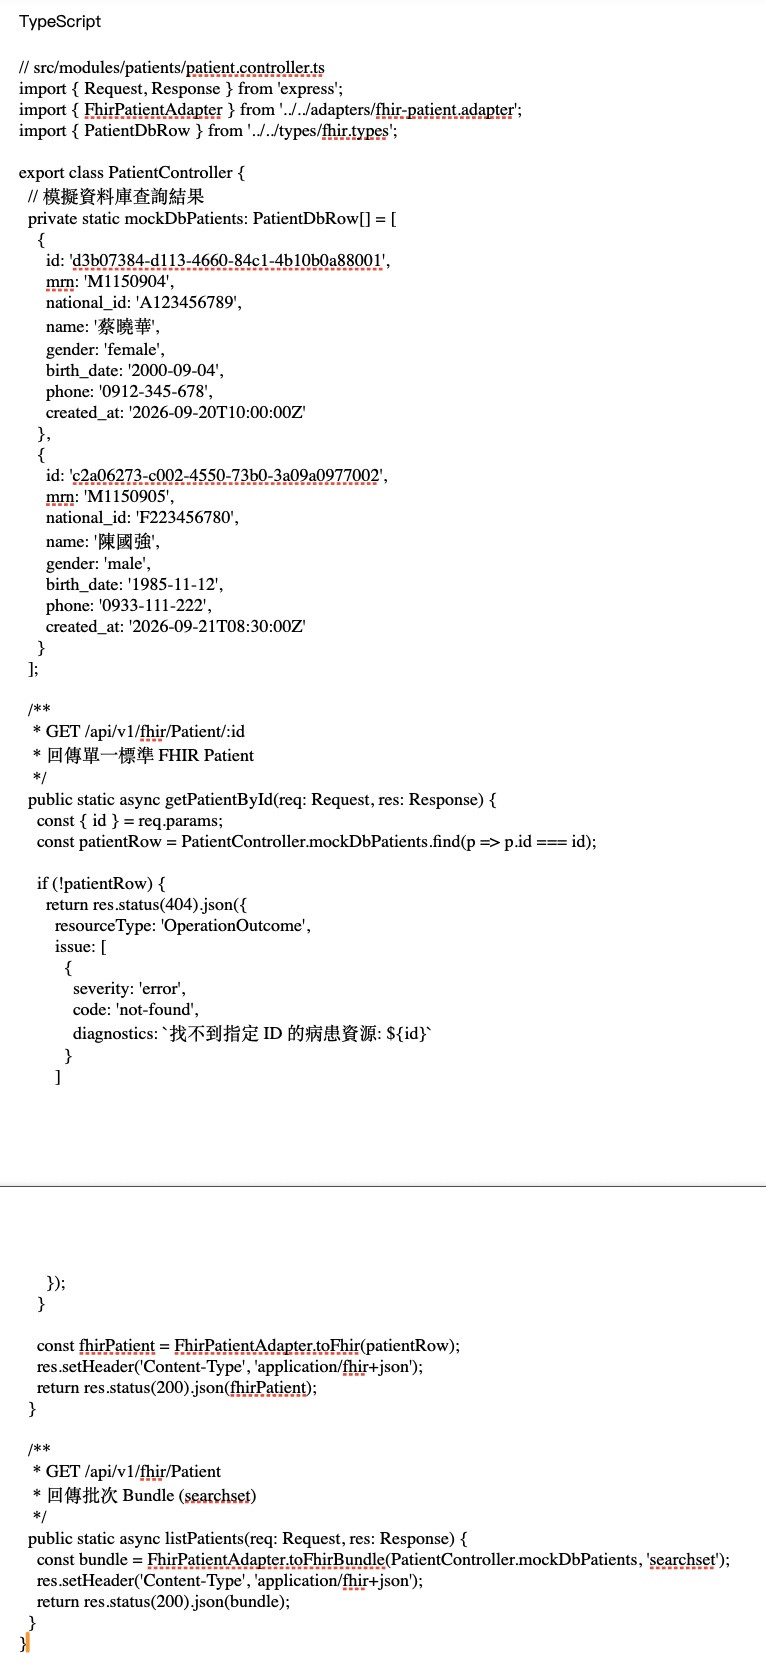
五、單元測試驗證(Jest 測試案例)
建立測試檔案 tests/adapters/fhir-patient.adapter.spec.ts,驗證轉接器的輸出結構合規性: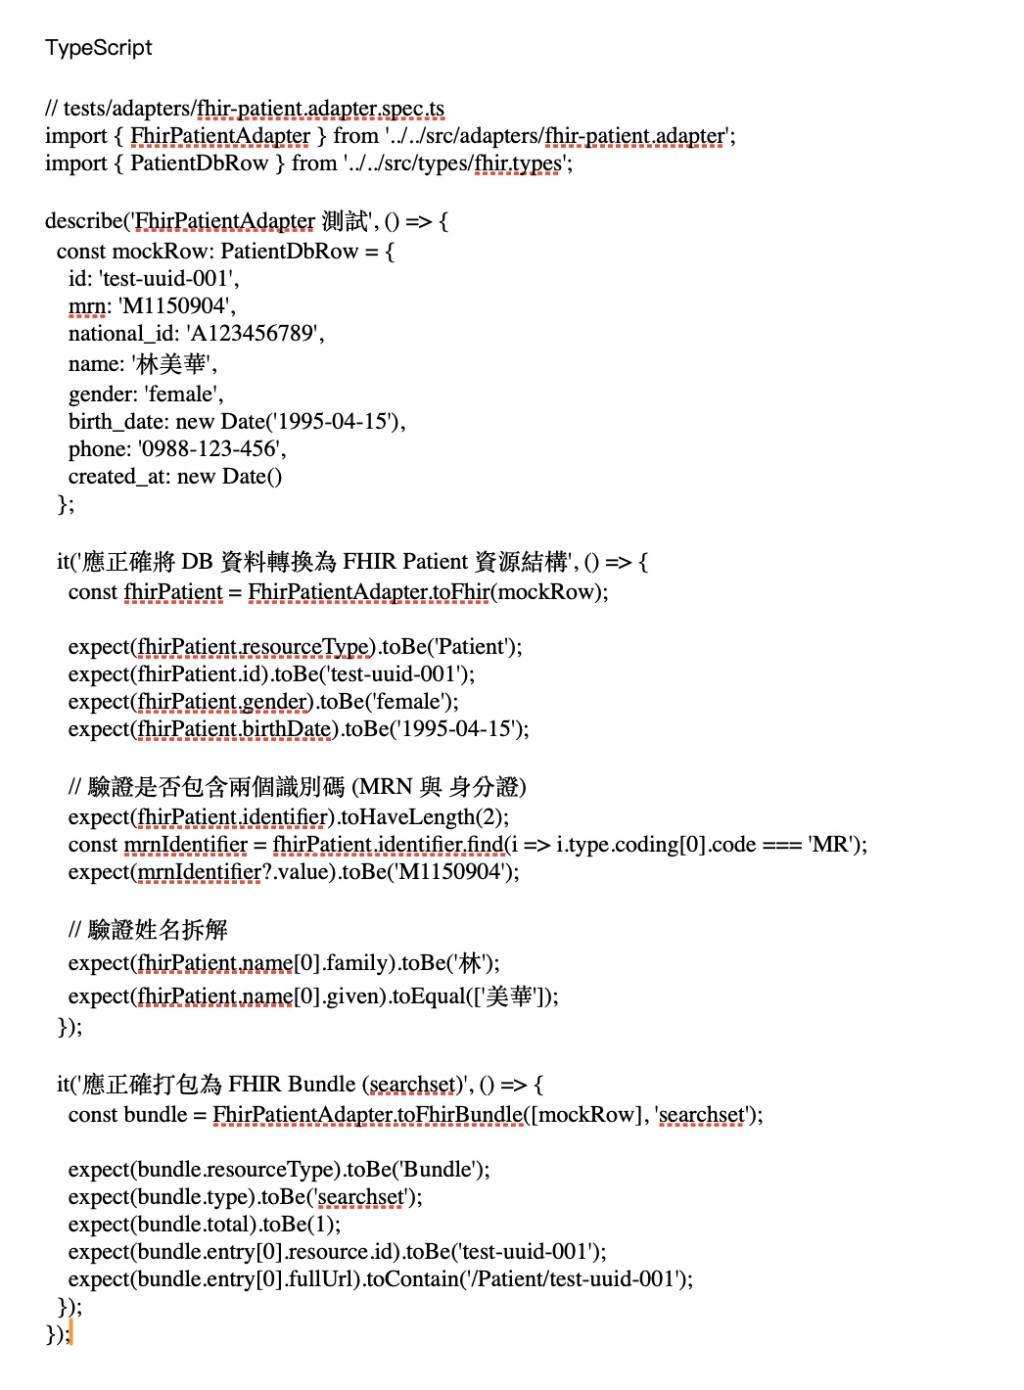
小結
今天我們成功在後端建立了關鍵的資料轉譯管道:
1.運用 Adapter Pattern 將內層資料表結構與外層標準交換規範完全解耦。
2.補足了病歷號(MRN)與臺灣國民身分證(NNTWN)在 FHIR 體系下的標準 CodeSystem 與 Namespace。
3.實作了批次打包容器 FHIR Bundle (searchset),並完成自動化單元測試。
有了這個標準轉換層,明天 Day 16 我們將推進至系統的核心量測作業:實作即時生命徵象上傳 API——支援批次寫入、關聯式更新與 FHIR Observation 封裝!


 iThome鐵人賽
 看影片追技術