
每張訂單的截止時間都不同,截止時間一到就要自動結算,因此需要的是「到指定時間執行一次」,而不是固定週期掃描資料庫。
最初做了第一版,使用 JDK 的 DelayQueue,每個任務實作 Delayed,由 getDelay() 計算距離截止時間還剩多久;消費端則用 take() 等待任務到期:
while (...) {
    OrderSettlementTask task = queue.take();
    orderService.settleOrder(task.getOrderId());
}
這種作法把事情想得很簡單,不用輪詢,也不需要額外服務。
DelayQueue 裡的任務只存在目前這個 JVM 的記憶體中。資料庫裡的訂單還在,但 JVM 一旦重啟,原本排好的任務就會消失。最直接的補救方式,是啟動時從 DB 找回 OPEN 訂單重新排程:
@PostConstruct
public void init() {
    recoverFromDb();
    startConsumer();
}
單機可以這樣處理,但多機環境又產生新的問題,每台機器都會執行 recoverFromDb(),因此同一張訂單可能同時進入兩台 JVM:
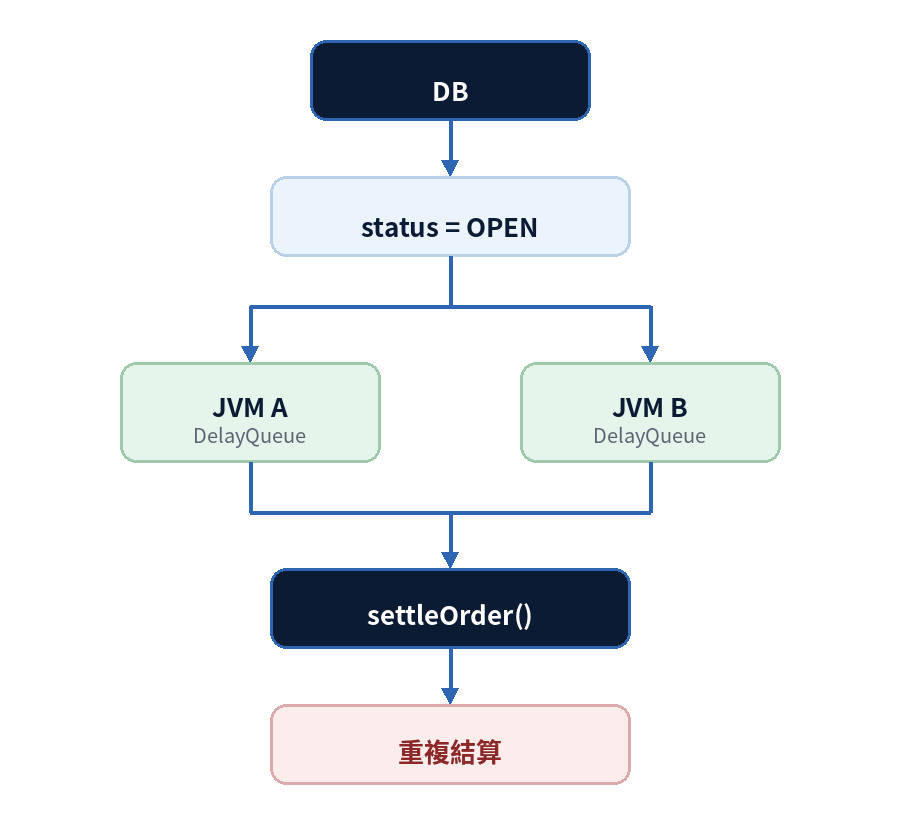
即使 settleOrder() 有先檢查 status == OPEN,兩台機器仍可能同時讀到 OPEN,再各自執行後續更新。因此,延遲任務不能只存在某一台 JVM 裡。
既然延遲任務不能只存在單一 JVM,就需要把排程資訊放到所有 JVM 都能存取的地方。
Redis Sorted Set 可以把每筆任務存成「訂單編號+截止時間」:orderId 作為任務的識別,deadline 則作為排序依據,這樣就能依截止時間找出已到期的訂單,也能在訂單取消時,根據 orderId 移除排程。
double score = deadline.atZone(ZoneId.systemDefault()).toInstant().toEpochMilli();
redisTemplate.opsForZSet().add(KEY, orderId, score);
redisTemplate.opsForZSet().remove(KEY, orderId);

redisTemplate.opsForZSet()
    .rangeByScore(KEY, 0, nowEpochMs, 0, 10);
這裡不再需要原本存在 JVM 裡的 OrderSettlementTask ,訂單的 deadline 作為 Redis 的排序依據,所有 JVM 都能讀取同一份排程,也不需要在啟動時各自重新建立 queue。
但共用同一份排程,不代表同一筆任務只會被一台機器處理。
假使訂單 ord-001 到期後,JVM A 和 JVM B 都可以從 Redis 查到這筆訂單。如果兩台機器同時開始結算,就可能讓同一筆訂單被處理兩次。
這也是 Redis 版本還沒解決的問題:「任務放在哪裡解決了,但誰可以拿走任務,還沒有解決。」兩台機器仍可能讀到同一批訂單。
所以這次只解決了一半,下一篇再處理任務認領。


 iThome鐵人賽
 看影片追技術