
錯誤計數器讀到 0,不一定代表沒問題:它可能才剛開始累計,也可能那個 port 根本沒有流量經過。今天整理判讀計數器的順序,再用已知數量的封包驗證 7150 數得對不對。
計數器從開機,或上一次 clear counters 之後開始累計。沒有時間基準的累計值無法比較,所以每次讀數都要連 show version 的 Uptime 一起記:

這台 52 個 port 的 InOctets 幾乎整排是零,但零有四種:
| 實際狀況 | Status | Type | 錯誤計數器 |
|---|---|---|---|
| 沒有模組 | notconnect |
Not Present |
0 |
| 模組在,link 沒起來 | notconnect |
10GBASE-CR |
0 |
| link 起來了,對端沒送東西 | connected |
10GBASE-CR |
0 |
| 收到過,但收到的是壞的 | connected |
10GBASE-CR |
不是 0 |
每一列跟上一列只差一個欄位,只看 InOctets 分不出來。Status 跟 Type 來自 show interfaces status:
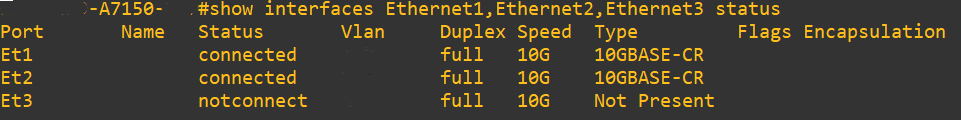
最後一種出現在 Et2:
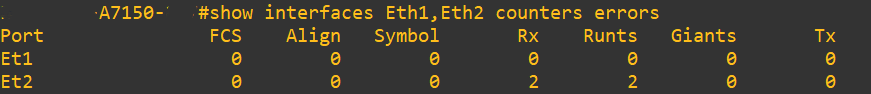
Et2 的 RX 錯誤總數跟 Runts 都是 2,兩個都是 runt(比 64 bytes 短的 frame)。這台的 runt 不算進 InOctets,所以那欄一直是 0。
這兩個 runt 在 link 起來後的第一次讀數就出現,之後沒再增加。link 起來之前收不到 frame,所以它們是 link 建立那一刻進來的,最可能的成因是對端主機開機。
這個 VLAN 只有 Et1 跟 Et2,兩個 port 都沒收到多播,卻一直往外送,所以這些多播是交換器自己發的。Et1 的讀數如下(Et2 幾乎一樣):
| 項目 | Et1 |
|---|---|
| 平均間隔 | 1.875 s |
| 平均一個 frame | 72.6 bytes |
| 平均速率 | 310 bit/s |
從間隔可以反推每 2 秒一個加上每 30 秒一個,平均間隔正好是 1.875 s。2 秒是 spanning-tree hello 的預設週期,30 秒是 LLDP 的。兩個 port 都設了 portfast,但 portfast 只加快 port 進入 forwarding,BPDU 照送。
這是從節奏推出來的,STP 跟 LLDP 各佔多少 bytes,計數器分不出來,要確認得抓封包。
310 bit/s 對 10G 可以忽略,但這些 frame 跟量測封包走同一個出口。當量測封包剛好碰上交換器在送 BPDU,就得等它送完,那一筆會偏高。頻率很低,只會影響 max,中位數不會動。
送一批知道數量的封包,讀數相減,看計數器數得對不對:
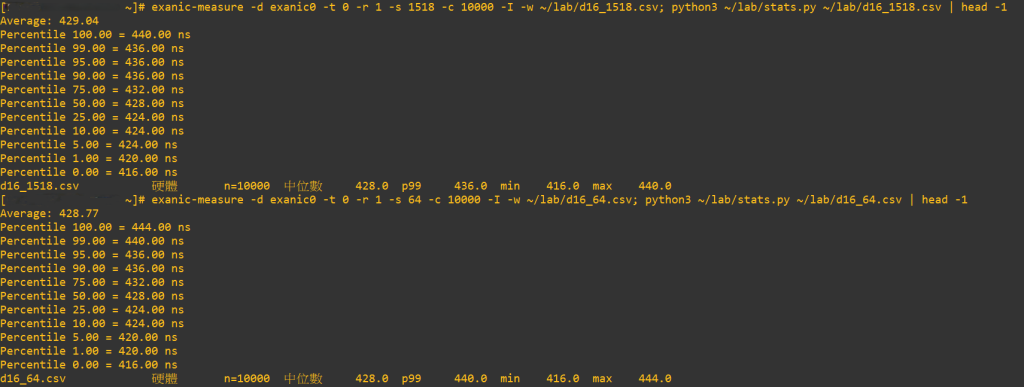
exanic-measure -d exanic0 -t 0 -r 1 -s 1518 -c 10000 -I -w ~/lab/d16_1518.csv
exanic-measure -d exanic0 -t 0 -r 1 -s 64   -c 10000 -I -w ~/lab/d16_64.csv
兩發的中位數都是 428.0 ns,跟 Day 6、Day 15 一樣(未扣網卡與線材的原始值)。交換器跟伺服器都重開過,這個值沒動;1518 減 64 是 0 ns,這台還在跑 cut-through。
| 欄位 | 讀到的 |
|---|---|
Et1 InBcastPkts |
20,000 |
Et2 OutBcastPkts |
20,000 |
Et1 InOctets |
15,820,000 |
| 兩個 port 的 discards | 0 |
| Et1 的錯誤計數器 | 0 |
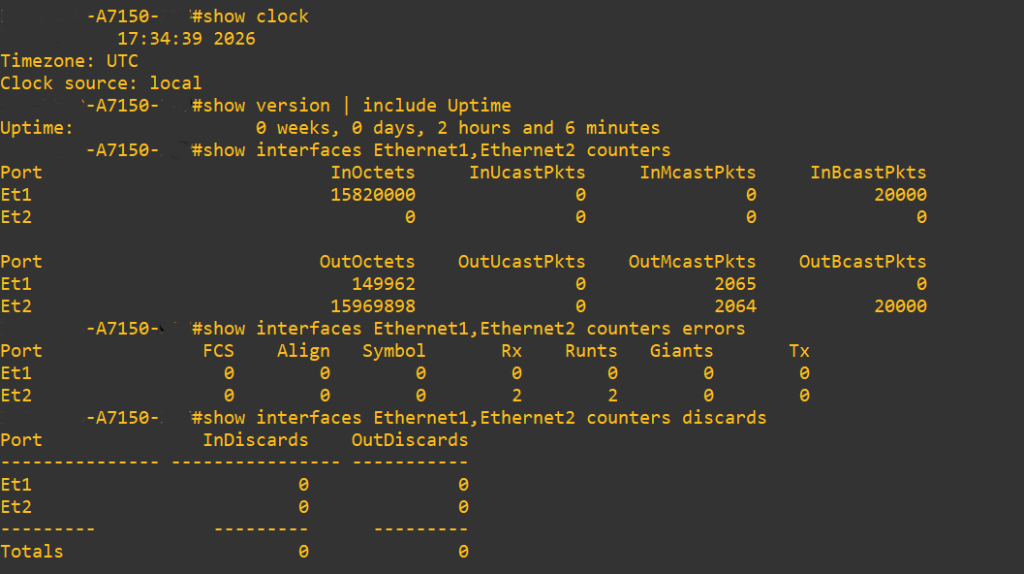
10,000 × 1518 + 10,000 × 64 = 15,820,000,對到個位數。frame 長度含 FCS,所以 InOctets 數的是 Day 9 表格「純 frame」那一欄,preamble、SFD、IFG 那 20 bytes 不算。拿 InOctets 算線路使用率,64 bytes 的封包會少算 24%。
exanic-measure 送的是廣播,所以落在 Bcast 欄;交換器不會把廣播送回進來的 port,Et1 的 Out 沒有這兩萬個。
量延遲的 port 流量控制要關,否則任何一端送 pause frame,延遲裡就會多一段跟轉發無關的等待。
show running-config 只列跟預設值不同的設定,關著的時候看不到這項,要用 show interface flow-control 確認:
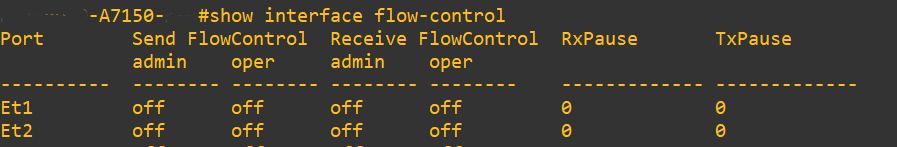
Et1、Et2 的 send 與 receive 在 admin 跟 oper 都是 off,RxPause、TxPause 都是 0。admin 是設定值,oper 是實際生效的狀態,兩欄都 off 才算確認。
| 順序 | 讀什麼 | 少了它會怎樣 |
|---|---|---|
| 1 | Uptime | 所有累計值沒有分母 |
| 2 | Status 與 Type | 四種零分不出來 |
| 3 | 錯誤計數器 | 壞掉跟被丟掉的 frame 看不到 |
| 4 | 總量計數器 | 不知道這條路上有沒有東西在跑 |
前兩層不是計數器,但後兩層的數字算不算數由它們決定。
兩次讀數能不能相減:
| 條件 | 判定 |
|---|---|
| 這次的 Uptime < 這次時刻 - 上次時刻 | 中間重開過,差值作廢 |
| 有計數器比上次小 | 中間被清過,差值作廢 |
| 以上都不成立 | 相減有效 |
跨過重開的相減,差值沒有意義,重開前累積的錯誤也會一起消失,這台看起來就跟健康的機器一樣。重開用 Uptime 就抓得到;clear counters 比較麻煩,清完又長超過上次的話,只看計數器分不出來,所以清計數器要寫進變更紀錄。
記基線時,每一次讀數都連同當時的 Uptime 跟時間一起記,下一次讀才算得出這段期間的變化。
明天把錯誤計數器一個一個拆開,講 FCS、runts、discards 各自代表什麼,Et2 那兩個 runt 就是現成的例子。


 iThome鐵人賽
 看影片追技術