
Day 16 把 Et2 的兩個 runt 歸到對端主機開機。今天先把交換器的錯誤欄位逐一對上它代表的故障,再用四種 link 事件去重現那兩個 runt。先講結論:十次事件做下來,runt 沒有再增加。
show interfaces 的詳細輸出把錯誤拆得比 counters errors 細:
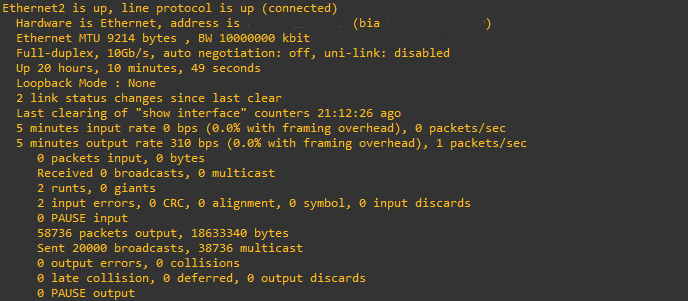
| 欄位 | 意思 | 常見成因 | Et2 |
|---|---|---|---|
| CRC | 收完整個 frame,FCS 驗不過 | 線材、光模組、接頭、對端 PHY | 0 |
| alignment | frame 的位元數不是 8 的倍數,而且 FCS 也錯 | 實體層訊號 | 0 |
| symbol | PHY 解出不合法的編碼 | 線材、模組、干擾造成的訊號品質問題 | 0 |
| runts | 比 64 bytes 短的 frame | 對端網卡或驅動送出不完整的 frame | 2 |
| giants | 比 MTU 大的 frame(這台是 9214 bytes) | 兩端 MTU 設定不一致 | 0 |
| input discards | 收進來但在入口被丟掉 | 入口資源不足、VLAN 不符等 | 0 |
| output discards | 出口佇列滿了被丟掉 | 擁塞,例如 microburst | 0 |
| PAUSE input/output | 收到或送出的 pause frame | 流量控制開著 | 0 |
counters errors 的 FCS 對應這裡的 CRC,Rx 對應 input errors,Et2 的 Rx 跟 input errors 都是 2。collisions、late collision、deferred 是半雙工留下來的欄位,10G 只有全雙工,出現非零值就是異常。
Day 16 的推論是:「link 起來之前收不到 frame,所以它們是 link 建立那一刻進來的,最可能的成因是對端主機開機。」照這個推論,link 重新建立,runt 就應該再長出來。今天做了四種 link 事件:
| link 事件 | 次數 | Et2 的 link status changes | Et2 的 runt |
|---|---|---|---|
伺服器端 ip link down/up |
3 | 2 → 8 | 2 → 2 |
| 實體拔插 DAC | 3 | 8 → 14 | 2 → 2 |
交換器端 shutdown/no shutdown |
3 | 14 → 20 | 2 → 2 |
| 伺服器關機再開機 | 1 | 20 → 22 | 2 → 2 |
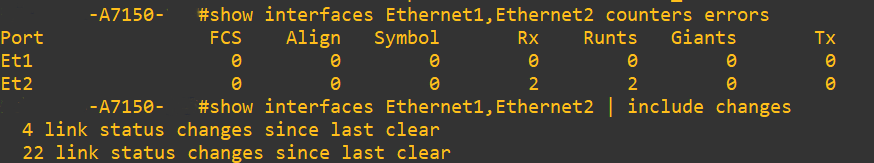
link status changes 每次斷線再接回加 2(一次 down、一次 up),十次加了 20,每次都確實斷過;CRC、alignment、symbol 也一直是 0。
關機再開機那次也沒有多出 runt。不過 Day 16 那次是交換器跟伺服器都重開過,今天的四種事件都沒有重開交換器,冷開機也只動伺服器端一次。十次都重現不出那兩個 runt。
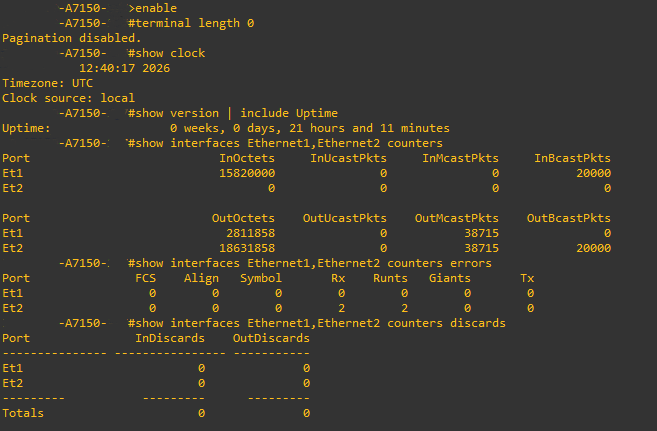
Day 16 到今天第一組讀數之間,Uptime 對得上、沒有重開過,錯誤欄位都沒有增加,這就是這條鏈路健康時的基線:
show interfaces 還有一行 Day 16 沒用到:
Last clearing of "show interface" counters 21:12:26 ago
它是計數器上次歸零到現在過了多久,精確到秒。這台開機後沒 clear 過,所以跟 Uptime 一致;重開跟 clear counters 都會讓它重算。
Day 16 的判定抓不到一種情況:clear 之後,計數器又長得比上次讀數還大,光看計數器會以為沒被清過。Last clearing 這個時間可以補上,只要它比兩次讀數的間隔還短,就代表中間歸零過,這兩次讀數相減出來的增量不能用。
錯誤計數器看的是兩次取樣之間的增量。CRC 錯誤在 cut-through 下會往下游擴散,照 Day 11 那條,一增加就告警,查那一段的線材與光模組。其他錯誤欄位增加時,先對照同一段時間的 link 事件(link status changes、log)縮小嫌疑,再想辦法重現,重現得出來才算找到成因。
Et2 這兩個 runt 跟 link up 時間對得上、卻重現不出來,之後也沒再增加,這種就記錄下來繼續觀察;每次取樣都在增加的,就要查線材、模組跟對端。
取樣間隔決定事後能縮到多窄。 每分鐘取樣一次,要對照的就只剩那一分鐘的 log。
discards 今天一直是 0,一條 10G 進、一條 10G 出本來就塞不起來。門檻怎麼從這組基線推出來,是後面的題目。
明天看佇列:LANZ 怎麼在 discards 出現之前,就把 microburst 記下來。


 iThome鐵人賽
 看影片追技術