
前兩天講的是「驗證範圍不夠」和「指標會騙人」。
今天講更基本的一件事:綠燈本身就是假的。
那個案子在一次升級裡,遇到了三種不同的假綠燈。三種都不會報錯。
測試腳本的輸出長這樣:
A 專案 ✅ 全通過 0 0 42s
通過 0 條、失敗 0 條。
那不是全綠,那是一條都沒跑。
腳本的判定邏輯是「失敗數 = 0 就算通過」。而一條都沒跑的時候,失敗數當然是 0。真正的原因是:新版的測試框架會把元件初始化時拋出的錯誤重新丟出來,導致瀏覽器在第 39 條就斷線了。所以測試根本沒跑完,而腳本看到「失敗 0」就報綠。修法只有一行:
# ❌ 只看失敗數
[ "$fail" = "0" ] && echo 通過

# ✅ 先確認有跑
[ "$pass" -gt 0 ] && [ "$fail" = "0" ] && echo 通過
通則是:
判定「有沒有通過」之前,先判定「有沒有跑」。
「失敗 0」與「通過 N」是兩個獨立條件,必須同時檢查。
這條看起來很基本,但我敢說很多團隊的 CI 腳本都有這個洞。因為它只在「測試完全沒跑」的時候才會暴露,而那種情況不常發生。
不常發生,但發生的時候是最需要它報警的時候。
同一次升級,反過來的錯誤。
修好測試之後直接跑,得到 114/114 全部成功。
但腳本報:
A 專案 ❌ 編譯失敗 — — 6s Error: NG01203 … ★ 回歸!
原因是腳本的判定順序錯了:
# ❌ 原本:只要輸出含 ^Error 就判編譯失敗
if echo "$out" | grep -qE "^Error|error TS"; then res="編譯失敗"
而新版的設定語意正好是「把錯誤記到 console」。所以那行 Error: 一定會出現,跟「跑不跑得起來」完全無關。修法是改成先抓正向證據:
# ✅ 先找總計行
total_line=$(echo "$out" | grep -oE "TOTAL: ([0-9]+ FAILED, )?[0-9]+ SUCCESS" | tail -1)
if [ -z "$total_line" ] && echo "$out" | grep -qE "^Error"; then res="編譯失敗"
通則:
判定「跑起來了嗎」要看正向證據,不是看有沒有錯誤字串。
錯誤字串的存在,不等於失敗。這在現代的框架和工具鏈裡尤其真。很多東西會把警告、被吞掉的例外、甚至正常的診斷訊息,都印成 Error: 開頭。
第三種最嚴重,因為它揭露的是存在很久的真實缺陷。新版的測試框架開始把元件初始化的錯誤重新拋出之後,暴露了兩個問題:
| 缺陷 | 存在多久 |
|---|---|
測試替身的方法名寫錯——提供 show/hide,但真實服務是 startLoading/stopLoading,而元件呼叫了 153 次 |
從測試導入起 |
| 測試模組沒有提供 7 個服務的 token | 同上 |
測試呼叫的是一個不存在的方法,而測試通過了。
一百五十三次呼叫,全部打在一個不存在的方法上,一路綠燈。為什麼?兩個設計疊加。
一、用了服務定位器。 元件透過一個全域的注入器取得服務,這讓相依關係對編譯器隱形。型別檢查抓不到「替身的方法名寫錯了」。
二、舊版的測試框架只記錄不拋出。 元件初始化時的錯誤只被寫進 console,不影響斷言結果。兩個加起來的效果是:**錯誤被吞掉,而且沒有任何一層會告訴你。**通則:
測試替身的介面要與真實服務對齊,而這件事無法靠編譯器保證——
只要你用了服務定位器,或useValue: {...}這類繞過型別的寫法。
低成本的檢查方式是直接比對:
# 真實服務被呼叫的方法 vs 替身提供的方法,逐一對照
grep -rho "loadingSvc\.[a-zA-Z]*" --include='*.ts' src | sort -u
grep -n -A15 "class LoadingMaskStub" src/app/testing/test-support.ts
更好的做法是讓替身 implements 真實介面。那樣編譯器就會抓。這又是一次「把 advisory 推到 preventive」:靠人記得對齊 vs 靠型別系統強制對齊。
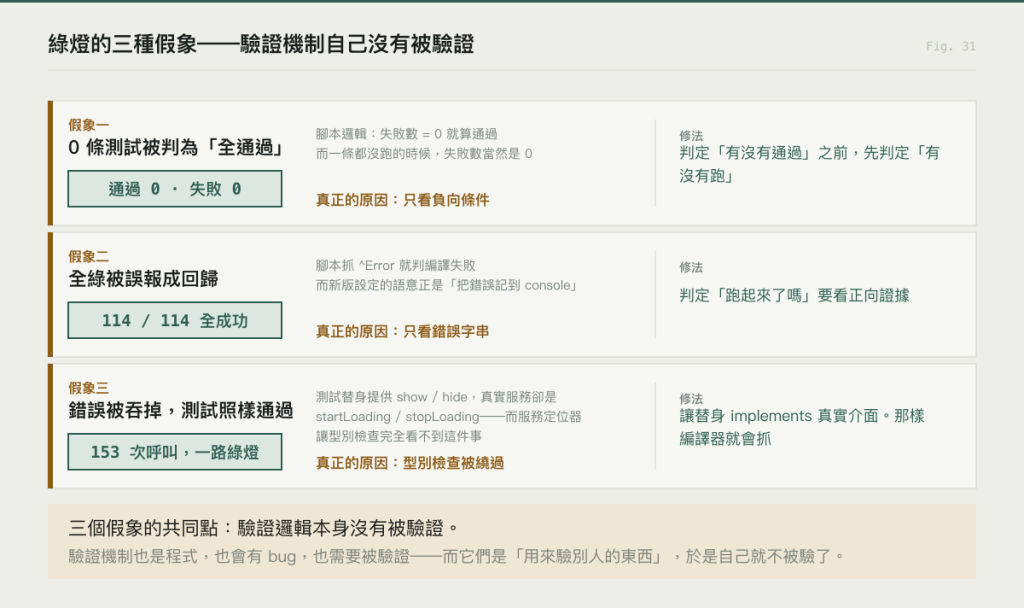
把三個放在一起:
| 假象一 | 假象二 | 假象三 | |
|---|---|---|---|
| 症狀 | 0 條被當全綠 | 全綠被當回歸 | 錯誤被吞、照樣綠 |
| 原因 | 只看負向條件 | 只看錯誤字串 | 型別檢查被繞過 |
| 共同點 | 驗證邏輯本身沒有被驗證 |
而那個回顧下的結論,我認為是整個 Part 4 最重要的一句:
驗證機制也是程式,也會有 bug,也需要被驗證。
我們花很多力氣確保產品程式碼是對的。測試、review、CI。但跑測試的那支腳本、算覆蓋率的那個工具、比對畫面的那支程式,通常沒有人驗。
它們是「用來驗別人的東西」,於是自己就不被驗了。
那個案子的做法是給每個驗證工具再配一個驗證動作:
| 驗證工具 | 怎麼驗它 |
|---|---|
| 動作日誌腳本 | 加一個 verify 子命令,檢查日誌完整性(缺核心階段或序號重複就退出) |
| 備份腳本 | 實際 clone 回來驗證,不是只確認檔案產生了 |
| CSS 修法驗證腳本 | 用四個對照情境驗證(基準/舊寫法/新寫法/舊 token),確認它分得出來 |
第二個我特別喜歡:備份不是「產生了一個檔案」,是「那個檔案真的能還原」。
多少團隊的備份是從來沒有還原測試過的?
第三個是明天的主題。用對照情境來確認你的驗證真的驗得出差別。
如果你想知道自己有沒有這個問題,我建議做一件事:
故意把某個東西弄壞,看你的驗證會不會紅。
Day 16 講 hook 的時候我提過「故意寫一個違規的檔案,看它會不會被擋下來」。這是同一件事,只是對象換成了驗證機制本身。三分鐘的事,但沒做的話,你可能整個專案都在「以為有防護」的狀態下運作。


 iThome鐵人賽
 看影片追技術