
上一集,我知道 wide transformation 會透過 shuffle 切出新的 stage。接著我想追一個更具體的問題:同一個 stage 裡,Spark 到底會建立幾個 task?把 local[2] 改成 local[32],究竟又會改變什麼?
這次我把 sample code 寫得很簡單,只改變來源 DataFrame 的 partition 數量,直接觀察和討論 task 與平行度的關係,最後也會跟大家分享一個我自己踩雷的案例(很白痴...)。
這次實驗固定使用 local[2],再分別建立 2 與 6 個 partition 的 DataFrame。三個數字各自回答不同問題:
| 概念 | 這次的數字 | 它回答的問題 |
|---|---|---|
| partition 數 | 2 或 6 | 資料被切成幾份? |
| task 數 | 2 或 6 | 這個 stage 有多少工作單位? |
local[2] |
2 | 最多同時執行多少個 task thread? |
對一個沒有 shuffle 的 stage,partition 與 task 的關係可以先簡化成:
一個 stage 的 partitions
  ↓
一個 partition 對應一個 task
  ↓
task 交給可用的 task thread 執行
partition 數決定工作能切成幾份;資源數決定其中幾份能同時處理。
實驗中的 where() 與 select() 都是 narrow transformation,不會改變既有 partition 的分布。唯一改變的是 spark.range() 建立資料時的 numPartitions:
from pyspark.sql import functions as F

C = F.col

numbers = (
    spark.range(1, 13, numPartitions=num_partitions)
    .where(C("id") % 2 == 0)
    .select(F.spark_partition_id().alias("partition_id"), "id")
)

rows = numbers.collect()
我用 spark_partition_id() 把每筆資料所在的 partition 一起印出,再用 collect() 讓 Spark 處理所有 partition。資料很小,collect() 在這裡只是觀察工具;真實的大型資料分析不適合把所有結果收回 Driver。
當來源有 2 個 partition 時,三筆偶數在 partition 0、另外三筆在 partition 1:
DataFrame partitions: 2
[Row(partition_id=0, id=2), ..., Row(partition_id=1, id=12)]
改成 6 個 partition 後,每個 partition 各有一筆偶數資料:
DataFrame partitions: 6
[Row(partition_id=0, id=2), ..., Row(partition_id=5, id=12)]
Spark UI 的 Jobs 頁面也留下同樣的結果:第一個 Job 是 2/2 tasks,第二個 Job 是 6/6 tasks;兩者都只有一個 stage。
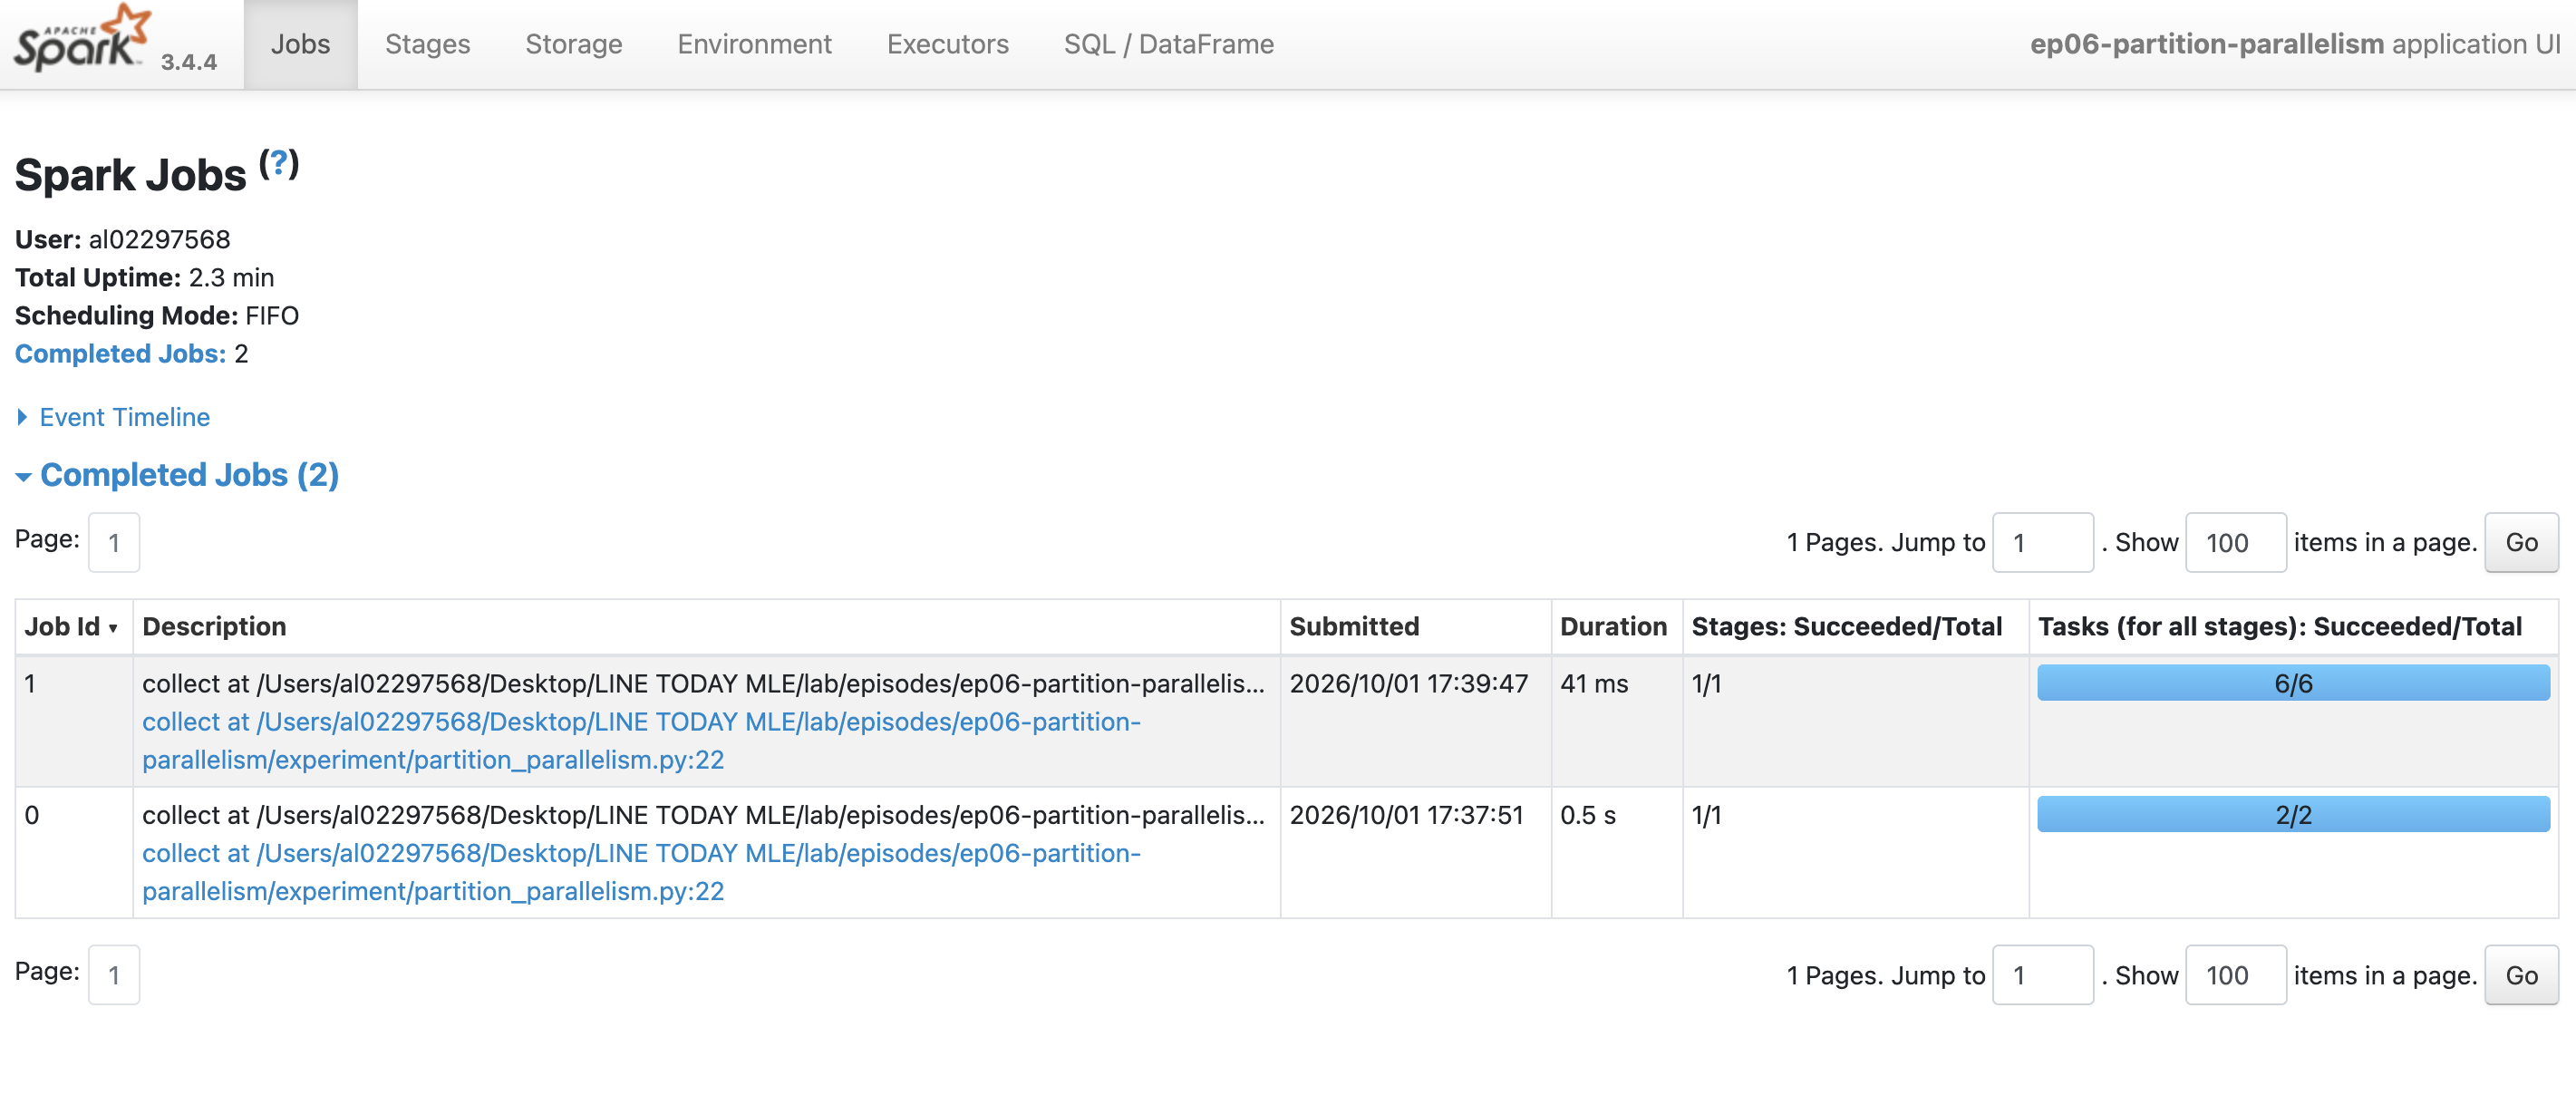
這張圖也提醒我別急著比較 Job duration。資料太小,第一個 Job 還會包含 JVM warm-up、code generation 等一次性成本;0.5 s 與 41 ms 不足以證明 6 個 partition 一定比較快。這次實驗要確認的證據是 task 數,而不是效能數字。
local[2] 不會把 task 數固定成 2當 DataFrame 有 6 個 partition 時,Spark 仍建立 6 個 task。local[2] 只表示最多兩個 task thread 同時執行,因此這 6 個 task 最多分成三批處理:
6 個 task
  ↓ local[2]
第 1 批:2 個 task
第 2 批:2 個 task
第 3 批:2 個 task
資料很小時,這些 task 很快就完成,Spark UI 的 Event Timeline 未必足以清楚看出每一批。不過 task 總數仍然是 6。未來換到 cluster 時,概念維持不變:task 總數來自 partition,executor 與 core 數量則決定同時能處理多少 task。
實驗一開始也印出了:
Effective default parallelism: 2
這是這個 local[2] 環境下 Spark 的有效 default parallelism。若 spark.range() 沒有指定 numPartitions,會使用這個值。實際讀取檔案時,來源 partition 還會受檔案大小與切分方式影響;spark.sql.files.maxPartitionBytes 的預設值是 128 MiB。這些都屬於「來源 partition」的範圍。
之後我們會接著看 wide transformation 產生的「shuffle partition」。它的 task 數常和 spark.sql.shuffle.partitions、AQE 有關,來源和讀檔時的切分不同。
我平常在 terminal 跑 Spark 時,很容易先看到這種進度條,裡面其實呈現了很多有用的資訊:
[Stage 0:=================> (40 + 2) / 100]
| 文字 | 說明 |
|---|---|
Stage 0 |
正在執行的 stage。 |
40 |
已完成 40 個 task。 |
+ 2 |
當下正在執行 2 個 task。 |
/ 100 |
這個 stage 總共要完成 100 個 task。 |
在沒有 task 重試等額外狀況時,約有 100 - 40 - 2 = 58 個 task 尚未開始。若在 local[2] 下,畫面長時間維持大量未開始 task、且同時執行數始終是 + 2,我就知道其他 task 正在等待可以處理任務的 slot/task thread。
progress bar 是快速線索,Spark UI 則提供後續判斷需要的細節:task 的 Duration、Input Size、Shuffle Read/Write 是否平均,以及哪個 stage 真正花了最多時間。
task 數沒有通用的「理想值」,必須和資料量、資料分布與可用資源一起看。我目前會先沿著這個順序排查:
這個 Stage 是讀取資料,還是 shuffle 後的 Stage?
  ↓
它有多少 task?可用的 task slot 有多少?
  ↓
各 task 的資料量與耗時是否平均?
  ↓
問題是平行度不足、task 過碎,還是資料 skew?
| UI 現象 | 可能代表什麼 | 可以先查什麼? |
|---|---|---|
| task 數少於可用 slot,且每個 task 很久 | 平行度可能不足 | 來源 partition 數、檔案切分或 shuffle partition 數。 |
| task 很多,但大多只跑幾毫秒 | task 過碎,排程成本可能偏高 | partition 是否切太細、是否有小檔案問題。 |
| 少數 task 特別慢 | 資料可能 skew | 比較 task 的 Input Size、Shuffle Read 與 Duration。 |
spark.default.parallelism 主要影響 RDD 與部分未指定 partition 數的情境;它不是所有 DataFrame stage 的萬用設定。遇到 task 數不符合預期時,先辨認它是來源 partition 還是 shuffle partition,才能找到真正的影響來源。
這個觀念讓我想到最近在跑資料分析時捅的婁子。我在開發環境中的 pod 裡用 local[2] 跑 Spark,每次實驗改個設定、跑個分析都要等很久,等得有點不耐煩==。我從進度條中發現,stage 裡動輒有上百個 task,當時也有多個 stage 的 task 等著被處理,但一次都只能處理 2 個 task;我便改了 Spark 啟動設定,試了 local[*]、local[64]、local[32],結果原本跑得動的東西突然都罷工不動了……
仔細讀 error log 看到 java.lang.OutOfMemoryError,才知道原來不能這樣亂開啊哈哈哈。增加 thread 數字確實能提高平行化,但 pod 的 CPU 與 memory limit 沒有因此增加。尤其 local mode 裡的 task thread 共用同一個 JVM process;更多 task 同時解碼、運算與聚合,也讓瞬時記憶體用量一起提高。結果搞半天分析結果沒留下來,還得重新執行一次,弄巧成拙花了更久時間。
這次經驗讓我特別記得平行化也是有代價的,提高 local[N] 是提高同時競爭資源的 task 數,還是要注意自己的環境有多少資源。
現在我看到 Spark UI 的 task 數,至少能先把問題拆開:這個數字來自哪一種 partition?有多少工作能被切開?又有多少資源能同時處理它們?
來源 partition 讓 task 數出現,資源決定 task 的併發上限;兩者都需要和資料量、資料分布一起判斷。
下一篇,我會接著討論 wide transformation:當 groupBy()、join() 造成 shuffle 時,partition 數和 task 數會如何重新被決定?
🚀 GitHub:
Ep06|Partition 不只是資料切塊:它如何決定 Task 數與平行度?
🚀 spark-learning-lab 系列文章與實作:
https://github.com/jeffery5bai/spark-learning-lab
Apache Spark 3.4.4 — Submitting Applications:
https://archive.apache.org/dist/spark/docs/3.4.4/submitting-applications.html
Apache Spark 3.4.4 — Configuration:
https://archive.apache.org/dist/spark/docs/3.4.4/configuration.html
Apache Spark 3.4.4 — Web UI:
https://archive.apache.org/dist/spark/docs/3.4.4/web-ui.html

 jeffery5bai

 iThome鐵人賽
 看影片追技術