
上一集,我從輸入資料看見:來源有幾個 partition,沒有 shuffle 的 stage 通常就有幾個 task。不過日常寫 DataFrame pipeline 時,更常遇到的是:來源明明只有幾個 partition,在不同的 stage 之間,task 數卻一直變來變去。
這篇要回答的是:處理中的哪一步改變了資料分布?為什麼有些 shuffle 可以被下一步沿用,有些卻會讓資料再搬一次?又為什麼設定 6 個 shuffle partition,最後實際跑出的 task 數不一定是 6?
實驗固定從兩個 partition 的訂單資料出發,並設定 spark.sql.shuffle.partitions = 6。我會比較無 key 與有 key 的 repartition、groupBy、window、inner join 與 AQE,讓 Spark UI 和 Physical Plan 留下證據;重點不是這份小資料誰跑得快,而是每一步需要什麼資料分布。
repartition(6) 後接 groupBy("key") 可能 shuffle 兩次。groupBy、join 或 window 沿用。這個系列把 partition 放回一條資料路徑來看:
輸入資料:來源 partition 怎麼切
  ↓
資料處理:shuffle 與 AQE 如何改變分布、task 數
  ↓
輸出資料:寫檔前如何安排 partition 與檔案布局
這次我們專心討論資料處理過程中的變化。若資料處理能由每個 partition 各自完成(narrow),資料就沿用原有分布;若它要求特定 key 的資料聚在一起,或要求全域排序(wide),Spark 就得 shuffle。
| 操作 | 對資料分布的要求 |
|---|---|
where()、select()、withColumn() |
各 partition 可各自完成,通常沿用現有分布。 |
groupBy()、distinct()、dropDuplicates()、多數 join() |
相同 key 的資料要在一起,常需要依 key shuffle。 |
orderBy() |
常需要依排序範圍重分配資料。 |
Window.partitionBy(...).orderBy(...) |
相同 window key 要在一起,並在 partition 內排序。 |
spark.sql.shuffle.partitions 決定 Spark SQL 初始規劃的 shuffle partition 數;Spark 3.4 的預設值是 200。每個 shuffle partition 會成為下游 stage 的一個 task,但 AQE 開啟時,這只是起點。
下一步 operation 需要什麼資料分布,決定 Spark 是否必須 shuffle。
repartition(6),為什麼結果差很多?來源資料有兩個 partition。先看沒有指定 key 的寫法:
round_robin_grouped = (
    orders.repartition(6)
    .groupBy("customer_id")
    .agg(F.sum("amount").alias("total_amount"))
)
repartition(6) 使用 round-robin,把資料大致平均送往六個 partition;它只保證份數,不保證相同 customer_id 在一起。後面的 groupBy("customer_id") 仍得依 key 再做一次 hash shuffle。
Physical Plan 由下往上讀,可以看到兩個 Exchange:
Exchange hashpartitioning(customer_id, 6)
+- HashAggregate(... partial_sum(amount))
   +- Exchange RoundRobinPartitioning(6)
中間的 partial_sum 是 Spark 先在本地做局部加總、減少第二次 shuffle 資料量的優化;兩個 Exchange 才是這個例子真正要觀察的事。
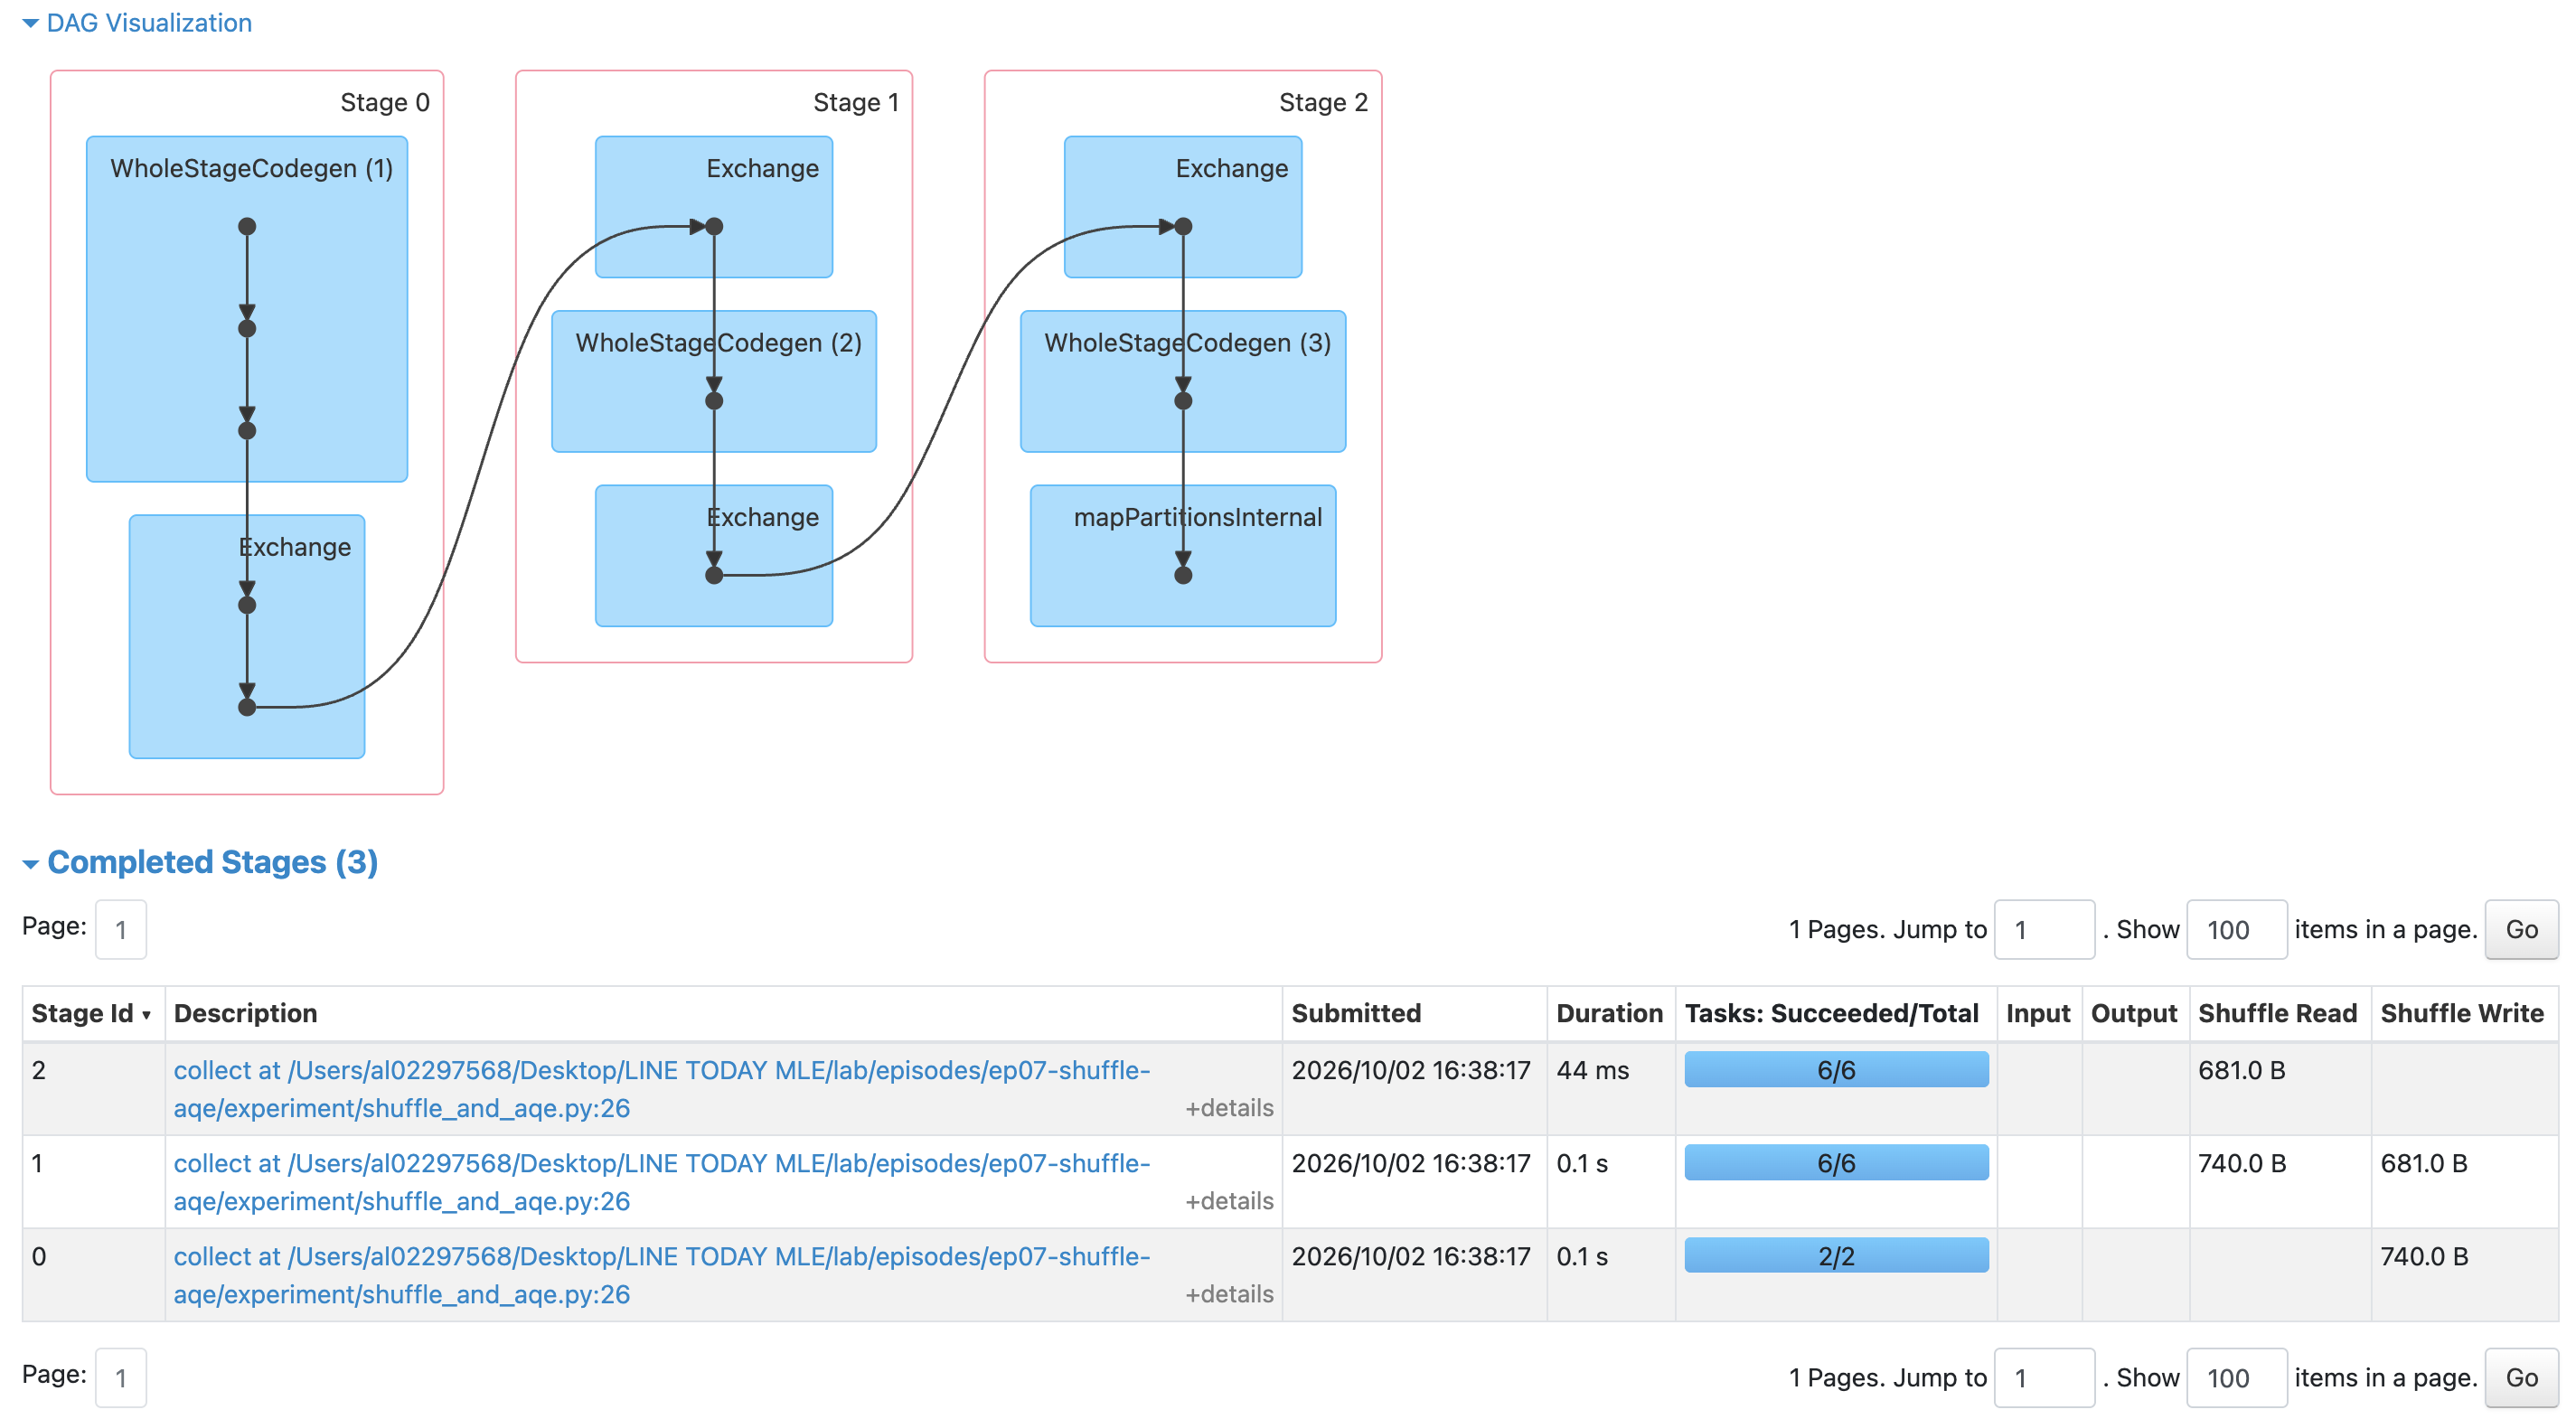
這個 Job 因此有三個 stage:來源的 2 個 task、round-robin 後的 6 個 task,以及依 customer_id 重分配後的 6 個 task。
改成指定 key:
keyed_grouped = (
    orders.repartition(6, "customer_id")
    .groupBy("customer_id")
    .agg(F.sum("amount").alias("total_amount"))
)
這次的 hash partitioning 已滿足 groupBy,plan 只有一個依 customer_id 的 Exchange;UI 也只剩來源的 2 個 task 與 aggregate stage 的 6 個 task。
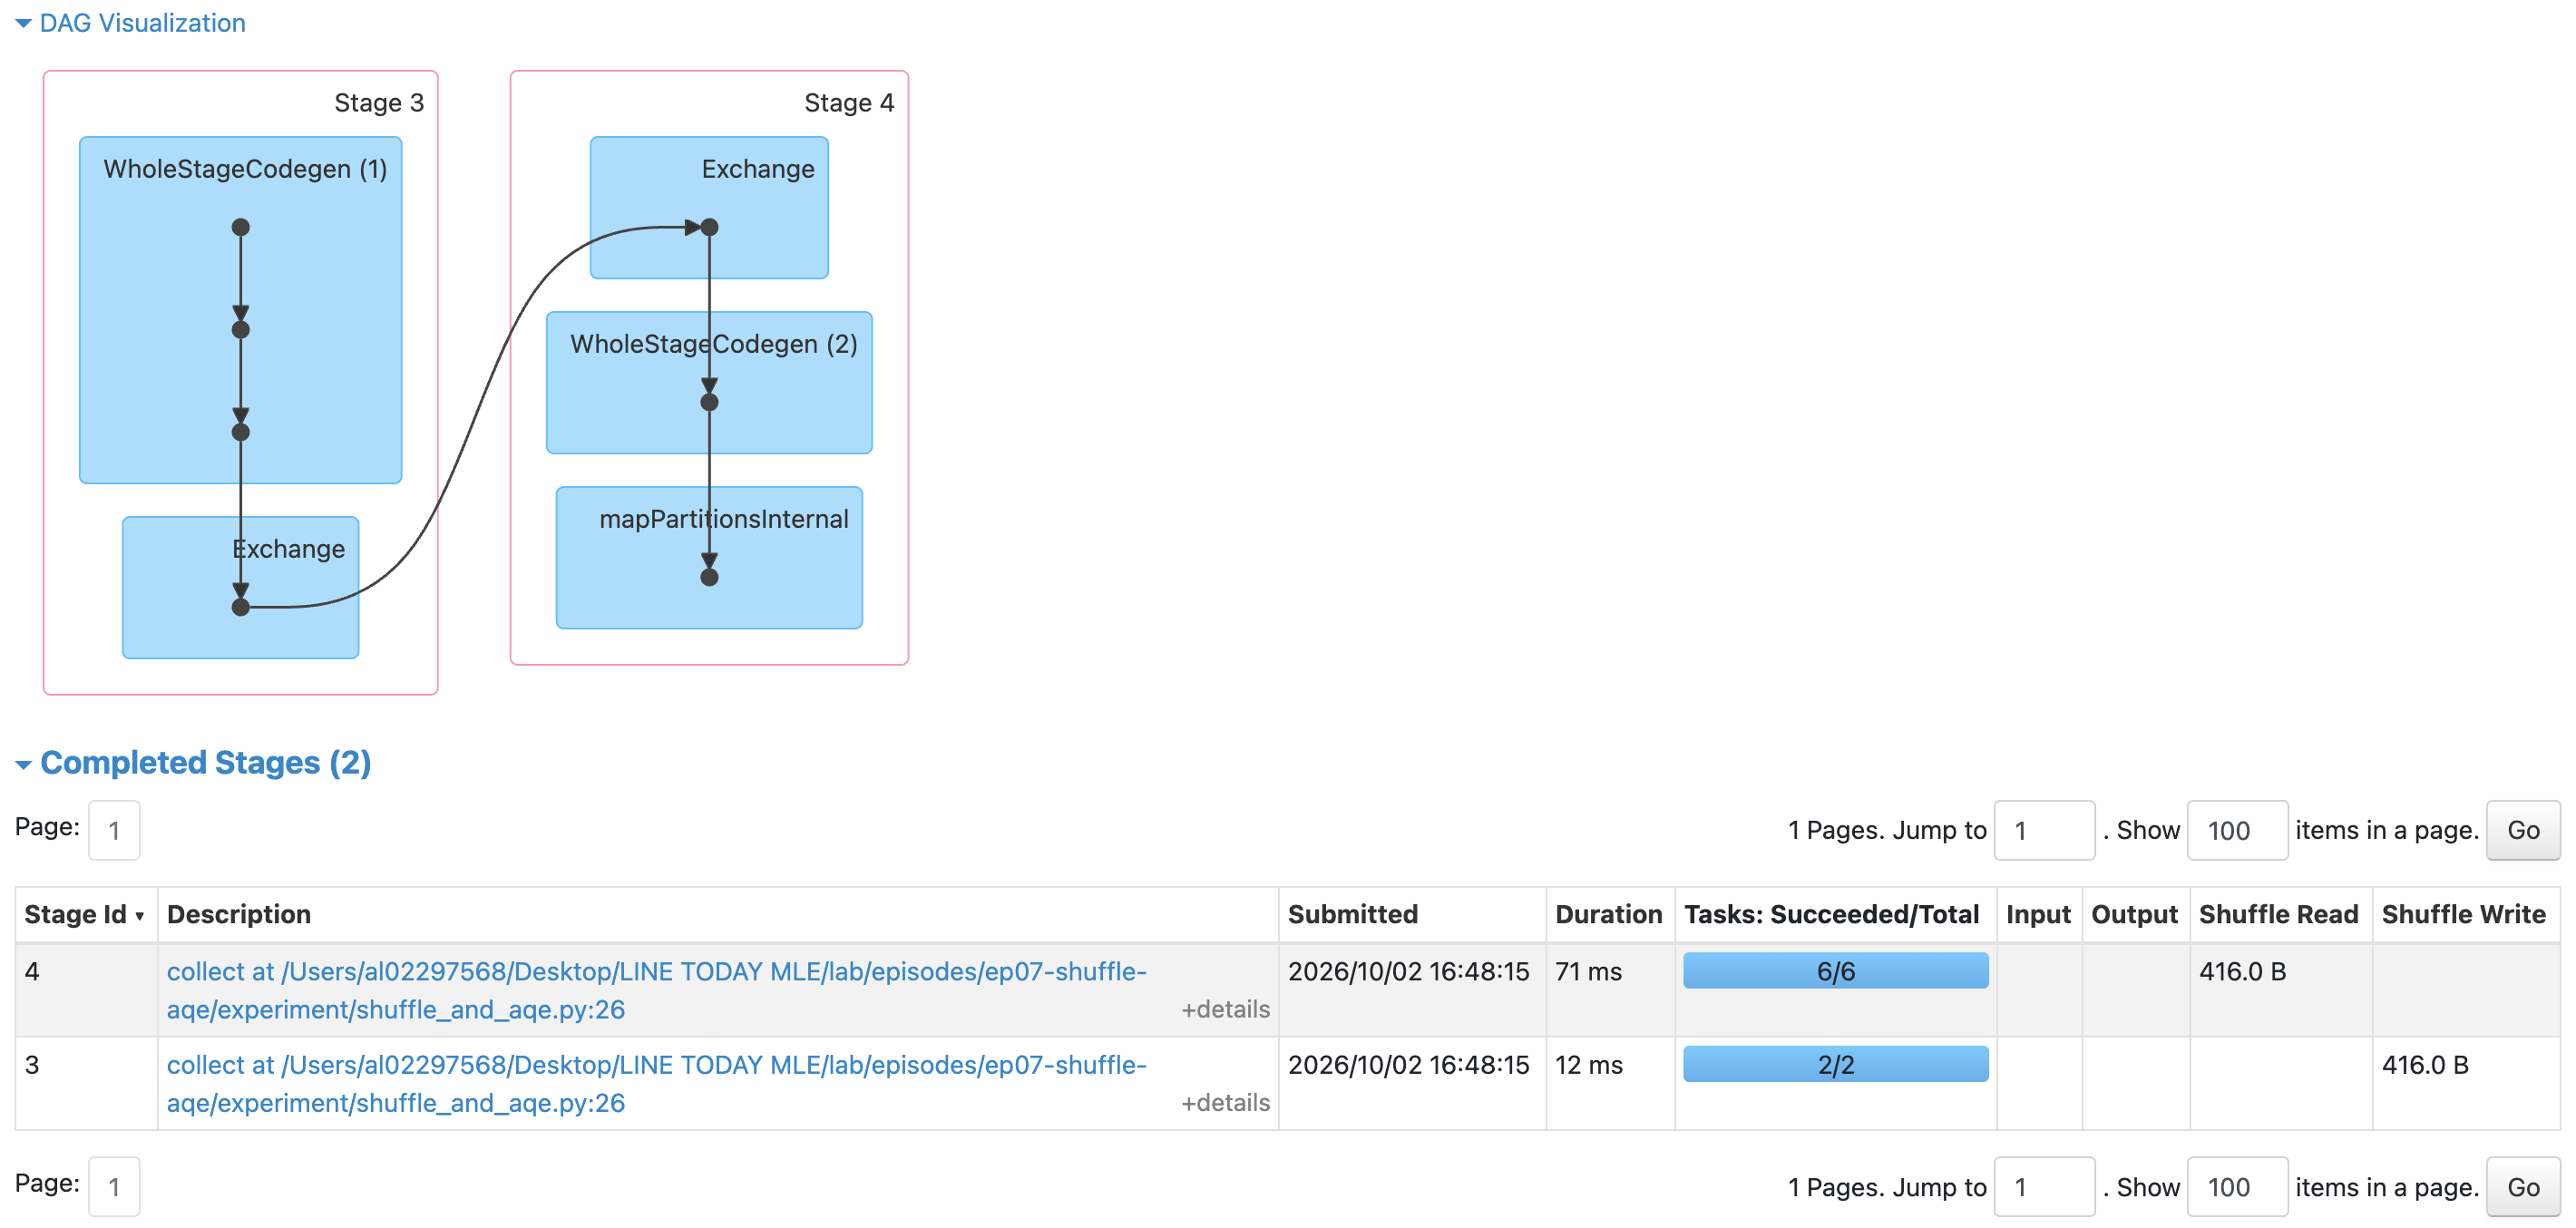
把 partition 數變大不等於準備好下游資料;只有正確的 key 分布才能省下下一次 shuffle。
大型 inner join 的兩側若都以相同 join key、相容的 partition 數重分配,SortMergeJoin 可以使用兩側已準備好的資料分布。兩側各有一次必要的 shuffle,不需要為同一個 key 再各做一次。這次實驗把 spark.sql.autoBroadcastJoinThreshold 設為 -1,刻意讓小資料也走 SortMergeJoin;真實工作中,小表能 broadcast 時通常是更好的策略。
window 也能沿用相同的 partition key,但它通常還需要排序:
customer_window = Window.partitionBy("customer_id").orderBy("event_time")

keyed_window = orders.repartition(6, "customer_id").withColumn(
    "row_num", F.row_number().over(customer_window)
)
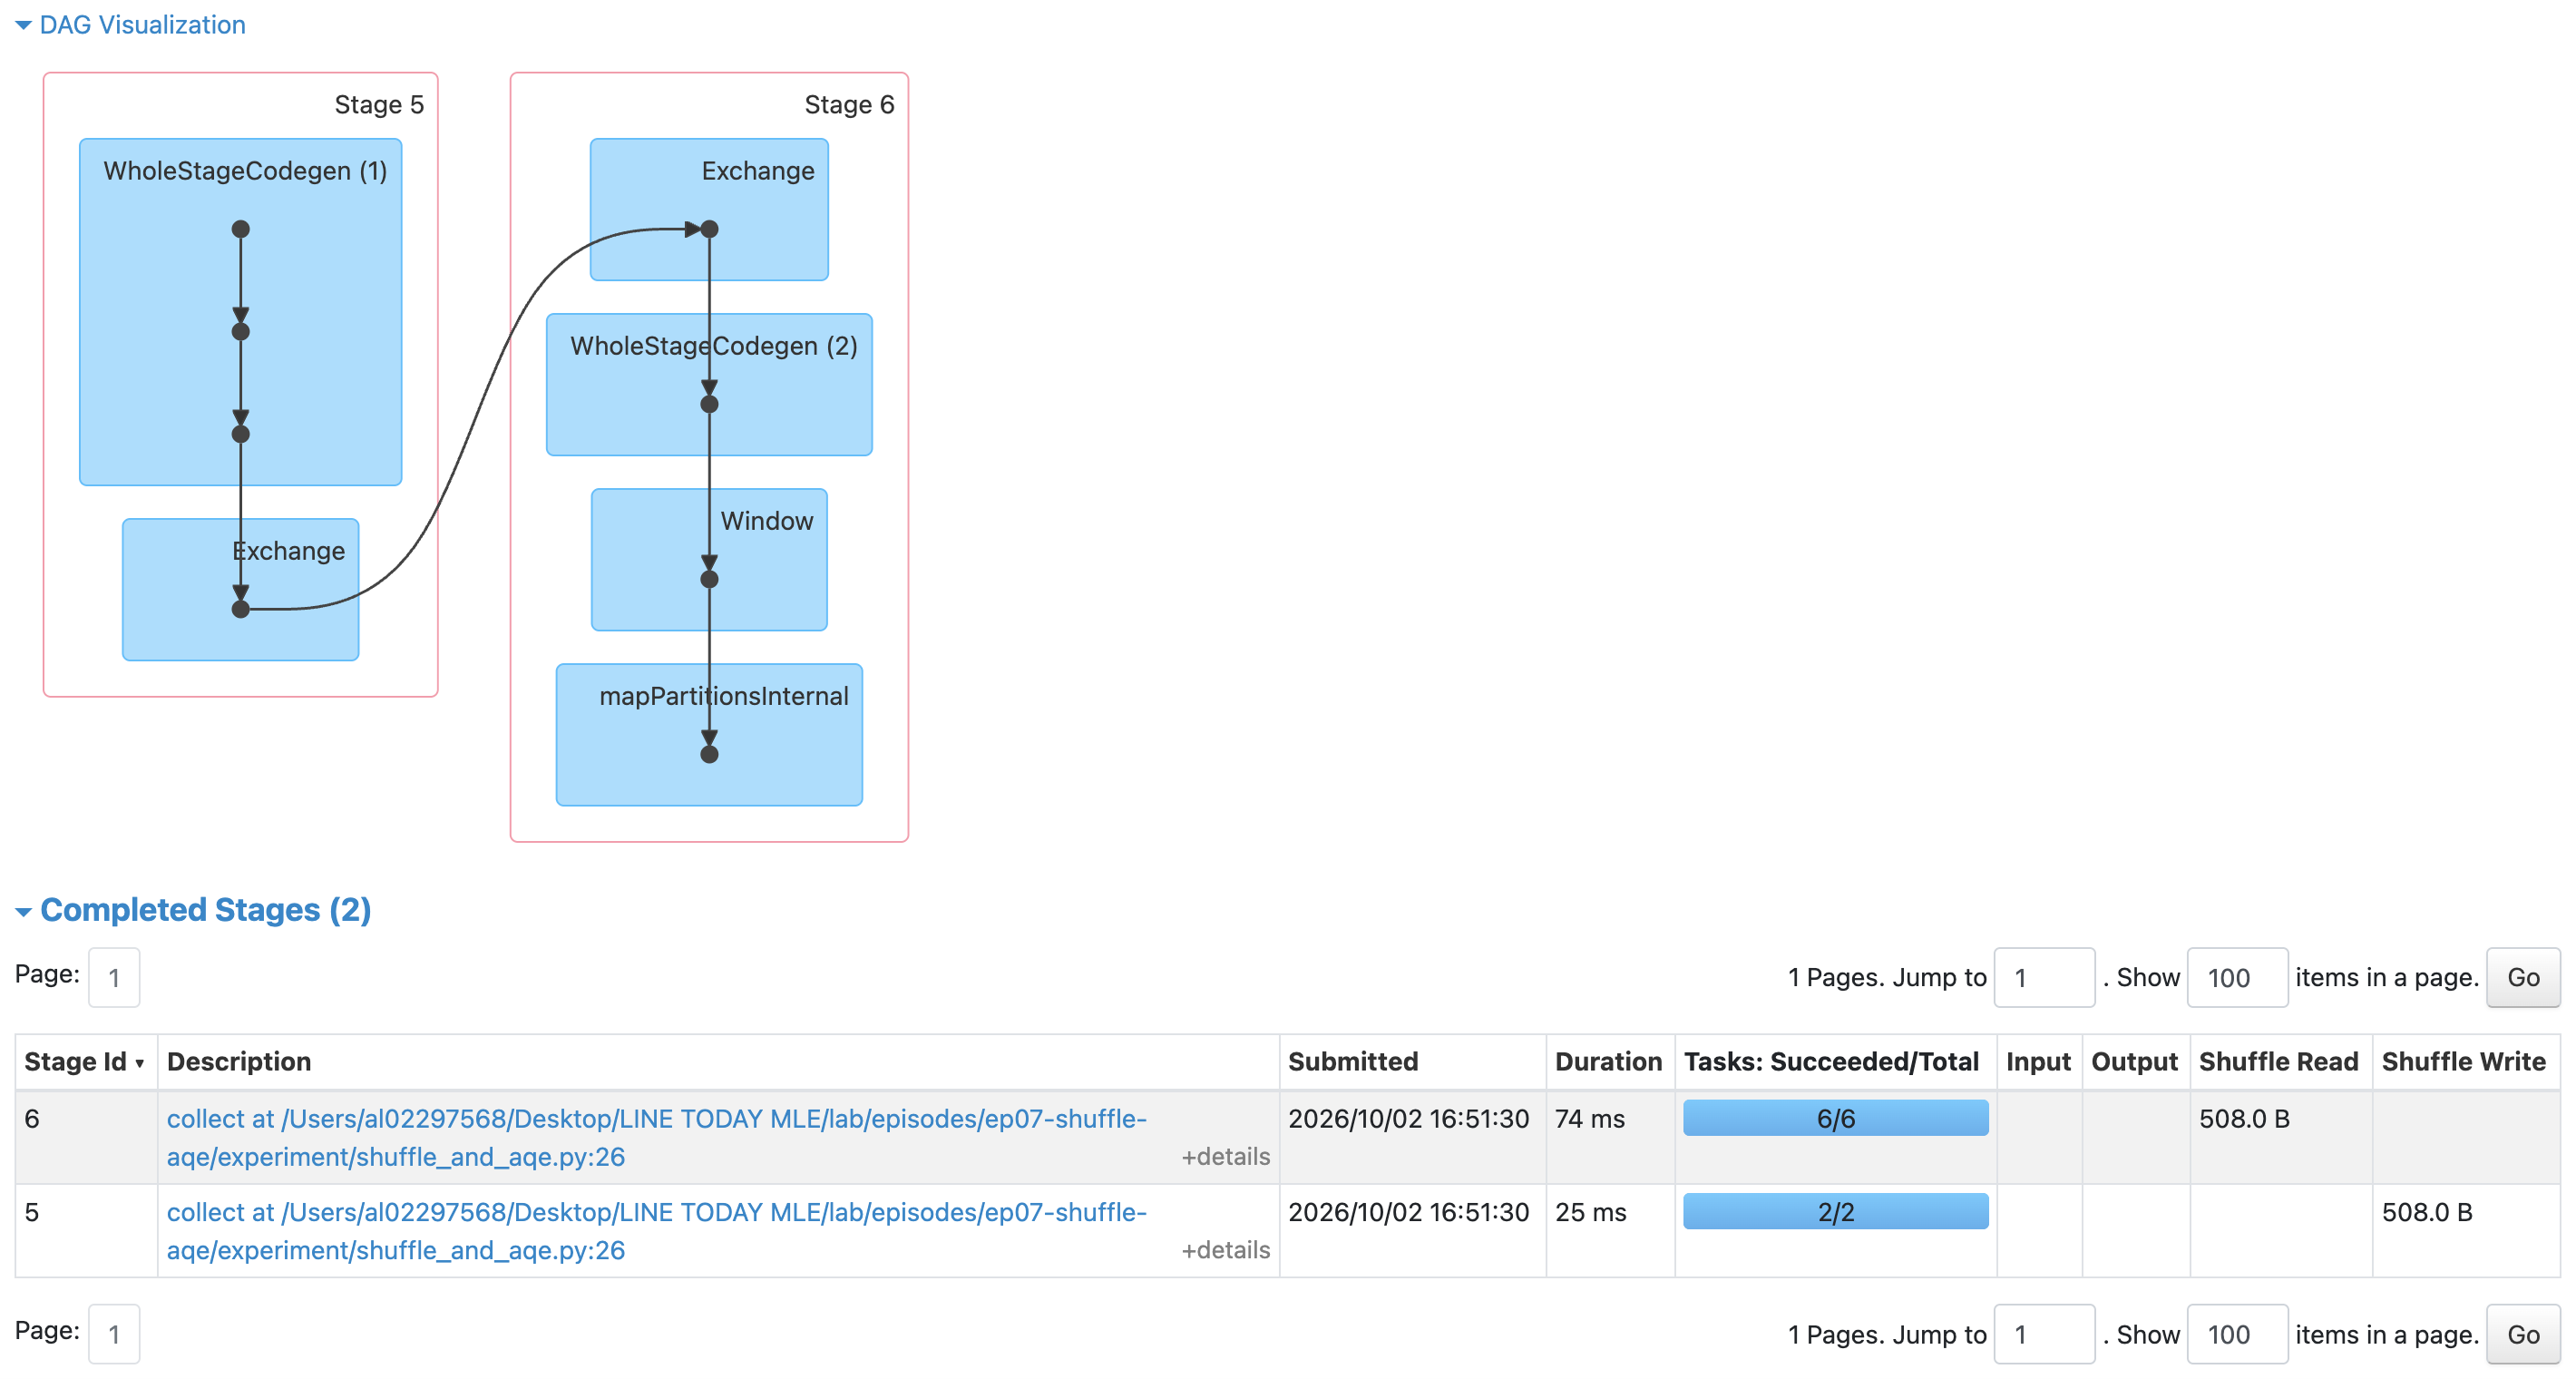
Physical Plan 只有一個 key-based Exchange,但它後面還會有 Sort。可以先這樣記:
groupBy:shuffle → aggregate
window:shuffle → sort → window calculation
NOTE: 這裡的「沿用」只發生在同一個 query plan 裡。若對中間 DataFrame 執行另一個 action,卻沒有 cache 或寫出保存,上游 lineage 仍會重新計算;shuffle 結果不會自動跨 job 保留。
AQE(Adaptive Query Execution)是 Spark SQL 的執行期最佳化機制:它先建立 initial plan,等前一段 shuffle 完成、取得實際資料量後,再調整尚未執行的後半段 plan。它讓 task 的切分更貼近真實資料,避免資料很少卻建立大量零碎 task,也為 join 與 skew 的後續調整保留空間。
這次只觀察 AQE 合併小 shuffle partition 的行為:
| 設定 | 作用 |
|---|---|
spark.sql.adaptive.enabled |
開啟 AQE;Spark 3.4 預設為 true。 |
spark.sql.adaptive.coalescePartitions.enabled |
合併過小的 shuffle partition;預設為 true。 |
spark.sql.adaptive.advisoryPartitionSizeInBytes |
合併後 partition 的建議大小;Spark 3.4.4 預設為 64 MiB。 |
spark.sql.shuffle.partitions |
AQE 的初始 partition 規劃,不保證等於最後 task 數。 |
advisoryPartitionSizeInBytes 描述的是 shuffle 資料要怎麼切給下游 task,不是輸出檔案大小。若環境設成 16m,AQE 會以 16 MiB 作為建議目標;資料分布與其他 AQE 限制仍會影響最終結果。
實驗先關閉 AQE,確認 6 個 shuffle partition 對應到 6 個 task;接著開啟 AQE,對相同的 groupBy 呼叫 action。action 前仍可看到:
Exchange hashpartitioning(customer_id, 6)
資料只有幾筆,六個 partition 太零碎。action 後的 final plan 出現 AQEShuffleRead coalesced,UI 最終也以 1 個 task 讀取合併後的 shuffle 資料,原本的 stage 則標成 skipped。
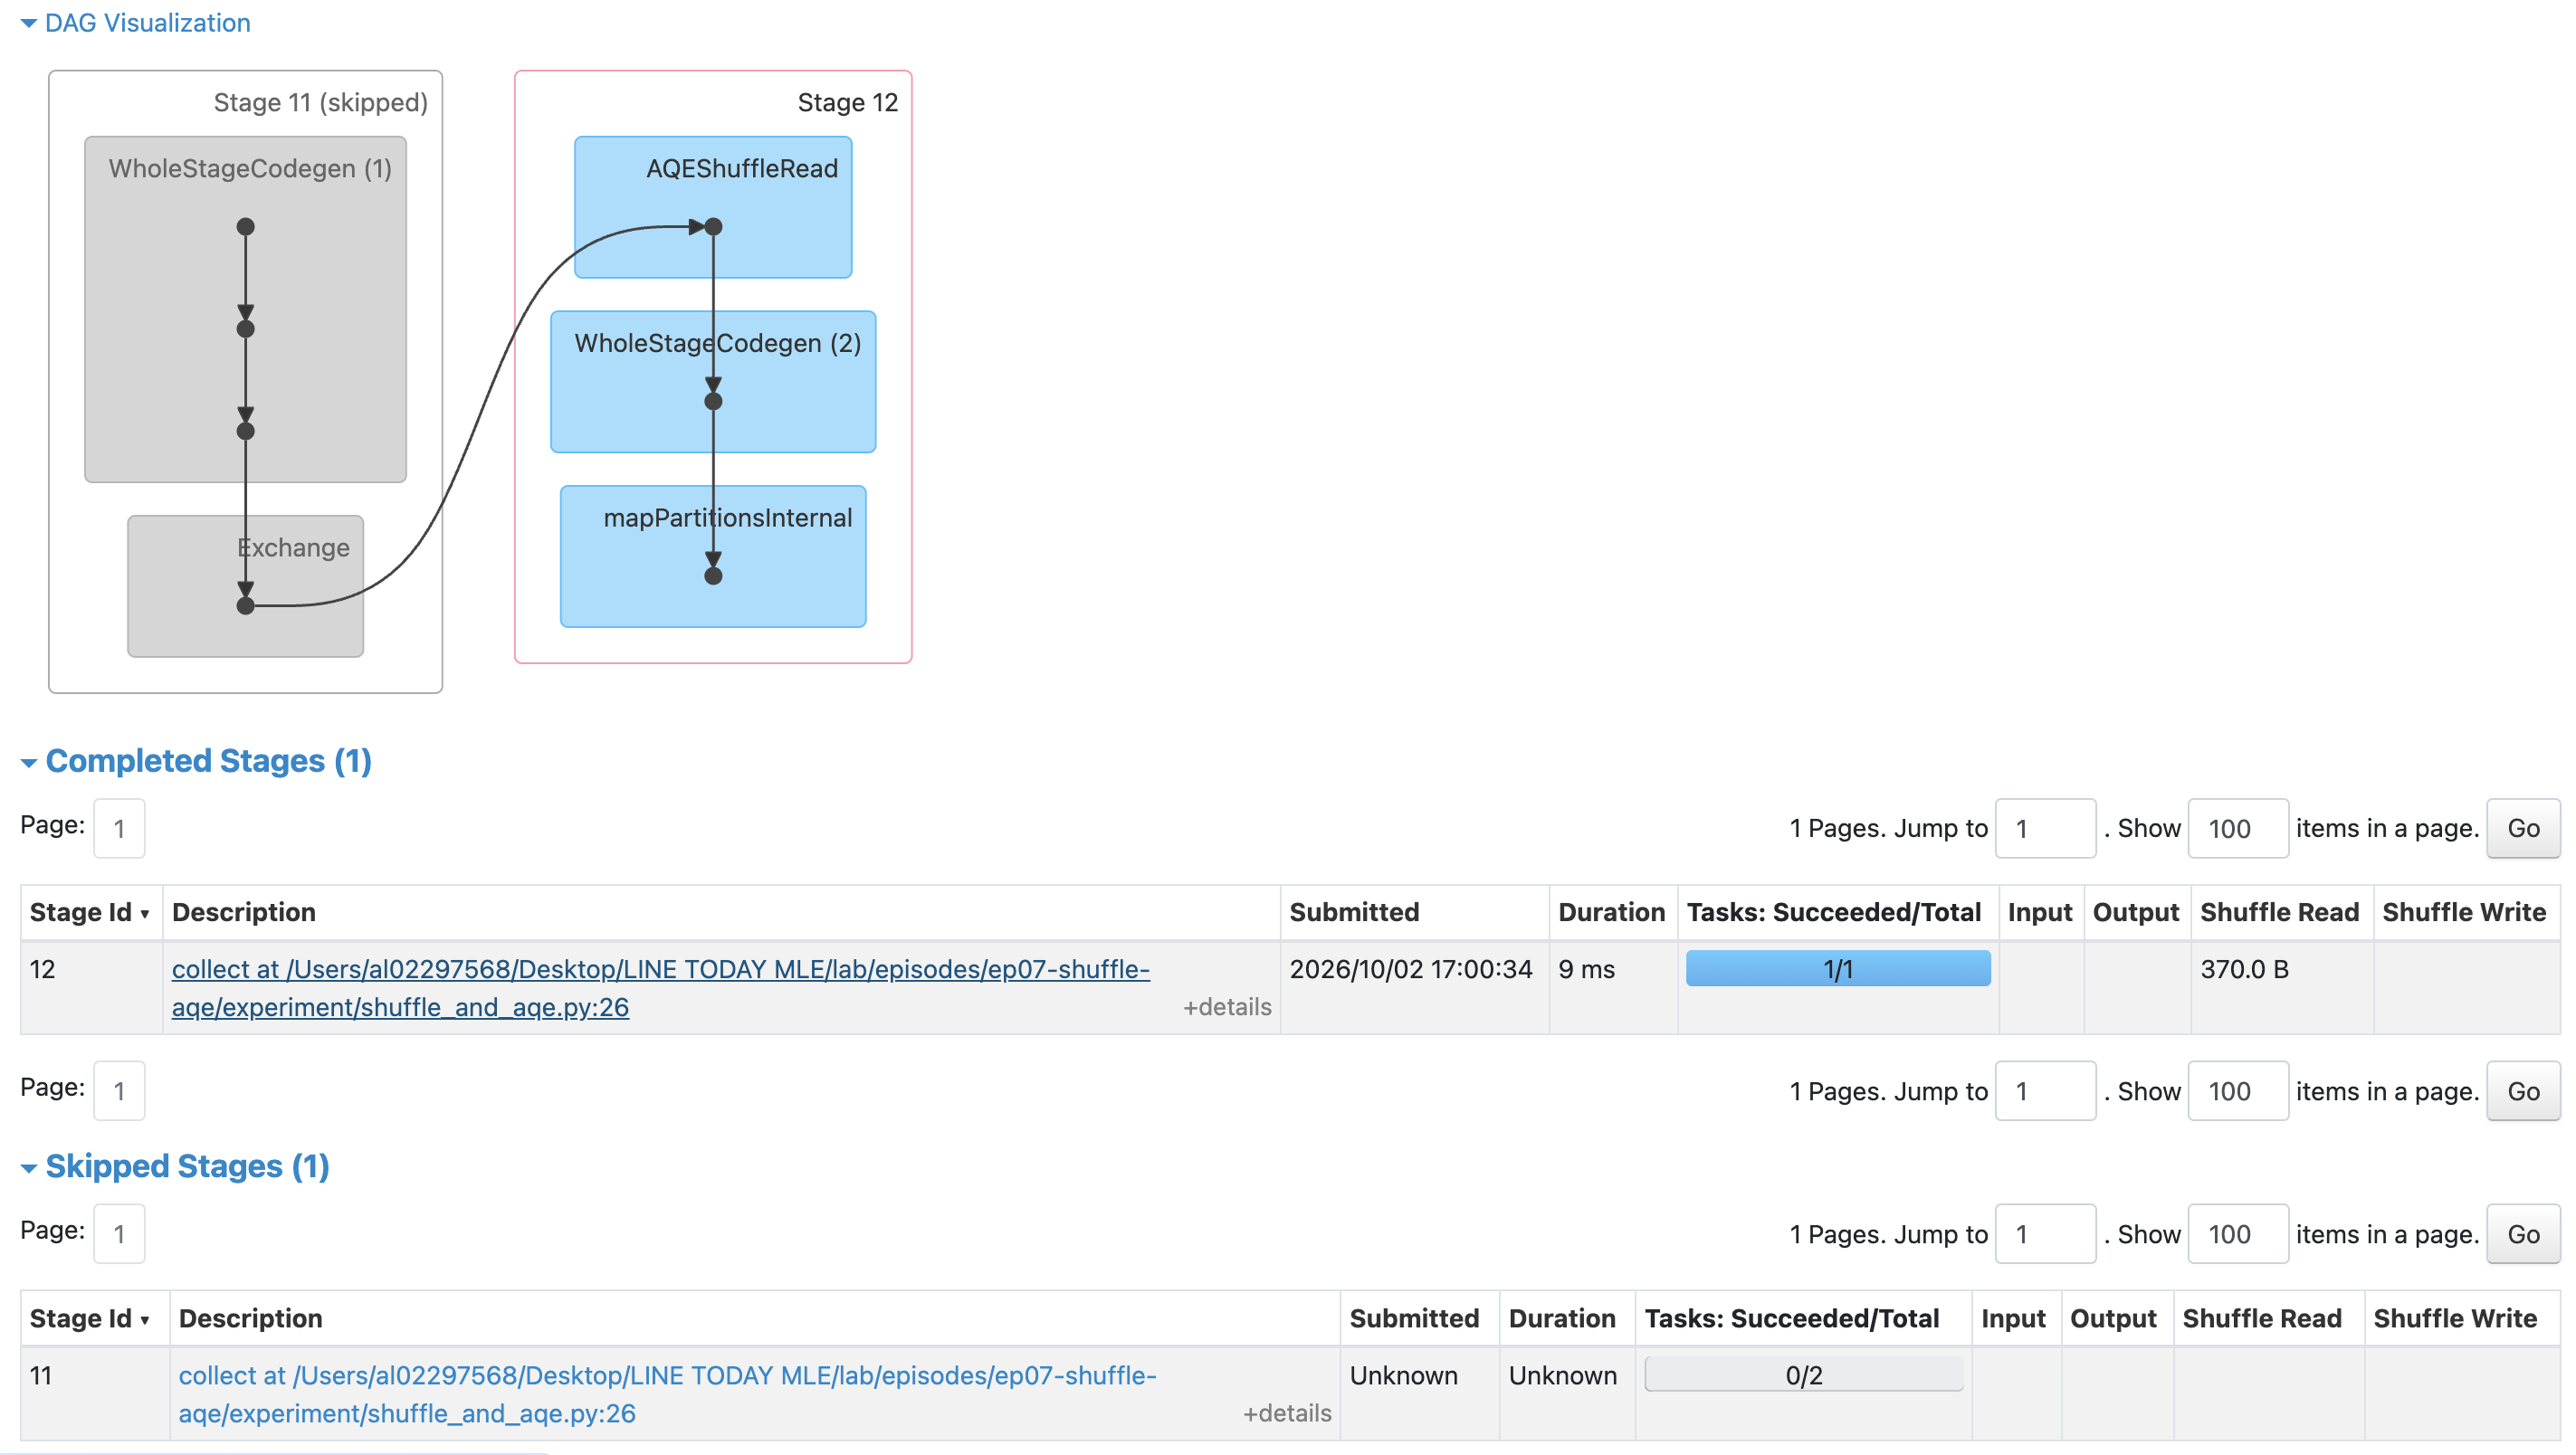
這個 1 不是普遍的理想值;它只是這份極小資料的執行結果。AQE 的 join strategy 與 skew 處理,留到後續效能專題再仔細驗證。
shuffle partition 是初始規劃;AQE 會依實際資料量,決定後續真正需要多少 task。
這是讀取資料的 stage,還是 shuffle 後的 stage?
  ↓
Physical Plan 有沒有 Exchange?它是 RoundRobin、Hash 還是 Range?
  ↓
現有 partitioning 是否滿足下一步的 key 或排序需求?
  ↓
AQE 是否開啟?final plan 有沒有 AQEShuffleRead?
  ↓
再比較 Shuffle Read / Write、task duration 與資料量。
這條路徑讓我不會只看到「task 很多」就急著改設定,而是先找到 task 數究竟來自來源資料、某個 wide transformation,還是 AQE 的執行期調整。
資料處理中的 partition 會跟著下游需求改變。主動 repartition 的價值不只在於改變數量:它留下的資料分布若符合下游 key,就能避免一次 shuffle;若沒有對準 key,反而只是多一段搬資料。
下一篇會走到資料路徑的最後一段:repartition、coalesce、partitionBy 對輸出 task 與檔案布局各有什麼影響?
🚀 GitHub:
Ep07|同一段 DataFrame pipeline,Task 數為什麼會變?從 Shuffle 到 AQE
🚀 spark-learning-lab 系列文章與實作:
https://github.com/jeffery5bai/spark-learning-lab
Apache Spark 3.4.4 — Configuration:
https://archive.apache.org/dist/spark/docs/3.4.4/configuration.html
Apache Spark 3.4.4 — SQL Performance Tuning:
https://archive.apache.org/dist/spark/docs/3.4.4/sql-performance-tuning.html

 jeffery5bai

 iThome鐵人賽
 看影片追技術