
資料處理完成後,Spark 的工作還沒有結束。下游不會讀取「上一個 stage 有幾個 task」,它讀取的是 Parquet 檔案。檔案太小,會多出開檔、metadata 與排程成本;檔案太大,讀取時又少了可平行處理的空間。
我過去常看到一種寫法:在寫出前加上 repartition(32),再 partitionBy("dth", "region")。直覺上以為每個日期、地區目錄都會有 32 個檔案,但實際上不是這麼簡單。這次我想把問題拆開:寫入前的 partition 數、輸出目錄與實際檔案數,分別由什麼決定?
實驗刻意只用 600 筆資料、6 個 source partitions,並關閉 AQE。資料很小,無法比較寫入效能;它要驗證的是每次改變 partitioning 後,Spark UI 的 task 數、Parquet 檔案數與目錄布局如何改變。
.write.parquet() 觸發寫入後,沒有 partitionBy 時 task 和輸出檔案的關係。repartition(n) 與 coalesce(n) 如何用不同代價改變寫入 task 與檔案數。partitionBy() 為什麼安排目錄,卻可能讓檔案數變多。repartition(n, "key") 可以讓同 key 集中,卻不保證不同 key 平均落在不同 task。這次會一直在三個層次之間切換:
寫入前 DataFrame 的 partitions
  ↓
write stage 的 tasks
  ↓
實際寫出的 Parquet data files
沒有 partitionBy 時,一個非空的 write task 通常寫出一個 Parquet data file;但這只是最簡單的情況。partitionBy("dth", "region") 會把資料寫進 dth=.../region=... 目錄,一個 task 可能同時碰到很多組日期、地區,也就在多個目錄各寫一個檔案。
partition 數決定可安排多少 write task;資料分布和輸出 key 一起決定最後會留下多少檔案。
來源資料有 6 個 partitions,且先不使用 partitionBy:
from pyspark.sql import functions as F

C = F.col

orders = (
    spark.range(0, 600, numPartitions=6)
    .withColumn(
        "region",
        F.when(C("id") % 3 == 0, "TW")
        .when(C("id") % 3 == 1, "JP")
        .otherwise("US"),
    )
)

orders.write.parquet(output_path)
Spark UI 顯示這個 Job 只有一個 stage、6/6 tasks;目錄裡也有 6 個 Parquet data files。
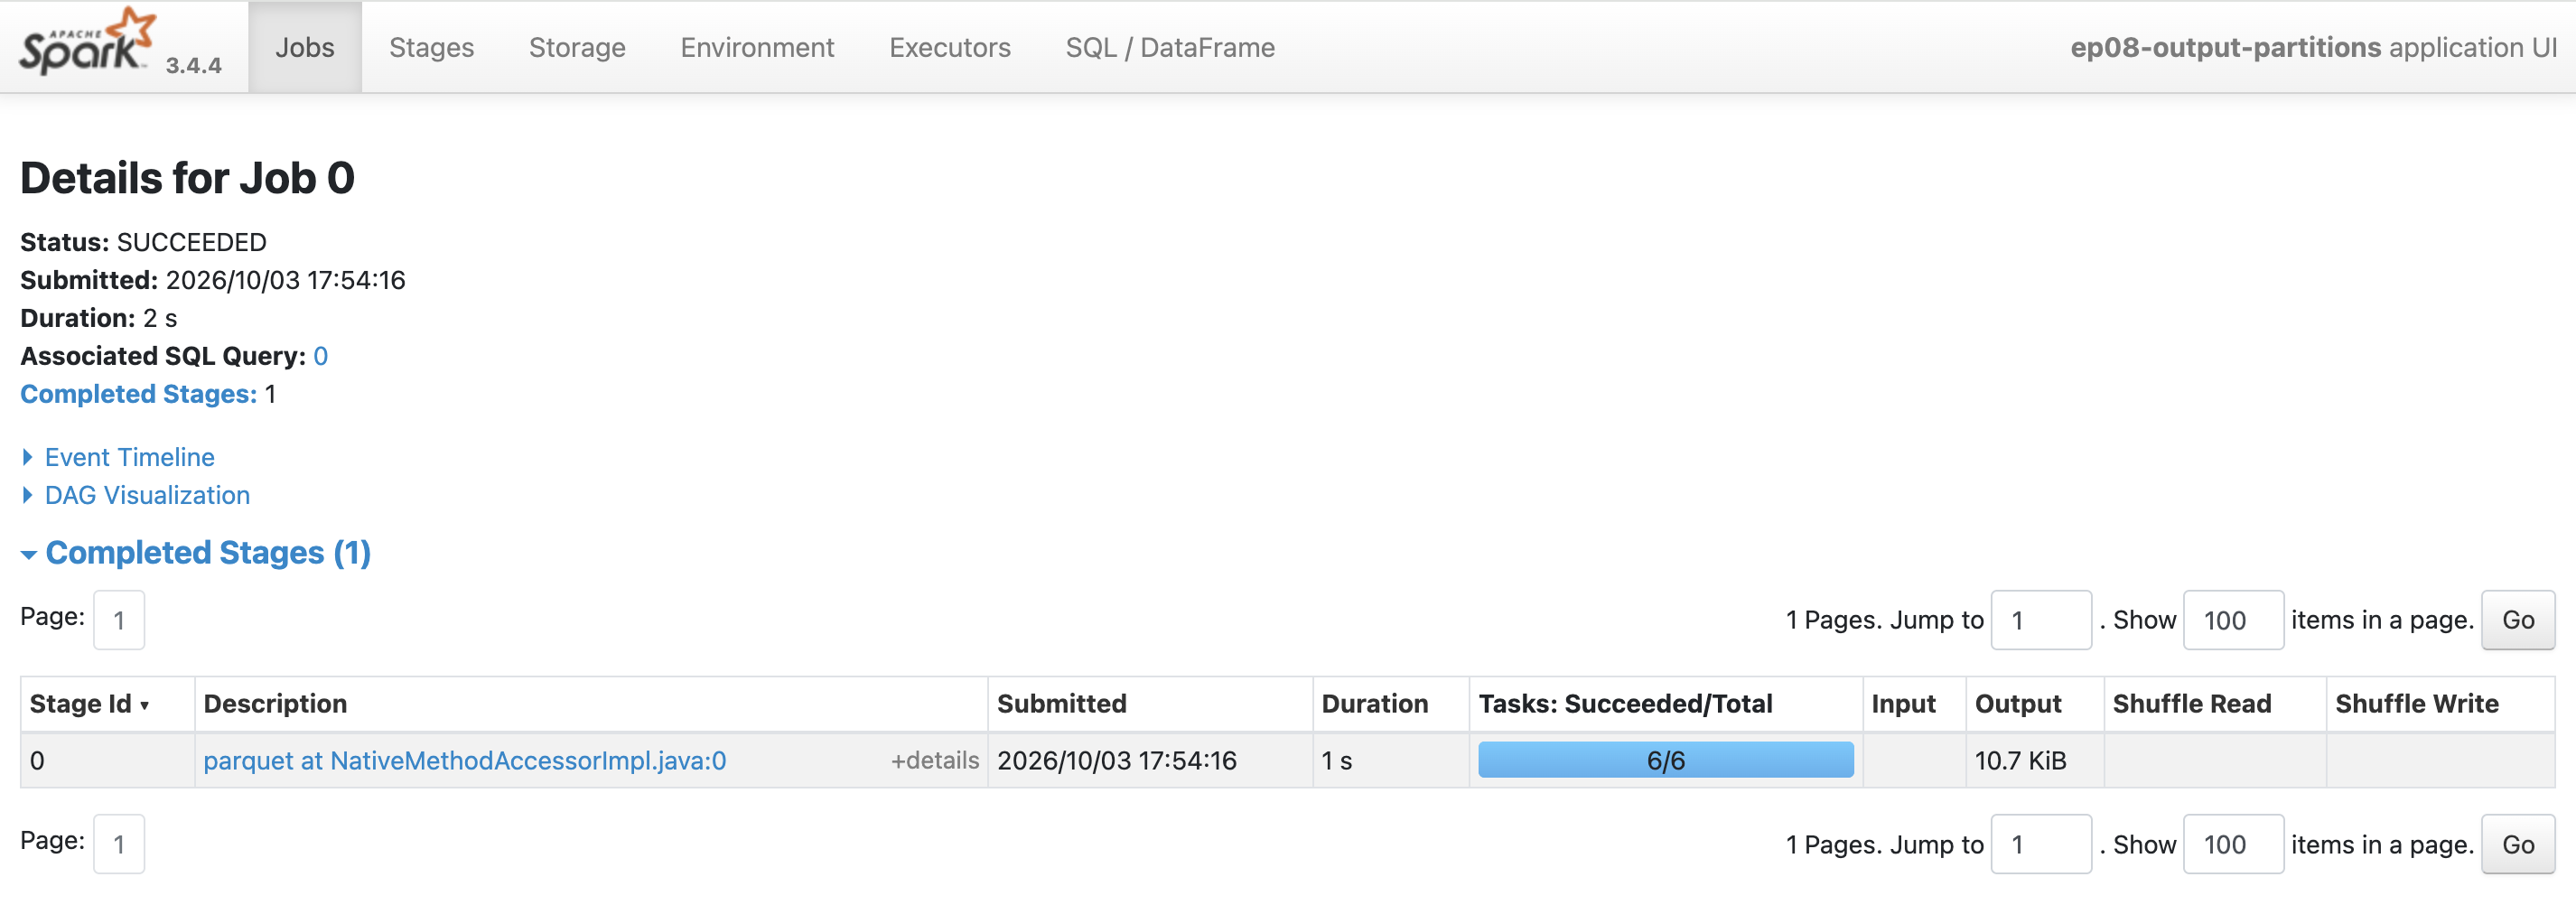
因此,沒有輸出 key、也沒有額外切檔限制時,可以先用這個近似關係理解:
Parquet data files ≈ 非空 write tasks
這不是「檔案數永遠等於 partition 數」的保證。空 partition 不會產生 data file,spark.sql.files.maxRecordsPerFile 也可能把同一 task 的資料切成多個檔案;但它是判斷輸出檔案從哪裡來的好起點。
repartition 嗎?把寫入前的 partition 數改成 12:
orders.repartition(12).write.parquet(output_path)
repartition(12) 會 shuffle。Physical Plan 裡出現 Exchange RoundRobinPartitioning(12),UI 也變成兩個 stage:上游維持 6 個 task,shuffle 後的 write stage 有 12 個 task,最後寫出 12 個檔案。
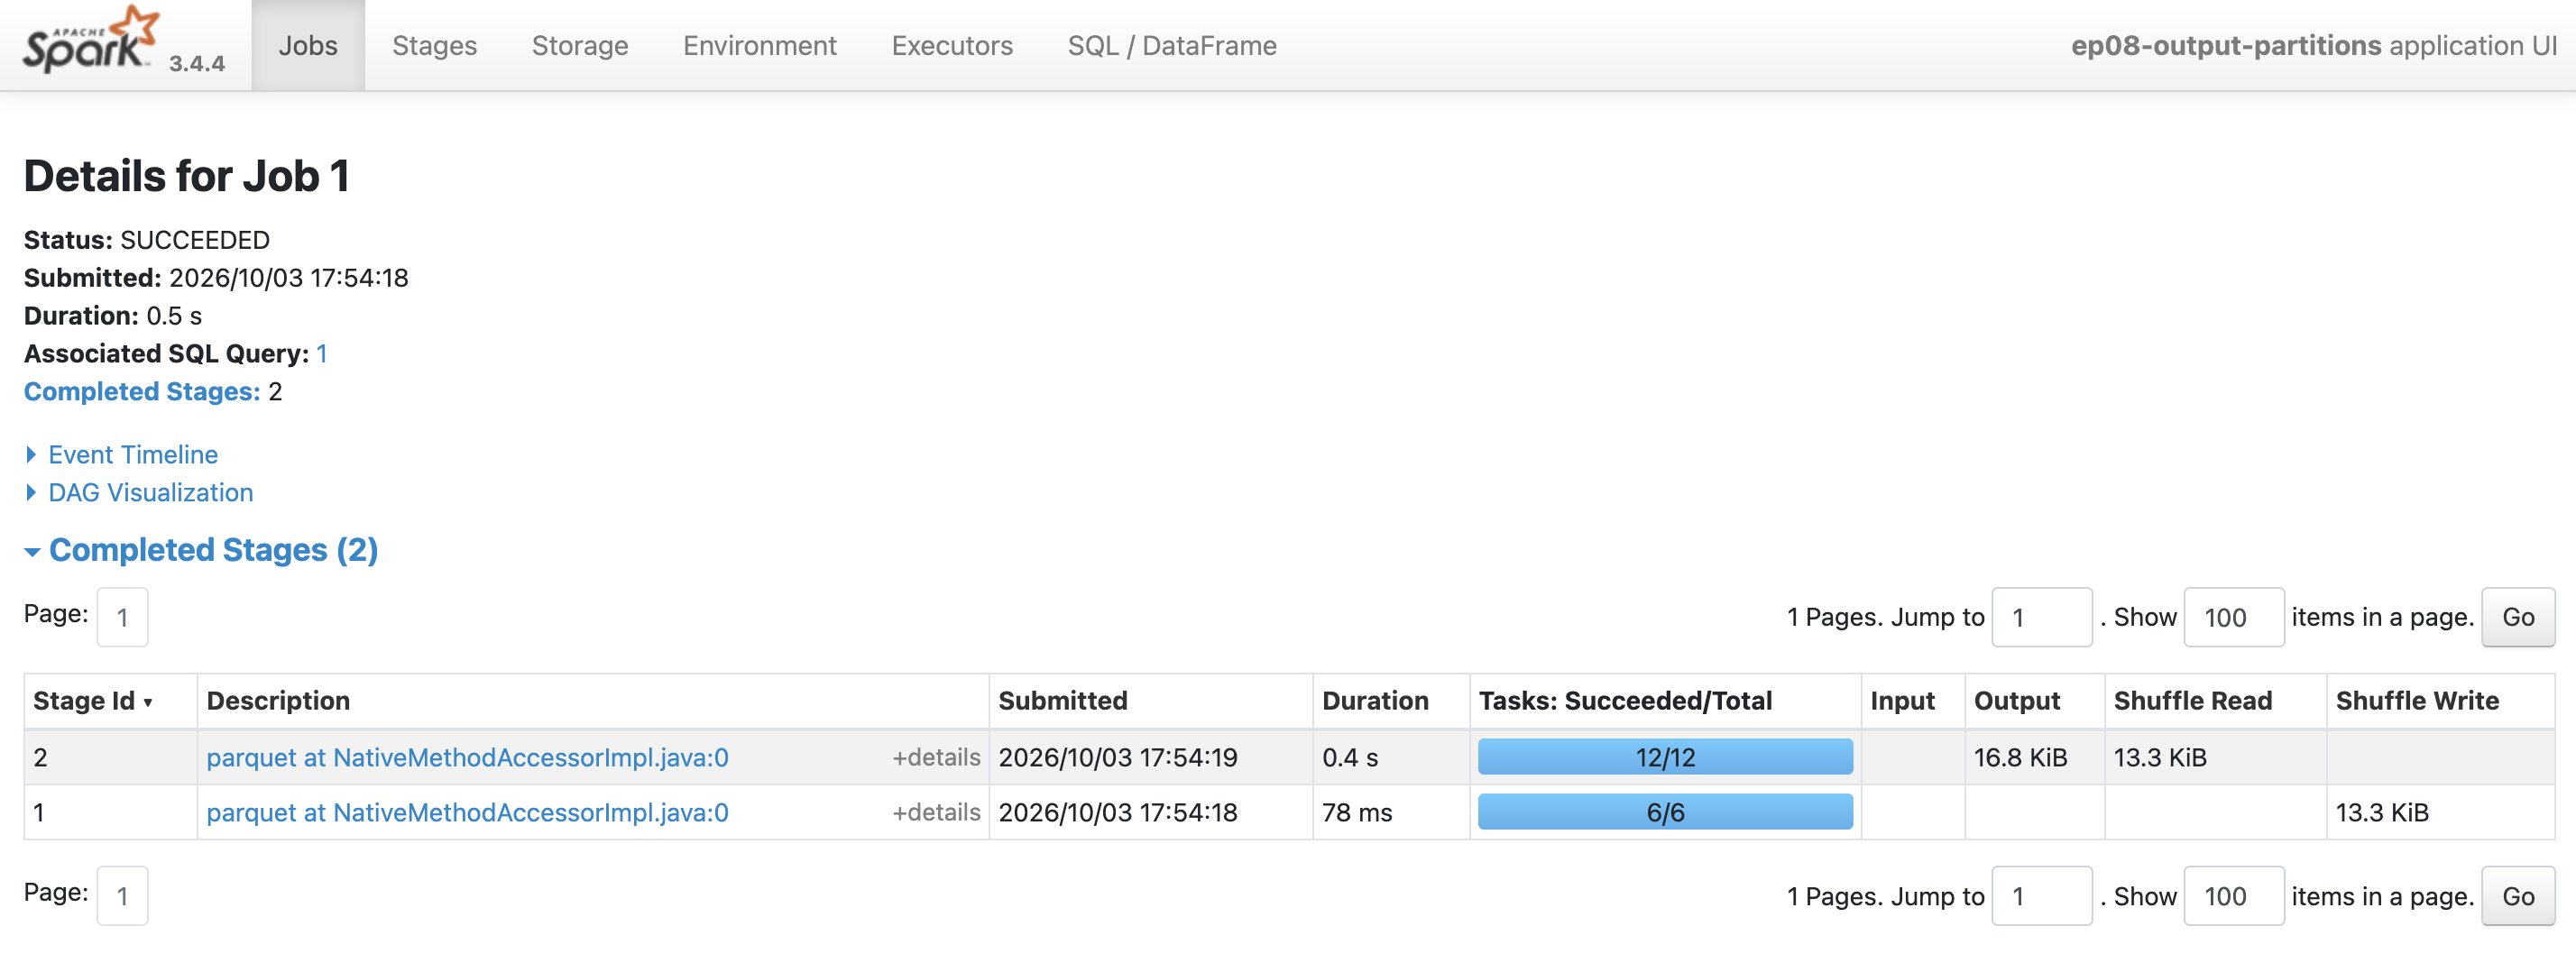
round-robin 主要讓「列數」傾向平均分散,並不保證每個 partition 的 bytes、運算成本或每種 key 都平均。它的價值是主動改變可用的輸出平行度;代價是一次 shuffle。
coalesce 有什麼不同?這次直接把 6 個 source partitions 合成 2 個:
orders.coalesce(2).write.parquet(output_path)
Plan 顯示 Coalesce 2,沒有 Exchange。它把多個既有 partitions 併給較少的下游 task,因此最後由 2 個 write tasks 寫出 2 個檔案。
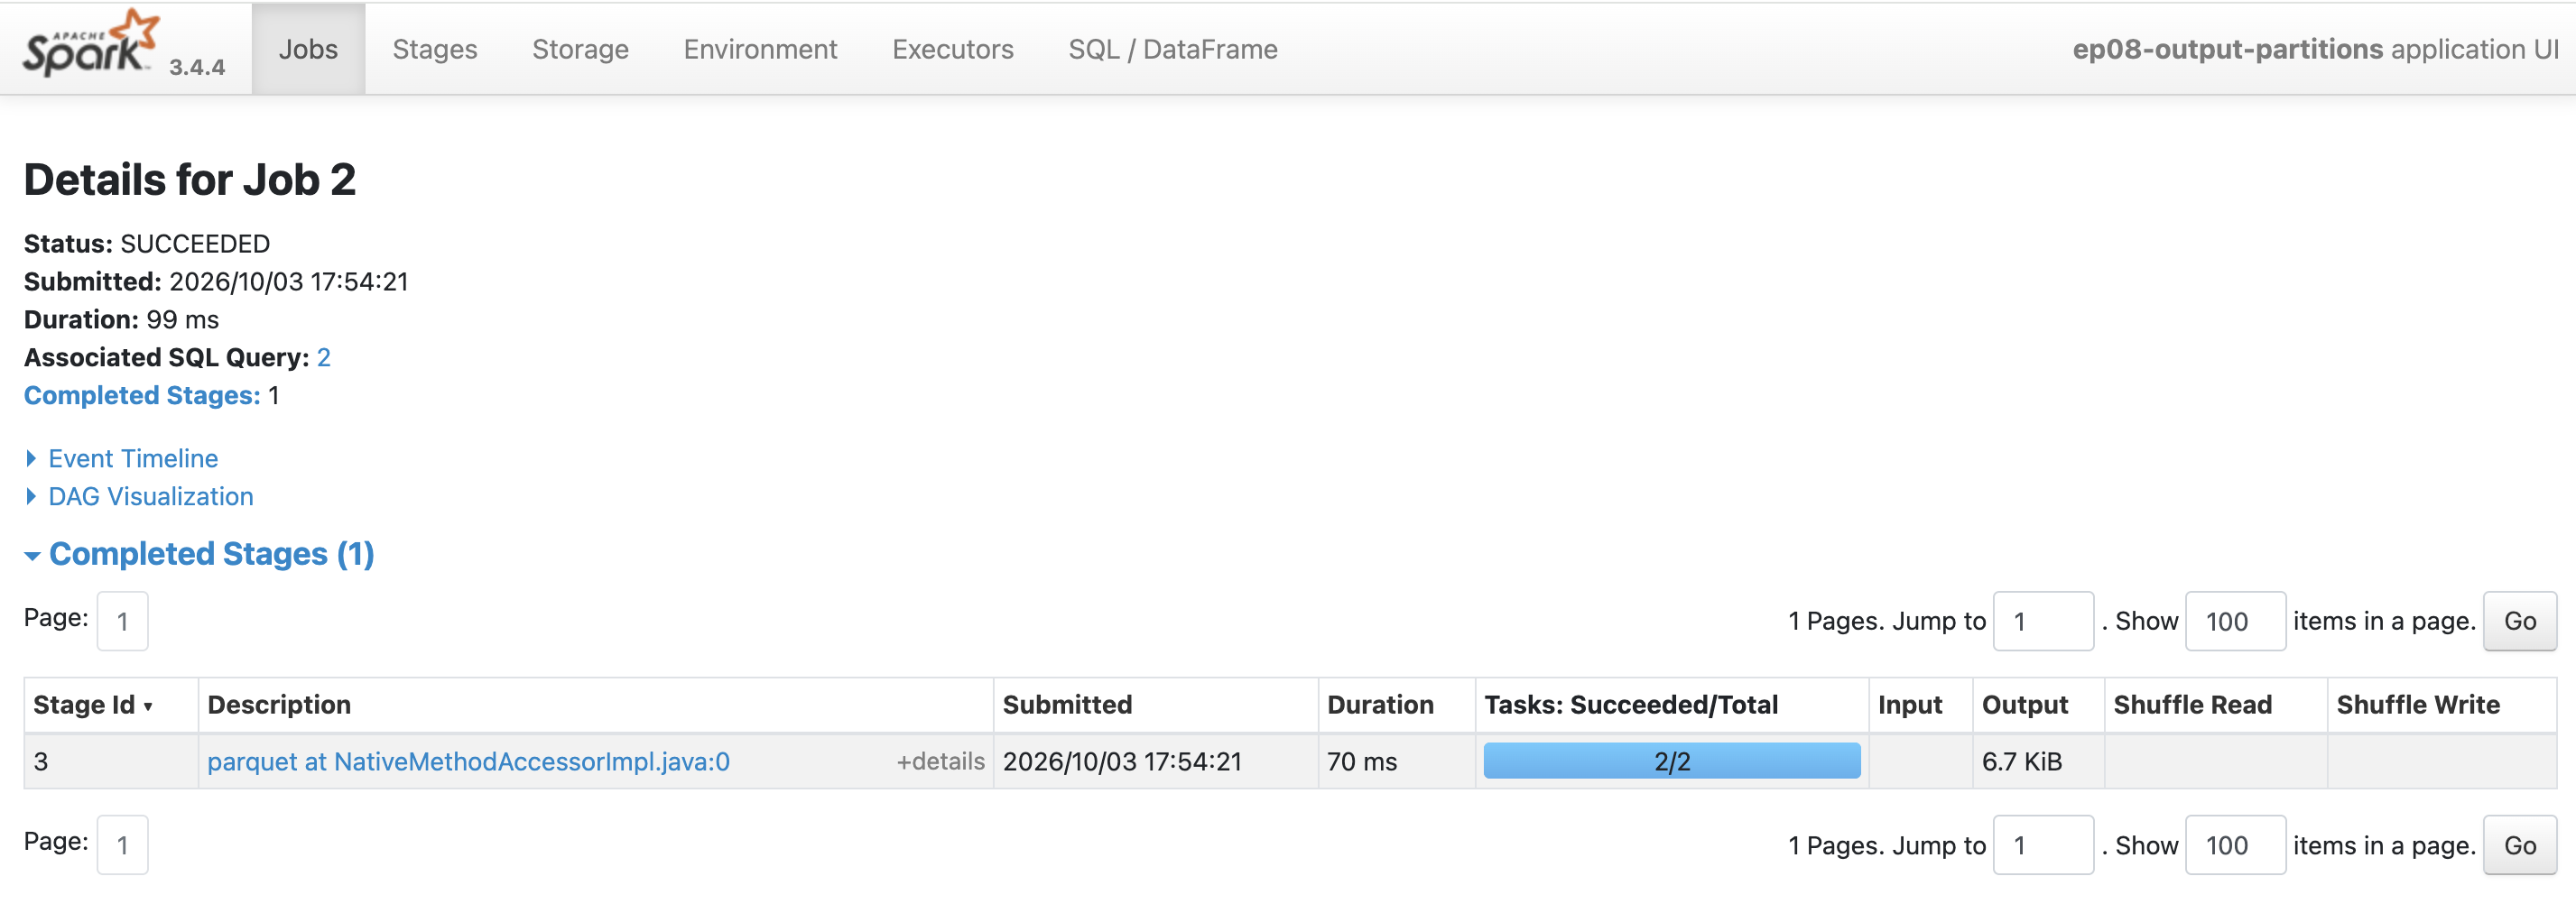
coalesce(n) 適合減少 partition 或檔案數,因為它通常只會將 partition 合併,不會搬資料(因此不需做 shuffle);它不能用來增加平行度。若把大量資料收得太少,write task 可能變得很重、可同時執行的工作也變少。這就是它省下 shuffle 時要交換的代價。
| 目的 | 優先考慮 | 需要留意 |
|---|---|---|
| 增加或重新平均輸出平行度 | repartition(n) |
會 shuffle。 |
| 減少輸出 task/小檔案 | coalesce(n) |
不重新平均資料,可能讓 task 不均。 |
partitionBy 為什麼讓檔案反而變多?接著我試了平常工作常見的模式:
orders.repartition(6).write.partitionBy("region").parquet(output_path)
這裡的 repartition(6) 是無 key 的 round-robin shuffle。它建立 6 個 write partitions,但不保證相同 region 集中。每個 task 都拿到 TW、JP、US 的資料,因此它會在三個目錄各寫一個檔案:
Task 0 → region=TW/、region=JP/、region=US/
Task 1 → region=TW/、region=JP/、region=US/
...
Task 5 → region=TW/、region=JP/、region=US/
結果是 3 個目錄、每個 6 個 data files,共 18 個。Spark UI 中仍然是 6 個 shuffle write tasks 和 6 個下游 write tasks;檔案數多於 task 數,正是因為一個 task 寫進了多個輸出目錄。
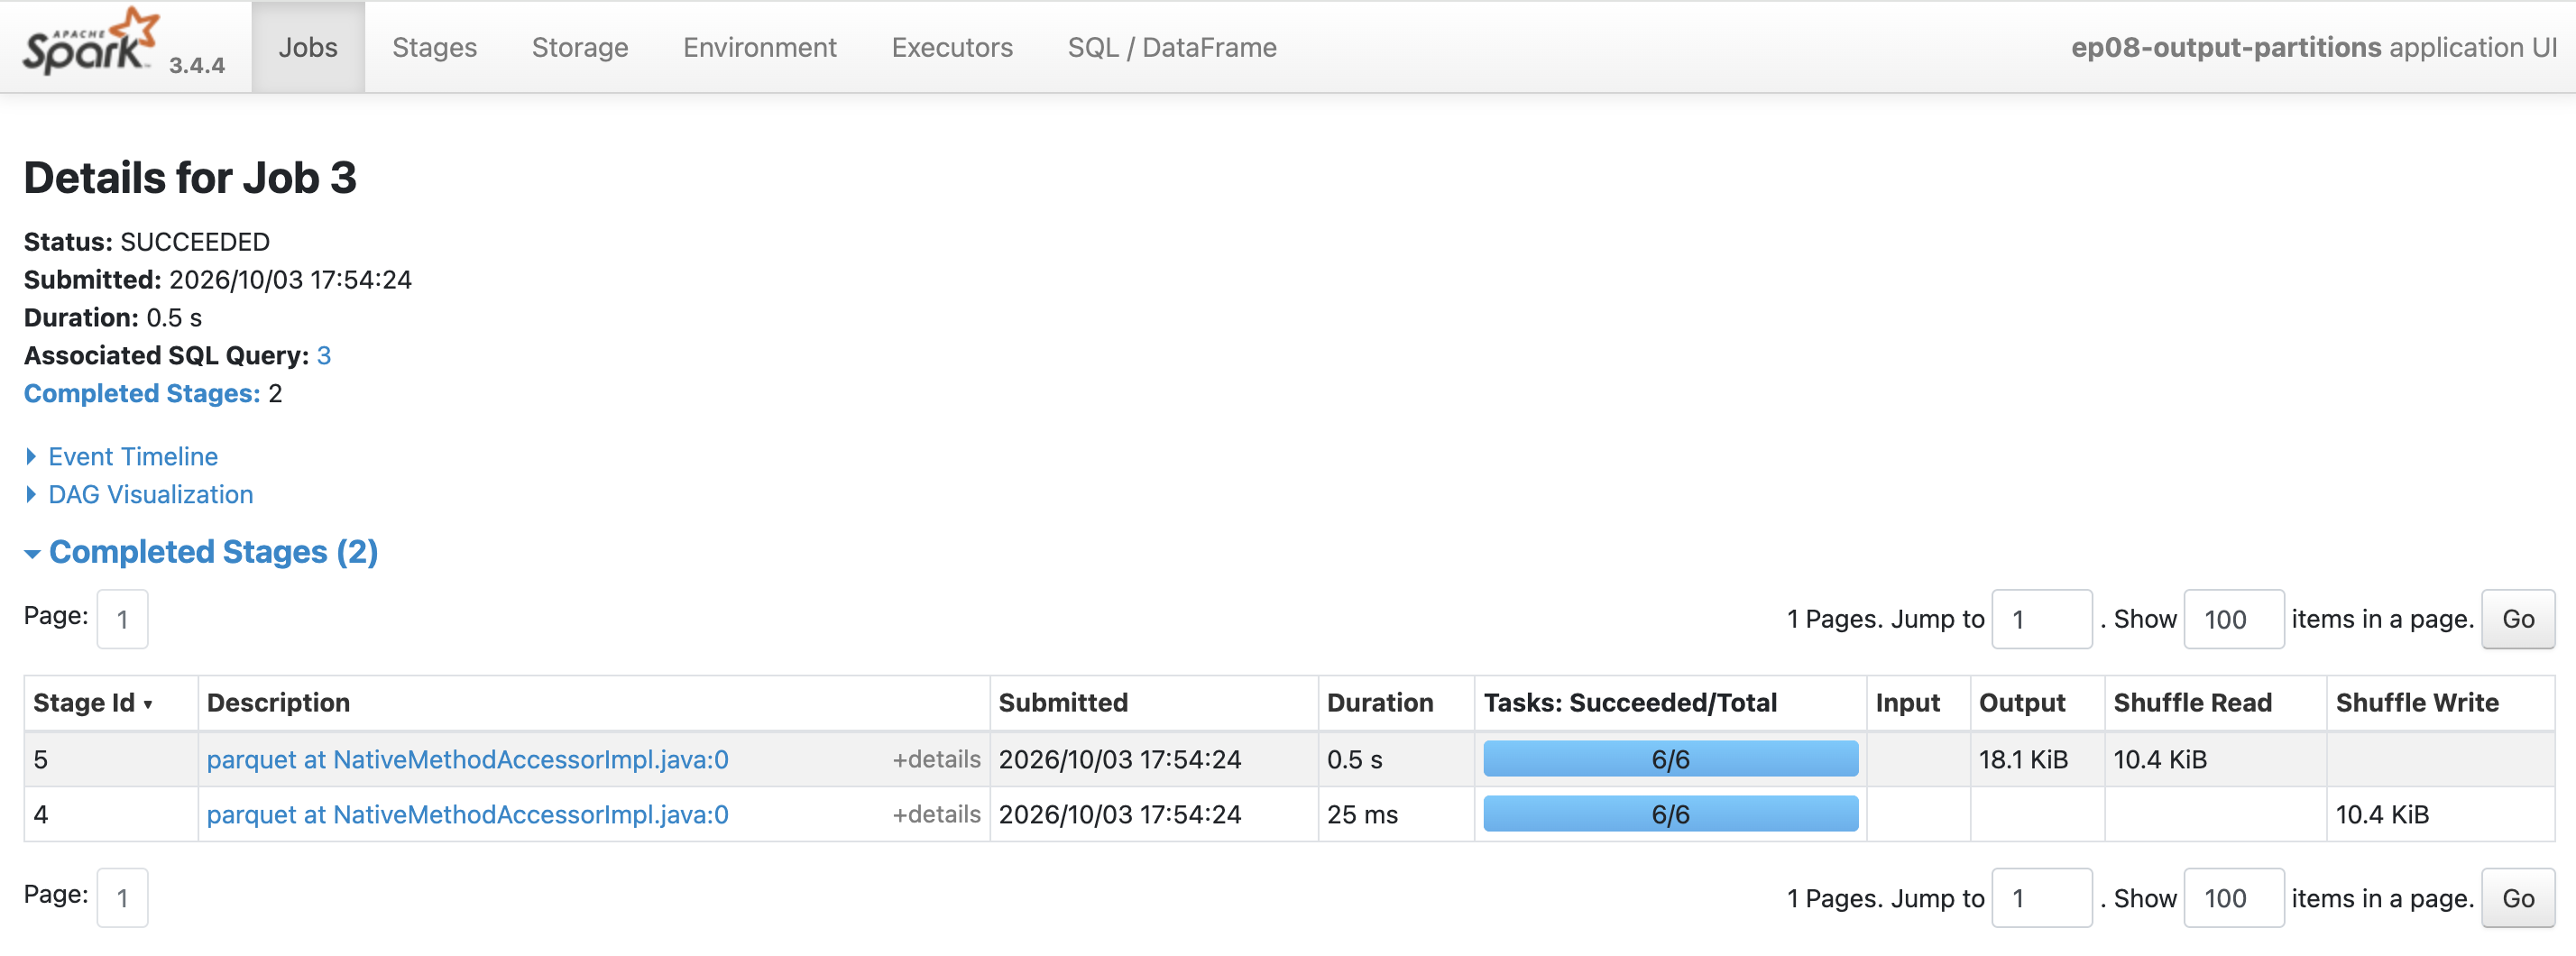
對某一個 (dth, region) 目錄來說,這種模式的檔案數可以理解成:
有拿到這組 dth、region 資料的 write task 數
所以 repartition(32).partitionBy("dth", "region") 並不保證每個目錄恰好有 32 個檔案;如果那組資料恰好分散到全部 32 個 task,才會得到 32 個。資料量不足、部分 task 沒拿到該 key 或額外切檔時,結果都會不同。
改成指定 key:
orders.repartition(3, "region").write.partitionBy("region").parquet(output_path)
hash repartition 保證同一個 region 的資料會前往同一個 Spark partition。因此同一個輸出目錄只會由一個 write task 寫入;這次每個 region 目錄各有一個檔案,共 3 個。
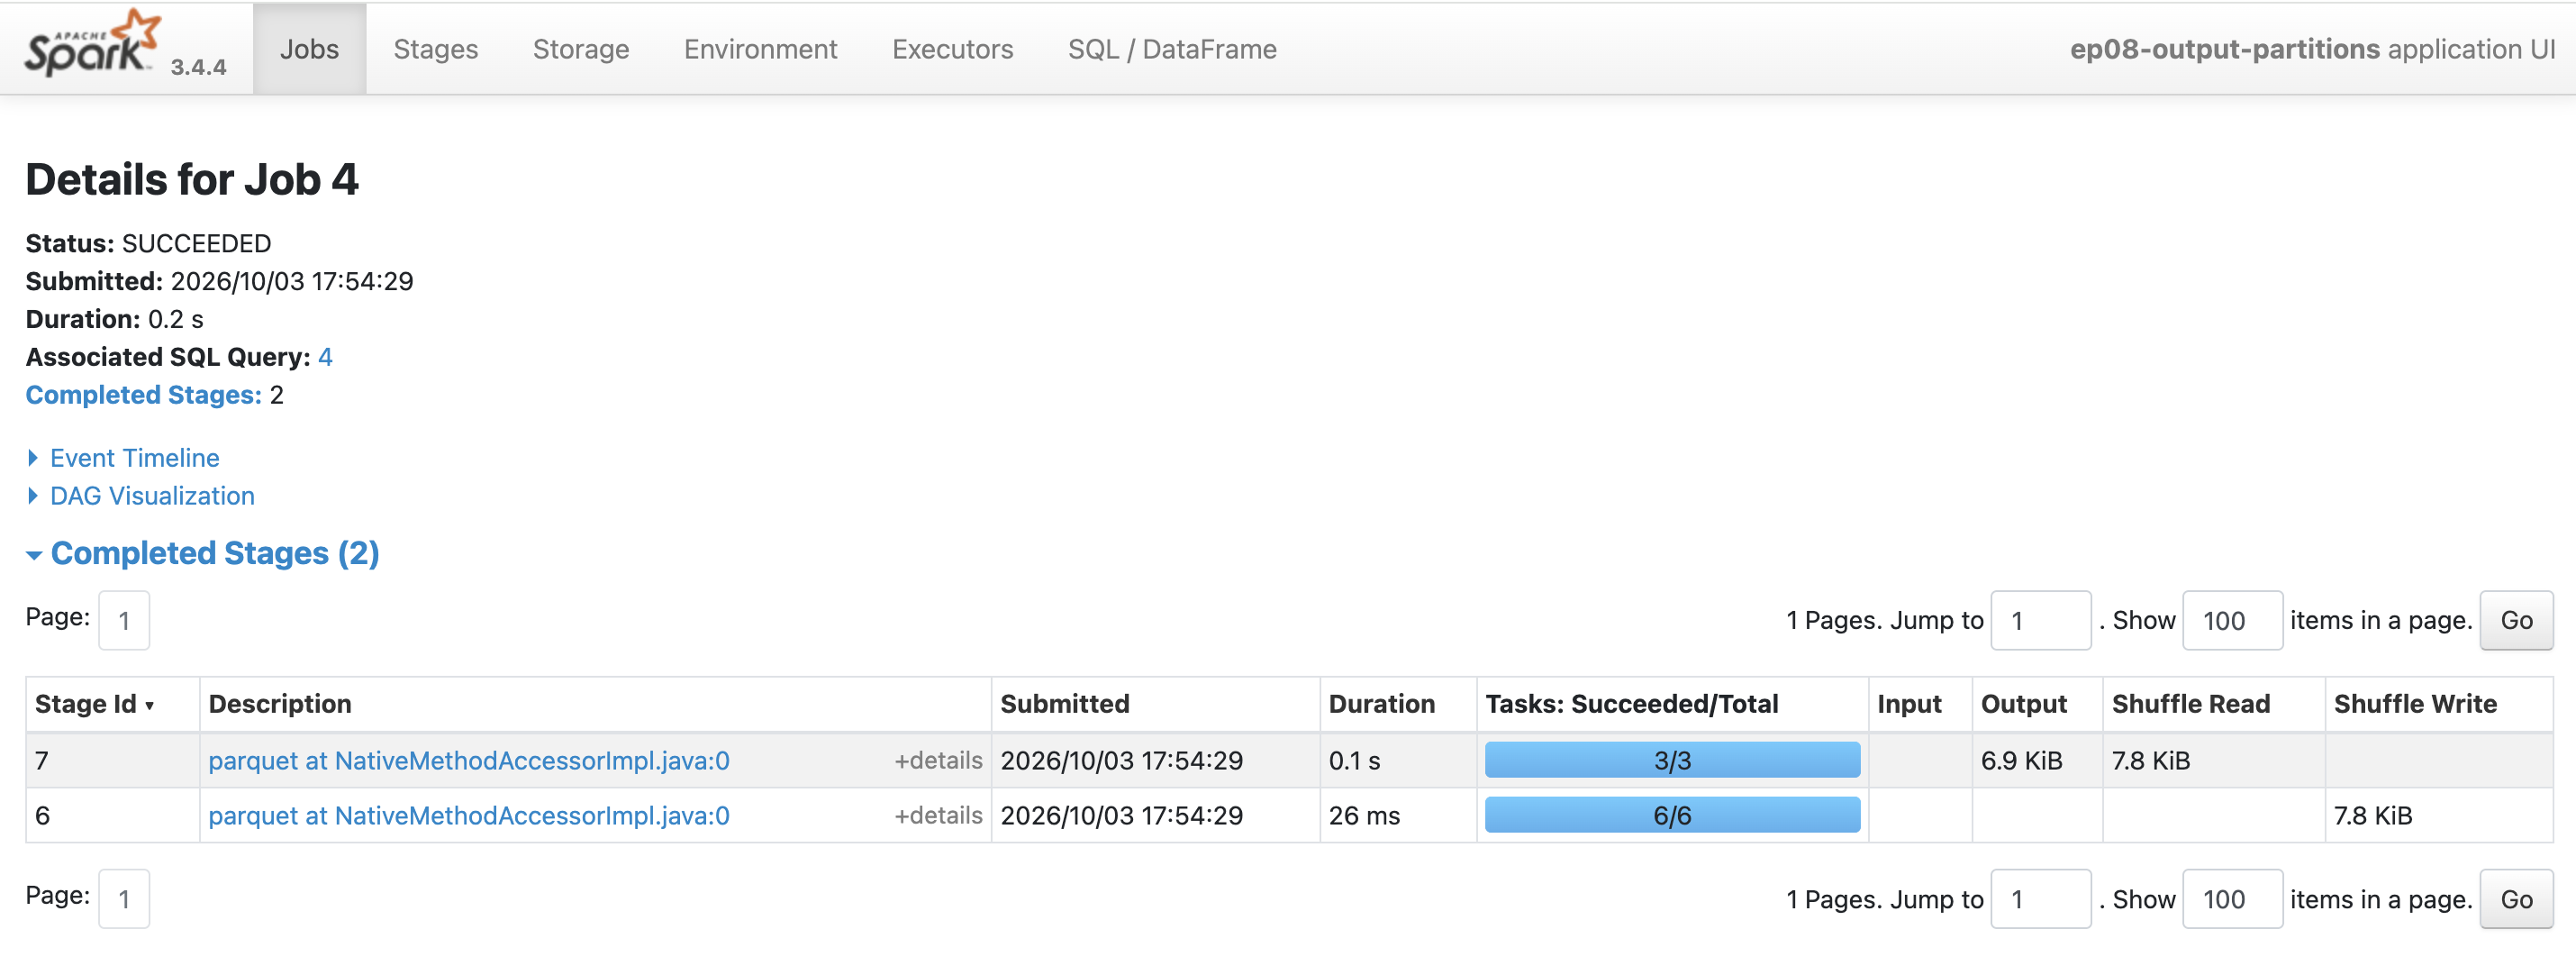
不過 repartition(3, "region") 的 3 是 hash bucket 數,不是「三種 region 各保證一格」。這次三個 region 原本各有 200 筆資料,UI 的 task detail 卻顯示 200 / 400 / 0:JP 和 US hash 到同一個 partition,第三個 task 則完全沒有資料。
同一個 key → 一定前往同一個 partition
不同 key → 可能 hash 到同一個 partition
這個 hash collision 和 local[2] 無關。local[2] 只限制同時執行幾個 task;stage 仍會建立 3 個 task,空的 task 只會很快完成。這也說明了兩件事:keyed repartition 能控制「同 key 集中」的語義,卻不能只靠 n 保證均勻負載;而同 key 集中後,每個輸出 key 的檔案數通常有機會下降。
小檔案容易累積 metadata、開檔與排程成本,過大的檔案又會降低下游讀取的平行度,通常維持每個檔案大小約在 64–128 MiB,是一個 Parquet 輸出的 heuristic rule。它不是通用規則,壓縮率、儲存系統、查詢方式與資料分布都會改變答案。
我會先用預估的壓縮後輸出大小估算初始 write partitions:
目標 partition 數 ≈ 預估壓縮後輸出大小 ÷ 目標檔案大小
例如預估每日輸出 12 GiB、目標 128 MiB,可以先從約 96 個 partitions 開始;再檢查真實檔案大小、檔案數和下游讀取的 Spark UI。
| 階段 | 設定/現象 | 如何理解 |
|---|---|---|
| Input | spark.sql.files.maxPartitionBytes(預設 128 MiB) |
控制讀取檔案時的 input partition 大小,不直接控制輸出檔大小。 |
| Input | spark.sql.files.openCostInBytes(預設 4 MiB) |
Spark 估算讀取小檔案的開啟成本;大量小檔不只是 bytes 小而已。 |
| Stage | spark.sql.shuffle.partitions(預設 200) |
SQL shuffle 的初始 partition 數,不等於固定的輸出檔數。 |
| Stage | AQE | 可合併或調整 shuffle 後 task;它的目標大小不是輸出檔案大小保證。 |
| Output | spark.sql.files.maxRecordsPerFile |
可限制每個檔案最多 records 數,但不能精準控制 MB;預設不限制。 |
實際排查時,我會按這個順序問:
下游是常做全表掃描,還是會用 dth、region 做 partition pruning?
  ↓
`partitionBy` 的輸出 key 有多少不同值或欄位組合?會建立多少目錄?
  ↓
寫入前的 partitioning 是否讓同一組輸出 key 分散到太多 task?
  ↓
寫出後,每個檔案的大小、每個目錄的檔案數和下游 read task 是否合理?
我原本把 repartition(32) 想成「每個輸出目錄會有 32 個檔案」,現在知道它其實只設定了全域 write partitions 的目標數。輸出目錄裡究竟會有多少檔案,還要看每個 task 是否拿到那組 key 的資料。
repartition、coalesce 與 partitionBy 沒有誰永遠正確:前兩者主要安排寫入工作怎麼切,最後一個安排資料怎麼落到目錄。先決定下游怎麼讀,再根據資料量、key 分布與可用資源選擇初始數字,最後用實際檔案與 UI metrics 修正,才比較接近日常維運 Data Pipeline 的做法!
🚀 GitHub:
Ep08|資料寫出前怎麼安排 partition?repartition、coalesce、partitionBy
🚀 spark-learning-lab 系列文章與實作:
https://github.com/jeffery5bai/spark-learning-lab
Apache Spark 3.4.4 — Tuning Guide:
https://archive.apache.org/dist/spark/docs/3.4.4/tuning.html
Apache Spark 3.4.4 — SQL Performance Tuning:
https://archive.apache.org/dist/spark/docs/3.4.4/sql-performance-tuning.html
Apache Spark 3.4.4 — Configuration:
https://archive.apache.org/dist/spark/docs/3.4.4/configuration.html
Mina Andrawos — Optimizing Output File Size in Apache Spark:
https://towardsdatascience.com/optimizing-output-file-size-in-apache-spark-5ce28784934c/

 jeffery5bai

 iThome鐵人賽
 看影片追技術