
Day 18:協程遇上 R2DBC 連線池,小心連線被偷偷耗盡 結尾留下一個問題:協程模型相對於 Thread-per-Request 模型,實際上能帶來多少效能差異?光憑直覺描述、憑情境合理性判斷,並不足夠。今天要正面回答這個問題,但不是直接端出一堆數字,而是先把「怎麼量」這件事想清楚。
Day 04:小結:把 Thread 模型與協程模型放在一起比一次 曾經把 Thread-per-Request 模型與 suspend function 放進同一場促銷活動裡對照過一次,那篇用敘事方式描述兩者面對同樣流量時的行為差異,執行緒是被阻塞還是被釋放去接手其他請求,並且明確表示同樣一批執行緒能撐住的在途請求數量,協程版本會比 Thread-per-Request 版本更多。但那篇同時也誠實補了一句,這段對照只呈現行為差異的方向與原因,不代表協程版本快了幾倍,量化的比較留給今天與明天。
這個承諾,今天要開始兌現。中間隔了將近半個月的內容,Day 15:併發限制,用 Semaphore 保護下游別被打爆 到 Day 18 陸續補齊了節流、逾時取消、背壓、連線池搭配這四種高併發控制手段,讀者手上握著的知識已經足夠豐富,但這些知識目前全部停留在「聽起來有道理」的階段。協程到底比較快多少,快在哪個情境下,又是在什麼條件下才會展現優勢,這些問題如果沒有具體數字支撐,終究只是另一種形式的主觀印象。
在動手設計任何測試之前,得先處理一個經常被忽略卻決定整場比較是否有意義的問題:怎樣才算一場公平的比較。
如果想知道並發模型本身造成的效能差異,就必須確保除了並發模型這個變因之外,其他條件都盡量保持一致。硬體規格要相同,跑在同樣規格的機器上,同一顆 CPU、同樣的記憶體大小;資料庫要相同,用同一套 PostgreSQL 實例,甚至同一批測試資料;請求處理的業務邏輯內容也要對等,查詢幾張表、寫入幾筆資料、有沒有額外的驗證邏輯,兩邊都得一致。少了這層控制,測出來的差異可能來自機器規格落差或邏輯複雜度不同,而不是並發模型本身的差別,整場比較就失去了參考價值,只是兩支條件不同的程式在賽跑,跟協程沒有太大關係。
具體要比較的兩個對象,這裡正式定案下來:一個用 Thread-per-Request 模型搭配傳統阻塞式邏輯撰寫的訂單查詢 API,對照一個用 suspend function 搭配 WebFlux 與 R2DBC 撰寫的同樣功能 API。兩者處理的都是示範情境裡的訂單查詢流程,查詢訂單狀態、確認庫存數量,資料庫查詢的內容盡量對等,唯一刻意保留的差異就是並發模型本身。這個技術堆疊的選擇,直接呼應 [[Day 14:小結:三種技術選型的判斷依據,MVC、WebFlux 各用在哪]] 已經收斂的結論,不需要在這裡重新討論該選哪一種,只是把當時的選型結論實際搬到量測台上驗證一次。
除了控制變因,還需要決定「拿什麼指標來說話」。
壓力測試常見的量測指標有幾個:平均回應時間,顧名思義是所有請求回應時間的平均值,但平均值容易被少數極端值拉走,不一定能反映多數使用者的真實體感;p95 或 p99 這類分位數回應時間,代表有 95% 或 99% 的請求都在這個時間之內完成,比平均值更能呈現尾端使用者的等待狀況,也是這個系列後續會反覆用到的指標;每秒能處理的請求數量,代表系統在單位時間內實際扛住了多少流量;錯誤率,代表請求失敗或逾時的比例,逼近系統上限時這個數字往往會先動起來。這四項指標各自呈現效能的不同切面,明天解讀結果時會回頭引用這裡的定義,這裡不深入統計學細節,只需要先認得這幾個名字。
方法論確立之後,還缺一項工具,用什麼東西實際打出這批流量、量出這些指標。這裡正式定案,全系列壓力測試統一採用 k6。
選擇 k6 有幾個具體理由。
第一,k6 允許用程式化的腳本描述測試情境,而不是只能在圖形介面上點選設定,這代表測試腳本可以被版本控制、可以被複用,今天設計好的腳本邏輯,未來換一個 API 或換一組參數就能重新套用。
第二,k6 能設定漸進式增加虛擬使用者數量的測試階段,這正好符合待會要設計的促銷流量情境,流量不是憑空從零跳到滿載,而是有一個逐步爬升的過程。第三,k6 內建輸出前一節提到的那幾項指標,http_req_duration 對應回應時間分布,包含平均值與各種分位數,http_req_failed 對應錯誤率,不需要額外拼裝其他工具才能拿到這些數字。
這裡不打算展開 k6 的完整功能列表,畢竟今天的重點是測試情境的設計邏輯,而非工具的教學文件。只需要記住這個定案:全系列壓力測試統一採用 k6,此後 《Day 20:實測結果解讀,協程贏在哪裡、代價又是什麼》 解讀結果、《Day 27:壓力測試,驗證系統在高併發下真的撐得住》 的壓測篇,都會延用本篇建立的 k6 測試腳本邏輯與量測方法論,三篇之間的數據可以互相對照,不需要重新選擇工具,也不需要重新設計一套比較方法論。
方法論有了、工具也定案了,接下來要決定的是這場測試具體要模擬什麼樣的流量。這裡直接回扣 Day 01:為什麼高併發後端需要協程,從一個會卡住的 API 說起 開篇建立的畫面:促銷活動開賣的那一刻,倒數計時歸零,大量使用者同時點下確認結帳,請求瞬間湧入訂單查詢與扣庫存服務。
如果測試腳本只固定打一個併發數字,例如從頭到尾都是一百個虛擬使用者,其實沒有反映真實情境。真實的促銷活動有一個流量爬升的過程,平常時段流量平穩,倒數計時結束的瞬間流量開始攀升,一路衝到尖峰,維持一段時間之後才逐漸回落。這個系列設計的測試情境,也應該模擬類似的爬升過程,而不是只測一個固定的併發數字。
具體的設計邏輯是分階段提升虛擬使用者數量,每個階段維持一段時間,觀察系統在這段時間內的反應,再進入下一個階段。第一階段模擬平常流量,虛擬使用者數量偏低,讓系統在低併發下先跑一段時間當作基準;第二階段模擬流量開始攀升,虛擬使用者數量逐步拉高;第三階段模擬促銷尖峰,虛擬使用者數量拉到這次測試設定的最高點,並維持一段時間讓系統的表現穩定下來,才能真正觀察到高併發下的行為,而不是只捕捉到瞬間的抖動;最後一個階段讓虛擬使用者數量逐漸降回來,避免測試腳本自己因為瞬間砍掉大量連線而產生失真的數字。
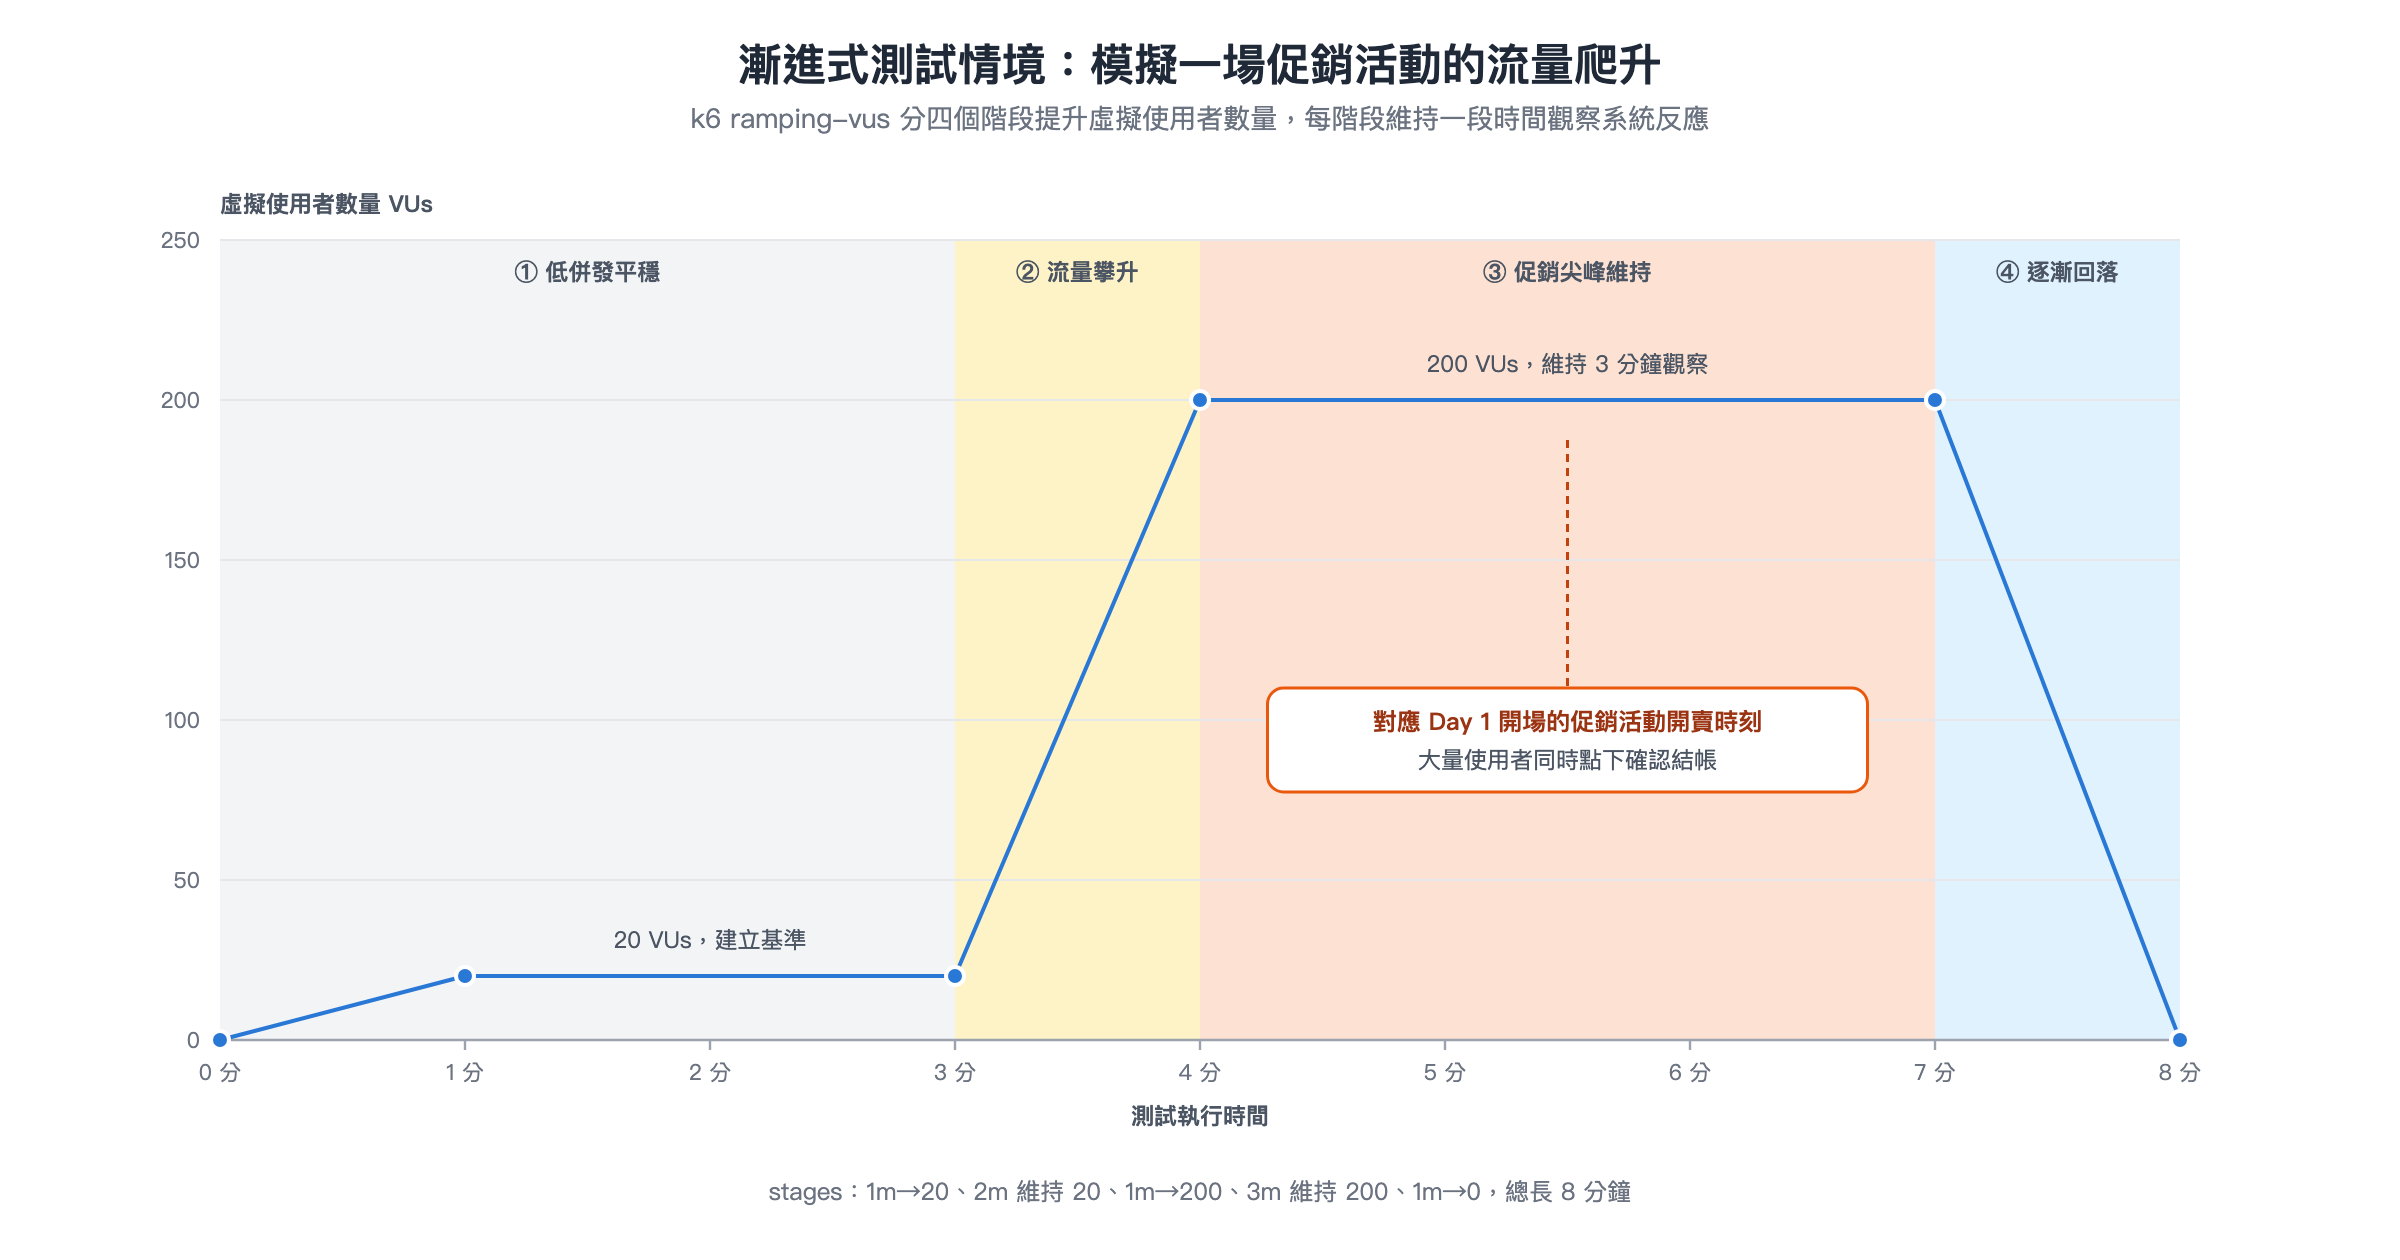
把這個設計邏輯轉成 k6 的腳本骨架,大致長這樣,這裡只展示結構,不是完整可執行的腳本:
export const options = {
  scenarios: {
    order_query_ramp: {
      executor: 'ramping-vus',
      startVUs: 0,
      stages: [
        { duration: '1m', target: 20 },   // 平常流量
        { duration: '2m', target: 20 },   // 維持平常流量觀察基準
        { duration: '1m', target: 200 },  // 促銷倒數結束,流量開始攀升
        { duration: '3m', target: 200 },  // 促銷尖峰,維持觀察系統表現
        { duration: '1m', target: 0 },    // 流量回落
      ],
    },
  },
  thresholds: {
    http_req_duration: ['p(95)<1000'],
    http_req_failed: ['rate<0.05'],
  },
};

export default function () {
  http.get(`${BASE_URL}/api/orders/${orderId}`);
}
stages 陣列裡的每一段,對應的正是前面描述的那幾個階段,duration 決定這個階段維持多久,target 決定這個階段結束時虛擬使用者數量要爬升或回落到多少。thresholds 則是預先設定的及格門檻,例如 p95 回應時間要低於一秒、錯誤率要低於百分之五,這一段的門檻數字只是示意用的骨架,實際要設多嚴格,得等明天看到真實數字之後再回頭校準,這裡先不深究。這支腳本會分別套用在 Thread-per-Request 版本與協程版本這兩個對象上,兩邊的 stages 設定完全相同,唯一的差別是打的 API 端點背後跑的是哪一種並發模型。
這裡要明確界定今天的任務邊界。今天只負責把測試情境設計出來,說明會測什麼、怎麼測、為什麼這樣測,不呈現任何實際測試結果數字,也不做任何結果解讀。協程模型最終在哪個階段開始展現優勢,又或者在哪個地方付出了額外的代價,這些問題今天先不回答,故意先按下不表,留給明天用實際數據來說話。
回頭看今天走過的路。先建立了公平比較需要哪些條件,控制變因、對等的業務邏輯、明確定案的比較對象;接著列出量測指標的選擇,平均回應時間、p95 或 p99 分位數、每秒請求數量、錯誤率;然後正式定案 k6 作為全系列的壓測工具,並說明了選用理由;最後把促銷流量的爬升過程設計成具體的測試階段,寫成了腳本骨架。
方法論建立好了,工具定案了,測試情境也設計完成,今天要做的事情到此為止。下一篇會實際跑一次今天設計的測試,誠實解讀數據呈現出的結果:協程模型贏在哪裡,又付出了什麼代價。


 iThome鐵人賽
 看影片追技術