
Day 21:小結,高併發控制的工具箱總覽,準備進實戰 把併發深化期七天累積的節流、逾時取消、背壓、連線池搭配與 k6 量測方法論收攏成一份完整的工具箱,也提前說了一件事:從今天起,系列不會再提供可下載的完整原始碼,取而代之的是逐日聚焦的程式碼片段。工具箱整理好了,該動手蓋東西了。
前四個階段走下來,地基期、核心觀念期、生態整合期、併發深化期,累積的觀念其實已經相當完整。suspend function 怎麼暫停又恢復、Structured Concurrency 怎麼收斂協程的生命週期、WebFlux 與 R2DBC 怎麼讓整條鏈路不阻塞執行緒、Semaphore 與逾時取消怎麼保護系統不被瞬間流量打垮,這些積木一塊一塊都已經到手。但積木終究只是積木,散落在 21 天的文章裡,各自獨立成篇,還沒有被組裝成一個看得見完整樣貌的東西。
今天要做的事情,就是把這些積木收斂進一個真正具名的專案。這個專案從今天起正式定案名稱:訂單服務實戰整合版,它就是 Day 01:為什麼高併發後端需要協程,從一個會卡住的 API 說起 定案的示範情境「訂單查詢與扣庫存服務」正式收斂成的具體專案骨架,兩者是同一件事在不同階段的呈現,沒有另起爐灶。Day 1 那個會在促銷活動瞬間卡住的 API,21 天以來被拆解成各種切片,查詢訂單、確認庫存、扣減庫存、確認優惠資格、發送通知,每一天只取用其中一小塊來說明一個觀念。從今天開始,這些切片要被組織進同一套分層架構,變成一個讀者可以在腦中描繪出完整輪廓的專案,不再只是一堆各自獨立的示範程式碼。
接下來八天,Day 23 到 Day 30,都會在今天建立的這個骨架上持續加東西。今天的任務不是一次到位、把所有前面學過的機制通通塞進去,而是先把地基打好:確立技術堆疊、確立分層架構、確立一個能真正跑起來的最小版本。地基打得夠扎實,後面加東西才不會東拼西湊。
在往下看技術堆疊與程式碼之前,有一件事需要先講清楚,尤其如果你原本期待接下來會看到一個 GitHub 連結,點進去就能複製整包程式碼跑起來,這裡要坦白說明為什麼系列不打算這樣做。
這個系列從 Day 1 開始想傳達的核心,一直是「看到一個高併發情境時,知道該用哪個協程機制、為什麼用它、不用會有什麼代價」,重點放在每一個設計決策背後的判斷依據,而不是提供一份可以直接貼上去執行的現成專案。如果真的附上一整包可下載的原始碼,很容易發生一件事:讀者的注意力會被引導去比對版本號碼是否一致、環境變數設定對不對、資料庫連線字串要改哪裡,這些瑣碎但必要的環境細節,會把原本該花在理解觀念上的注意力吃掉一大半。
說白了,這個安排是務實的取捨,不是內容縮水。接下來八天,每一篇都會呈現與當天主題直接相關的關鍵程式碼片段,搭配完整的設計理由說明,告訴你為什麼這段程式碼要這樣寫、這個判斷依據是什麼。你可以依照這些片段與說明,在自己熟悉的開發環境裡,組裝出屬於你自己的實作,甚至換掉某些細節去符合你手上專案的實際狀況。這種做法比丟一包程式碼給你,更貼近這個系列一路以來想建立的閱讀方式:理解原理,而非照抄程式碼。
前四個階段陸續定案了不少技術選型,這裡把它們收攏成一張完整的清單,這是全系列技術堆疊最完整的一次總覽陳述,Day 23 到 Day 30 談到具體技術時會直接引用這裡的結論,不再重新列舉。
並發程式設計的基礎是 Kotlin 協程,從地基期的 Day 03:第一個 suspend function,協程到底暫停了什麼 建立 suspend function 的心智模型,到核心觀念期定案的 Coroutine Scope、Structured Concurrency、Dispatchers、Coroutine Context,這一整套機制是這個專案所有並發邏輯的語言層基礎。Web 框架這一層,選型結果是 Spring Boot 3 搭配 Day 11:WebFlux 是什麼,協程與反應式模型的分工 定案的 WebFlux 反應式模型,Day 14:小結:三種技術選型的判斷依據,MVC、WebFlux 各用在哪 已經把選型判斷依據收斂清楚:這個示範情境是全新設計、高併發、等待密集的服務,最適合從底層就是非阻塞的組合,這也是為什麼不採用 Spring MVC 過渡方案。資料庫存取這一層,選型結果是 Day 12:R2DBC,讓資料庫存取也不阻塞執行緒 定案的 R2DBC 搭配 PostgreSQL,這裡也重申一次已經定案的排除項目:全系列不引入 Redis,任何需要快取或分散式協調的情境,一律回頭用資料庫層級機制或協程內建工具處理。
分層架構延續一般 Spring Boot 專案熟悉的三層樣貌,職責劃分清楚。Controller 負責接收 HTTP 請求,把請求參數轉交給下一層,再把結果包裝成回應送回去,不放任何業務邏輯。Service 負責業務邏輯本身,包含後續會陸續加上的協程編排,例如平行呼叫、節流、逾時控制,都會落在這一層。Repository 負責資料庫存取,直接沿用 Day 12:R2DBC,讓資料庫存取也不阻塞執行緒 已經介紹過的 Spring Data R2DBC 寫法。這三層各司其職,是接下來八天所有程式碼片段共同依循的骨架,Day 23 到 Day 30 不會重新選型,也不會更換分層方式,讀者可以把這套技術堆疊與分層樣貌當成穩定不變的地基。
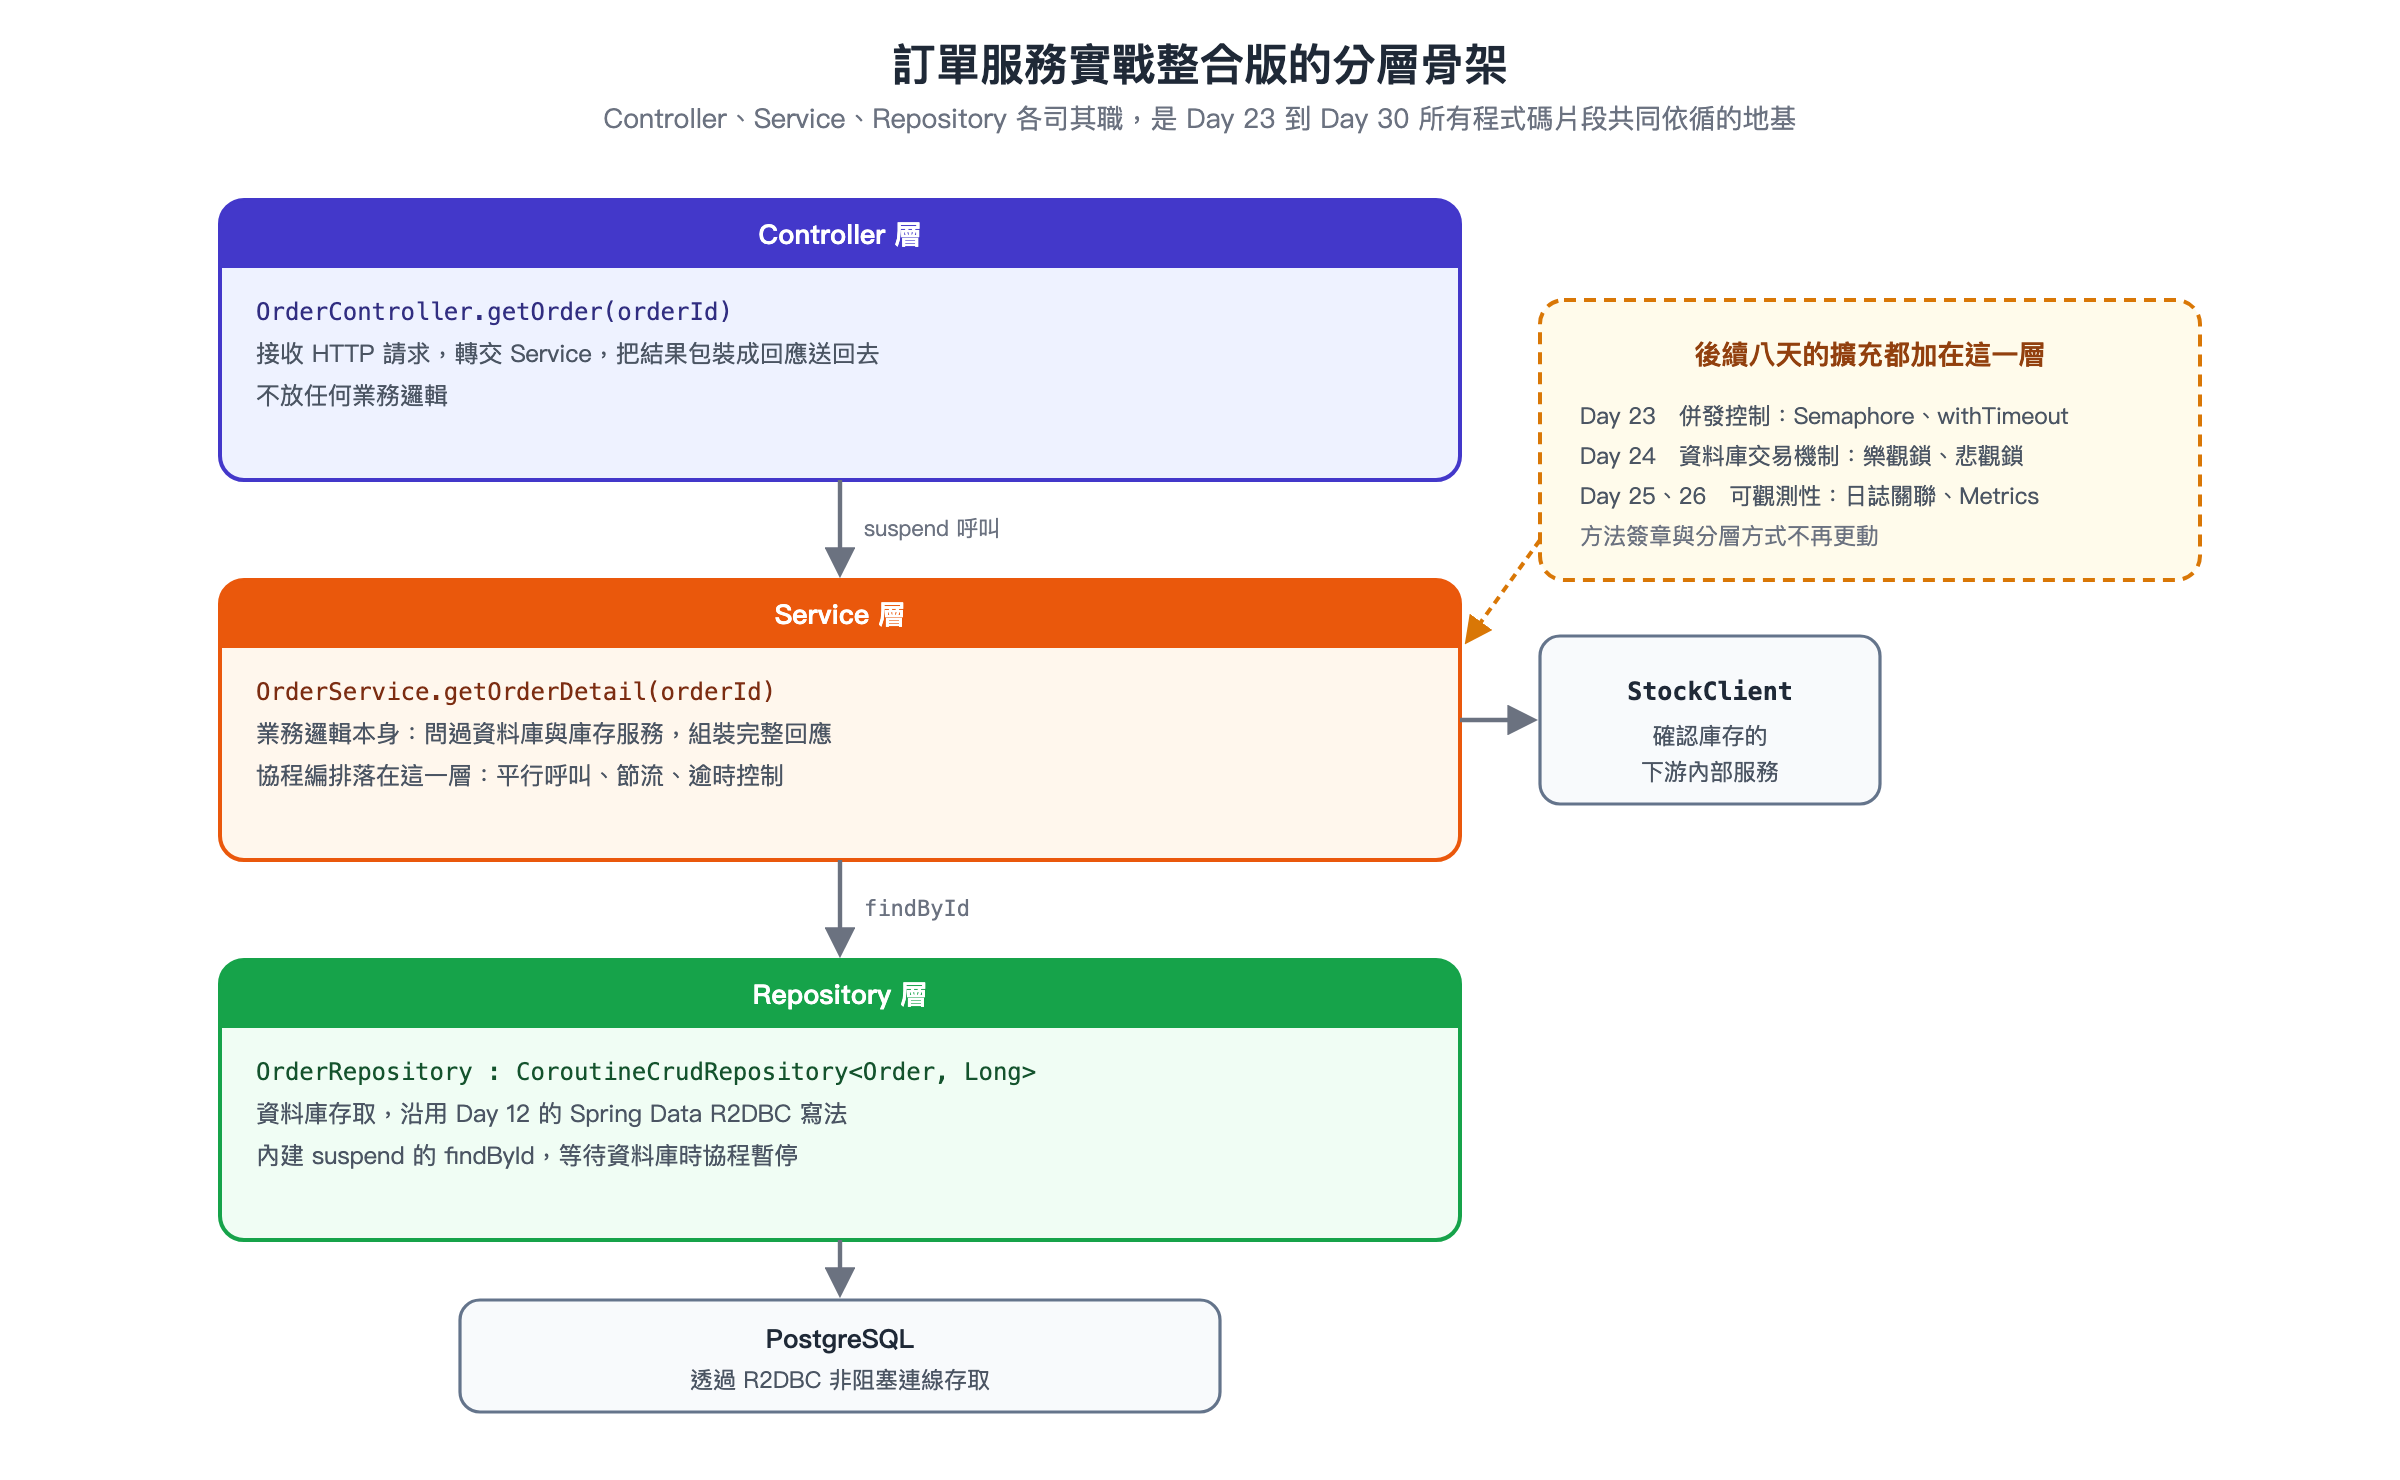
技術堆疊與分層架構的樣貌講清楚了,接下來把它落成具體程式碼。這裡只示範查詢單筆訂單這個最基本的 API 端點,刻意保持精簡,只呈現分層骨架與基本呼叫關係,不加入完整的例外處理、併發控制或日誌,那些是接下來幾天要陸續補上的工作。
第一段,Controller 層。這一層的職責很單純:接收請求路徑上的訂單編號,呼叫 Service 層對應的方法,把結果原封不動回傳出去。
@RestController
@RequestMapping("/orders")
class OrderController(
    private val orderService: OrderService,
) {
    @GetMapping("/{orderId}")
    suspend fun getOrder(@PathVariable orderId: Long): OrderDetailResponse {
        return orderService.getOrderDetail(orderId)
    }
}
getOrder 宣告成 suspend function,延續 Day 10:在 Spring MVC 裡寫 suspend function,能動但有代價 與 Day 11:WebFlux 是什麼,協程與反應式模型的分工 已經建立的寫法,Spring 框架本身原生支援在 Controller 方法上使用 suspend function,不需要額外包裝轉換。這個方法之後不會再變動簽章,orderId 這個參數與 OrderDetailResponse 這個回傳型別,會是接下來八天所有擴充動作共同依附的錨點。
第二段,Service 層。這一層是業務邏輯真正發生的地方,也是接下來八天絕大多數新增程式碼會被加進去的位置。今天的最小版本裡,getOrderDetail 只做兩件事:呼叫 Repository 取得訂單資料,再呼叫確認庫存的下游服務取得庫存狀態,組裝成一份完整的回應。
@Service
class OrderService(
    private val orderRepository: OrderRepository,
    private val stockClient: StockClient,
) {
    suspend fun getOrderDetail(orderId: Long): OrderDetailResponse {
        val order = checkNotNull(orderRepository.findById(orderId))
        val stockStatus = stockClient.checkStock(orderId)
        return OrderDetailResponse(
            orderId = order.id,
            status = order.status,
            stockAvailable = stockStatus.available,
        )
    }
}
這裡有一個小細節值得說明。CoroutineCrudRepository 的 findById 回傳型別是可為 null 的 Order?,畢竟查無此訂單編號原本就是合理的結果之一。骨架這裡用 checkNotNull 直接展開成非 null 的 Order,只是為了讓這個最小版本能夠通過編譯、順利運作,並不是這個系列對「訂單查無資料」這種情況的正式處理方式,真正的例外處理與錯誤回應設計不在今天的範圍內。
orderRepository.findById(orderId) 與 stockClient.checkStock(orderId) 這兩個呼叫,正是後續章節會反覆回來動手腳的位置。Day 15:併發限制,用 Semaphore 保護下游別被打爆 定案的 Semaphore 節流、Day 16:逾時與取消,讓卡住的協程別拖垮整個系統 定案的逾時機制,都是包裹在呼叫下游服務這類動作外層的手段,checkStock 這個呼叫下游內部服務的動作,正是它們天生該裝上去的位置。今天先讓它以最直白、沒有額外防護的方式呼叫,把這個位置留白,等 Day 23 回來補上。
第三段,Repository 層。這一層直接沿用 Day 12 已經介紹過的 Spring Data R2DBC 寫法,用 CoroutineCrudRepository 作為基底介面。
interface OrderRepository : CoroutineCrudRepository<Order, Long>
今天的最小版本裡,OrderRepository 不需要宣告任何額外的自訂查詢方法,CoroutineCrudRepository 內建的 findById 這個 suspend function,已經足夠支撐查詢單筆訂單這個最基本的需求,這也是 Day 12 已經解釋過的行為:呼叫這個方法時,協程會在等待資料庫回應的那一刻暫停,執行它的執行緒被釋放去處理其他工作,等結果送回來才恢復執行。這裡不重新解釋 R2DBC 的運作原理,只需要知道這個介面已經站在前面定案的技術堆疊上,穩穩地能動。
這三段程式碼合起來,就是接下來八天要反覆擴充的共同基礎。OrderController.getOrder、OrderService.getOrderDetail、OrderRepository,這三個名稱與它們目前的方法簽章,從今天起不會再重新展示一次完整版本,後續文章會直接說「在這個方法的基礎上,加上以下這段」,然後只呈現新增或修改的那一小塊。這個骨架的樣貌,值得在腦中留一個清楚的印象。
三段程式碼串起來,這個最小版本已經能真正運作:一個查詢訂單的請求進來,Controller 接住,交給 Service,Service 依序問過資料庫與庫存服務,組裝結果回傳,整條鏈路從頭到尾都是非阻塞的,也用上了前面四個階段辛苦建立的每一項技術選型。
但說白了,它現在還只是一個空殼子。這個骨架能動,不代表它已經具備任何高併發防護。如果直接把它丟進 Day 1 描述的那個促銷流量情境,數千個查詢請求同時湧入,stockClient.checkStock 這個呼叫依然會毫無節制地被同時發起,前面辛苦定案的 Semaphore 節流還沒有真正裝進 getOrderDetail 裡;如果確認庫存的下游服務剛好卡住不回應,也沒有任何逾時機制會主動放棄這個等待。骨架本身的非阻塞特性,解決的是執行緒不被白白浪費的問題,流量控制與資源保護並不會因此自動發生,Day 15:併發限制,用 Semaphore 保護下游別被打爆 當時講的那個道理,今天這個骨架依然完整適用。
今天蓋好的是房子的骨架與水電管線,能通水通電,但還沒有裝上任何一道防盜門或保險絲。下一篇開始,要把併發深化期學到的那些控制手段,一項一項實際裝進 OrderService.getOrderDetail 這個方法裡。
《Day 23:把併發控制手段實際裝進訂單服務》 見。


 iThome鐵人賽
 看影片追技術