
在傳統 RSA 密碼系統中,若公鑰參數設定不當,即使採用了極長的模數 N,攻擊者依然能在完全不進行質因數分解的情況下直接還原明文。
本次以 picoCTF 的 miniRSA 為例,演示當公鑰指數 e 過小且明文未適當填充時所產生的安全性漏洞。
標準 RSA 加密機制:
c = (m^e) mod N
其中:
低指數漏洞 (Small e Attack)
當題目設定 e = 3 且明文 m 較短時,導致 m^e 計算出來的數值甚至小於模數 N(即 m^3 < N)。
在此情況下,模運算 mod N 完全失效:
c = (m^3) mod N => c = m^3
這意味著密文 c 只不過是明文 m 的三次方。攻擊者只需要在一般整數域對密文 c 開三次方根 (c^(1/3)),即可瞬間還原明文:
m = c^(1/3)
補充:若 m^3 稍微大於 N,公式會變成 c = m^3 - k * N。只需遍歷搜尋微小的偏置值 k = 0, 1, 2, ...,計算 (c + k * N)^(1/3) 即可解密。
讀取 ciphertext 檔案內容後,觀察各項參數的數值特徵:
由於 c 的長度顯著小於 N,極度懷疑 m^3 未超越 N,符合低指數攻擊條件。
利用 C 語言高精度加速庫 gmpy2 進行開次方根攻擊:
import re
import gmpy2
from Crypto.Util.number import long_to_bytes

# 1. 解析 ciphertext 檔案參數
with open("ciphertext", "r") as f:
    content = f.read()

numbers = [int(n) for n in re.findall(r'\d+', content)]
N = [n for n in numbers if len(str(n)) > 100][0]
e = [n for n in numbers if n < 1000][0]
c = [n for n in numbers if n != N and n != e][0]

print(f"[*] 讀取參數成功:")
print(f"    N 位數 = {len(str(N))}")
print(f"    e = {e}")
print(f"    c 位數 = {len(str(c))}")

print("\n[*] 正在啟動 Small e 低指數開根號攻擊 (k-search)...")

# 2. 搜尋 k 使得 (c + k * N) 可以被整開 e 次方
found = False
for k in range(100000):
    val = c + k * N
    root, is_exact = gmpy2.iroot(val, e)
    if is_exact:
        flag = long_to_bytes(int(root))
        print(f"\n[🎯] 攻擊成功!在 k = {k} 時找到完全次方根!")
        print(f"[🎯] Flag 為:\n{flag.decode('utf-8', errors='ignore')}\n")
        found = True
        break

if not found:
    print("[-] 搜尋範圍內未找到解,請調大 k 的範圍。")
    ```

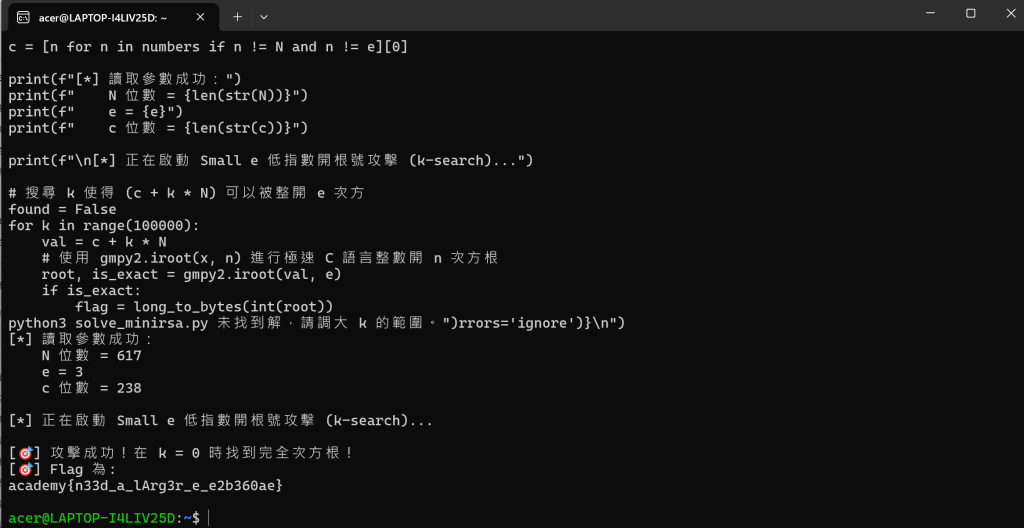
### 步驟三:執行結果執行腳本後,於 $k = 0$ 時瞬間命中解答:

 ```Plaintext
 [*] 讀取參數成功:
    N 位數 = 617
    e = 3
    c 位數 = 238

[*] 正在啟動 Small e 低指數開根號攻擊 (k-search)...

[🎯] 攻擊成功!在 k = {k} 時找到完全次方根!
[🎯] Flag 為:
academy{n33d_a_lArg3r_e_e2b360ae}
選用標準公鑰指數:避免使用 $e = 3$ 等小指數,建議統一採用標準安全的質數 $e = 65537$(即 $2^{16} + 1$,0x10001)。
導入安全填充機制 (Padding):在 RSA 加密前應強制使用 OAEP (Optimal Asymmetric Encryption Padding) 或 PKCS#1 v1.5 填充機制,確保即使原始明文很短,加密前也會補滿至與模數 $N$ 等長,防止數學結構直接暴露。


 iThome鐵人賽
 看影片追技術