
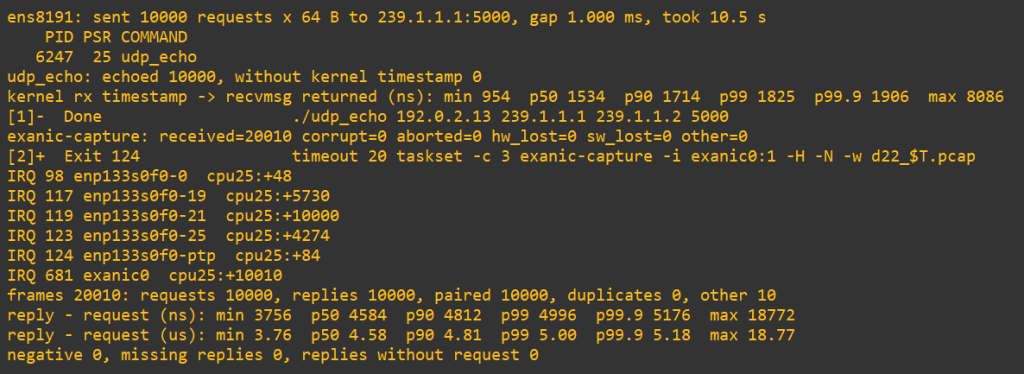
一台為低延遲調過的主機,用 kernel 網路堆疊收一個封包、回一個封包,中位數 4.58 µs,是交換器 port-to-port 363 ns 的 12.6 倍。之前講主機七關時預測過,沒人搶 CPU 的情況下,主機這一段會比交換器大 1 到 2 個數量級,這次落在下緣。64 bytes 有 99.9% 的封包在 5.18 µs 以內,只比中位數多 0.6 µs;比這慢很多的只有兩種:每一輪的第一個封包,以及程式被搬到另一顆 CPU 的那一筆。
今天量的是伺服器上那張接在 Et3 的 Solarflare X4522,收發都走 kernel 網路堆疊。量測端是同一台伺服器上的 ExaNIC X25:port0 接 Et1 負責送請求,port1 接 Et2 負責打時戳。三個 port 在同一個 VLAN,交換器刻意不設 querier,讓多播洪泛到每個 port,請求才能同時送到主機跟 port1。
udp_echo(C 寫的)用一般 socket 收,收到就把同一份內容送到另一個多播群組。兩個時戳都由 port1 打,用的是同一顆時鐘。相減得到的是主機收一個、回一個的時間,還包含回覆經過交換器一次(363 ns)和 Et3 那條 2 m DAC 的來回。回覆程式另外記了 kernel 收到封包到程式拿到的時間,包含拆 header、複製到 socket、喚醒程式這幾步。
這台的低延遲設定:停用 C-state、用 isolcpus 隔離 CPU 1-3、網卡關掉 interrupt coalescing。量測端的兩支程式綁在隔離的 CPU 上,不跟回覆程式搶;回覆程式沒有綁定 CPU,網卡中斷照這台原本的設定落在 CPU 25。量之前先確認交換器沒變:1518 bytes 還是 428 ns。
每一輪 10000 個請求全部收到回覆,擷取沒有遺失:
| 封包 | 中位數 | p99 | p99.9 | 最大值 |
|---|---|---|---|---|
| 64 bytes | 4.58 µs | 5.00 µs | 5.18 µs | 18.77 µs |
| 64 bytes 重跑 | 4.53 µs | 4.96 µs | 5.12 µs | 18.51 µs |
| 1518 bytes | 6.12 µs | 6.75 µs | 7.17 µs | 18.91 µs |
64 bytes 重跑一次,中位數只差約 50 ns。扣掉回覆過交換器那 363 ns,主機本身仍是交換器的 11 倍多。kernel 收到封包到程式拿到,中位數約 1.5 µs,佔三分之一,其餘是網卡收封包、發中斷、送回覆和回覆過交換器的時間。
1518 bytes 比 64 bytes 多約 1.54 µs,其中 1163 ns 是序列化,因為主機要把整個 frame 收完才往上交。剩下的是複製資料的時間,封包越大,網卡寫進記憶體、kernel 交給程式、回覆時再複製一次都越久;光是 kernel 交給程式這一步,1518 bytes 就多了約 0.3 µs。
最大值都是每一輪的第一個封包,通常是因為那時程式跟資料都還不在快取裡。每一輪最慢的 4 個如下,seq 是請求的序號:
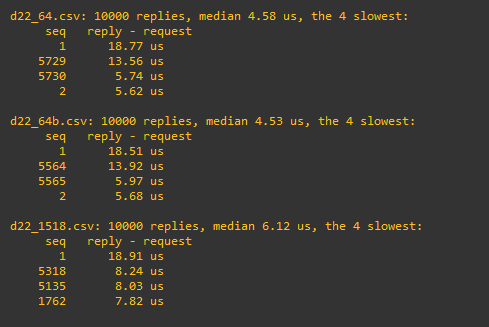
64 bytes 兩輪各有一筆特別慢,原因是作業系統在量測途中把回覆程式從 CPU 19 換到 CPU 25。第一張圖的 -19、-25 是網卡送出 queue 的編號。程式在 CPU 19 時用 queue 19 送回覆,換到 CPU 25 就改用 queue 25,所以兩個 queue 的中斷次數,大約就是程式在兩顆 CPU 上各送了幾個回覆。
| 輪次 | 回覆程式在哪顆 CPU | 特別慢的那一筆 |
|---|---|---|
| 64 bytes | 前約 5730 個回覆在 CPU 19,之後在 CPU 25 | 第 5729 個請求,13.56 µs |
| 64 bytes 重跑 | 前約 5565 個回覆在 CPU 19,之後在 CPU 25 | 第 5564 個請求,13.92 µs |
| 1518 bytes | 一直在 CPU 19 | 沒有 |
程式沒有綁定 CPU,作業系統隨時可能換,換的那一筆就慢了將近三倍。
kernel 收發延遲要定期重量,但數字本身說明不了為什麼變。下面這幾項在重開機、更新 kernel 或驅動、換 tuned profile 之後可能回到預設,延遲跟著變,卻沒有任何告警:
| 項目 | 怎麼看 | 這台現在 |
|---|---|---|
| C-state | cat /proc/cmdline |
idle=poll、processor.max_cstate=0 |
| CPU 隔離 | cat /proc/cmdline |
isolcpus=1-3 |
| tuned | tuned-adm active |
network-latency |
| 網卡 coalescing | ethtool -c |
rx-usecs 0 |
| 中斷指定在哪顆 CPU | /proc/irq/<IRQ 編號>/smp_affinity_list |
25 |
| 回覆程式綁哪顆 CPU | taskset -cp <pid> |
沒有綁定 |
重量時照這三點做:
明天在 X4522 上調 ethtool,看 coalescing、ring buffer、offload 各會改變什麼。


 iThome鐵人賽
 看影片追技術