
Solarflare X4522 的 interrupt coalescing 只在封包很密的時候才會拖慢延遲,而且實際等的時間比設定值長得多。每 1 ms 一個請求時,rx-usecs 從 0 調到 100,延遲沒有變;請求改成每 20 µs 一個、關掉 busy poll,中位數從 4.35 µs 拉長到約 150 µs。同樣每 20 µs 一個、rx-usecs 100,開著 busy poll 時中位數反而是全篇最低的 2.91 µs,coalescing 影響不到它。ring buffer 縮小、GRO 關掉,延遲都沒變。
ExaNIC X25 的 port0 每隔固定時間送一個多播請求,X4522 上的回覆程式收到就回;交換器把請求和回覆都送到 X25 的 port1,由它打兩個硬體時戳相減。每一輪 10000 個請求,另外加了兩項控制:
| 參數 | 指令 | 管什麼 | 這台原本 |
|---|---|---|---|
| interrupt coalescing | ethtool -C |
延後發中斷,讓多個封包共用一次中斷 | rx-usecs 0、adaptive off |
| ring buffer | ethtool -G |
網卡接收佇列能暫存的封包數 | RX 4096 |
| offload | ethtool -K |
把同一條連線的多個封包合併成一個大封包再往上交,GRO 在 kernel 做、LRO 在網卡端做 | GRO on、LRO off |
這台的 tuned 還開了 busy poll(net.core.busy_read 50)。程式在 recvmsg 等封包時,會先自己到網卡的佇列輪詢最多 50 µs,等不到才改等中斷。
表中請求間隔 1 ms 的三輪,busy poll 照這台原本開著。它最多只輪詢 50 µs,下一個請求 1 ms 後才到,程式早就改等中斷,所以這三輪的封包一樣靠中斷收進來,中斷次數 10000 也對得上。間隔 20 µs 的四輪不一樣,下一個封包在輪詢結束前就到了,要先把 busy poll 關掉,讓每個封包都靠中斷收進來,才量得到 coalescing 的影響。
| 請求間隔 | 設定 | 中位數 | p99.9 | 收請求的中斷 | 平均中斷間隔 |
|---|---|---|---|---|---|
| 1 ms | rx-usecs 0 | 4.68 µs | 5.09 µs | 10000 | 1.05 ms |
| 1 ms | rx-usecs 100 | 4.64 µs | 5.10 µs | 10000 | 1.05 ms |
| 1 ms | adaptive(上限 50) | 4.66 µs | 5.12 µs | 10000 | 1.05 ms |
| 20 µs | rx-usecs 0 | 4.35 µs | 12.40 µs | 10000 | 20 µs |
| 20 µs | rx-usecs 50 | 77.02 µs | 141.98 µs | 1455 | 137.5 µs |
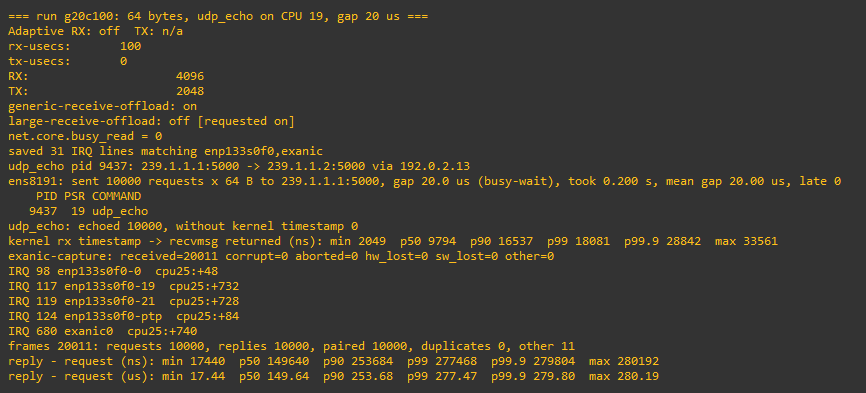
| 20 µs | rx-usecs 100 | 149.64 µs | 279.80 µs | 728 | 274.7 µs |
| 20 µs | adaptive(上限 50) | 76.86 µs | 141.96 µs | 1455 | 137.5 µs |
間隔 1 ms 時,rx-usecs 100 跟 0 的中位數只差 40 ns,中斷一樣是一個封包一次,封包都沒有多等。kernel 對 rx-usecs 的定義是「收到封包後延遲幾 µs 再發中斷」,這張卡在封包稀疏時沒有照這個定義延遲。
間隔 20 µs 時差異才出現:rx-usecs 設得越大,中斷越少、延遲越長,等於用延遲換中斷次數。rx-usecs 50 跟 100 的平均中斷間隔都是設定值的 2.75 倍,p99.9 大約是一個間隔加上沒開時的 4.35 µs:
adaptive 讓驅動依流量自動調整等待時間。間隔 1 ms 時它跟 rx-usecs 0 一樣,間隔 20 µs 時跟 rx-usecs 固定 50 幾乎相同,封包一密就把等待時間開到上限。
把 busy poll 開回 50,同樣間隔 20 µs、rx-usecs 100,跟關著時比較:
| 間隔 20 µs | rx-usecs 0、busy poll 關 | rx-usecs 100、busy poll 關 | rx-usecs 100、busy poll 開 |
|---|---|---|---|
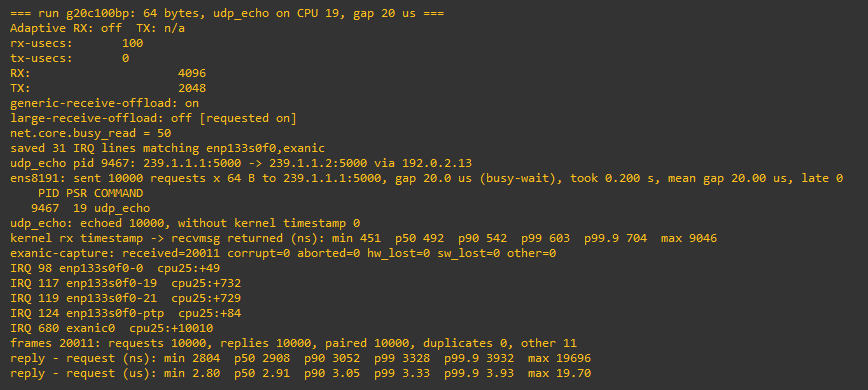
| 中位數 | 4.35 µs | 149.64 µs | 2.91 µs |
| p99.9 | 12.40 µs | 279.80 µs | 3.93 µs |
| 收請求的中斷 | 10000 | 728 | 729 |
| kernel 收到封包到程式拿到(中位數) | 1385 ns | 9794 ns | 492 ns |
busy poll 開著時,程式一直在網卡的佇列上輪詢,封包一到就被拿走,不用等中斷,rx-usecs 100 也影響不到它。中斷照樣每 275 µs 左右來一次,只是那時封包已經被拿走了:
kernel 的文件建議全域打開時設 50,也寫了會增加耗電,因為程式等封包時一直在輪詢。
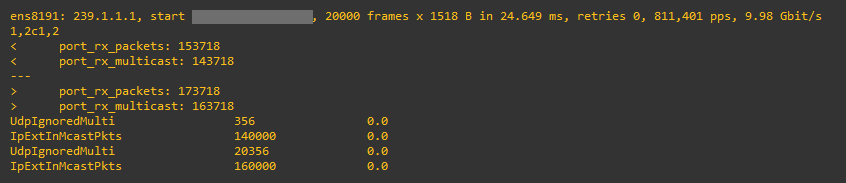
ring buffer 管的是 kernel 來不及收時,網卡能先暫存多少封包。除了每 1 ms 一個請求,也讓 X25 用線速送 20000 個 1518 bytes(每秒約 81 萬個),X4522 只加入群組、不開程式收:
| ring RX | 每 1 ms 一個請求的中位數 | 爆量時網卡收到 | 網卡丟掉 | kernel 收到 |
|---|---|---|---|---|
| 512 | 4.58 µs | 20000 | 0 | 20000 |
| 4096 | 4.61 µs | 20000 | 0 | 20000 |
512 也沒掉封包,這個速率下 kernel 收得過來,ring 用不滿:
GRO 關掉,中位數一樣是 4.58 µs,通常是因為每 1 ms 才來一個 UDP 請求,沒有可以合併的封包。關的時候 ethtool 印出了沒要求的變更:
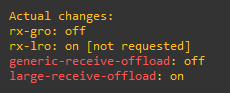
LRO 從 off 變成 on。把 GRO 開回來,LRO 還是開著。這輪的中位數沒受影響,但這種沒要求的連動變更,只確認自己改的那一項就會漏掉;復原時要另外用 ethtool -K <介面> lro off 關回去。
ethtool -c、-g、-k,跟改之前整份比對,沒改的項目也要看。port_rx_nodesc_drops(ring 沒有空格、網卡只好丟掉的封包)增量大於 0,交易時段 P1 通報。明天看網卡中斷和回覆程式各放在哪顆 CPU,延遲差多少。


 iThome鐵人賽
 看影片追技術