
昨天是 requests 開太大排不進去,今天做 limits 設太小被砍掉
這次不動主要的 Deployment,另外開一個專門用來自殺的 Pod,比較好觀察
manifests/broken/memory-hog.yaml
apiVersion: v1
kind: Pod
metadata:
  name: memory-hog
  namespace: ithome-lab
spec:
  containers:
    - name: memory-hog
      image: python:3.12-alpine
      command:
        - python
        - -c
        - |
          import time
          data = "x" * 100 * 1024 * 1024
          print("allocated")
          time.sleep(3600)
      resources:
        limits:
          memory: "32Mi"
這段 Python 會配置大約 100MB 的字串,但我給的上限只有 32Mi。故意讓它超標
kubectl apply -f manifests/broken/memory-hog.yaml
kubectl get pods -n ithome-lab -w
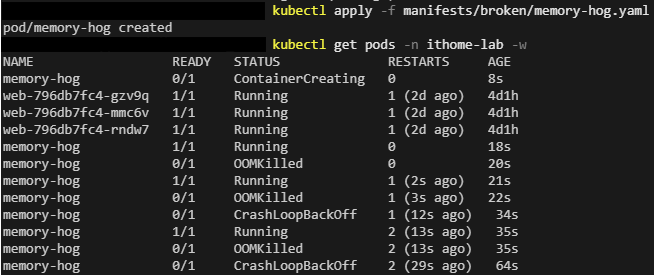
log
kubectl logs memory-hog -n ithome-lab --previous

什麼都沒有,我寫的 print 也沒印出來
這就是記憶體超標跟一般崩潰的不同,記憶體超標是 kernel 在配置記憶體的當下直接把行程幹掉,程式沒有機會執行任何後續動作
describe
kubectl describe pod memory-hog -n ithome-lab
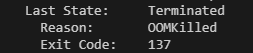
OOMKilled,Out Of Memory Killed。Exit Code 137 剛好是前幾天遇過的那個,128 + SIGKILL(9),也就是被砍掉
K8s 透過 cgroup 設定了這個 Container 的記憶體上限,超過瞬間 kernel 執行kill,K8s 事後發現並且記錄下來
跟昨天對照,requests 太大是直接進不去,狀態 Pending,卡在排程;limits 太小是進去了才被砍,狀態 OOMKilled 然後 CrashLoopBackOff,卡在執行。同樣是記憶體的問題,兩個欄位、兩種不同的症狀
修法:把 limit 調大,或是讓程式少吃一點。這裡我把上限改成 256Mi
kubectl delete -f manifests/broken/memory-hog.yaml
kubectl apply -f manifests/broken/memory-hog.yaml
kubectl get pods -n ithome-lab
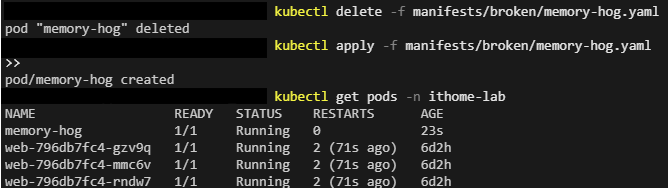
但實務上調大 limit 之前要先想清楚,這個程式是本來就需要這麼多,還是它有記憶體洩漏。如果是後者,調大只是讓它晚一點掛,而且掛的時候會拖累更多東西
實驗做完把它清掉
kubectl delete -f manifests/broken/memory-hog.yaml
明天見 :D


 iThome鐵人賽
 看影片追技術