
在 Day 20 設定的告警規則中,當指標 soak 到 180 秒、叢集法定人數少一票、或儲存池使用率突破 80% 時,維運團隊就會收到通知。然而告警響起後,值班工程師必須立即回答的問題往往是:「在那關鍵的十分鐘內,系統到底發生了什麼事?」
這個問題的線索散落在四個不同的角落:
pve-ha-lrm 的狀態機轉移。四個來源、兩種日誌格式、六台主機,卻沒有沒有單一介面能一目了然,加速掌握全局。
因此,今天的目標是:
在架構設計之初,必須先釐清現有的資源限制:
| 方案 | 收集端資源需求 | 節點端相依套件 | 原生接收 journald | 保存與封存機制 | 查詢語言與生態 |
|---|---|---|---|---|---|
| 純 QuLog Center | 位於 NAS,收集端零負擔 | rsyslog 轉送 | 否,需先壓扁成單行 syslog | 依 NAS 內部資料庫,冷備份需靠手動匯出 CSV | 簡易關鍵字過濾 |
| SpesLog | 單一容器(亦支援 K8s、VM 或實體機 SDS 部署) | 支援原生 Syslog、Windows Event、Linux Auditd 或專屬 Agent / API | 否,需透過 Syslog 轉送、Auditd 或 Agent 收集 | 熱資料高速索引,冷資料高壓縮寫入 WORM 儲存池與 S3 物件儲存 | 關鍵字、布林邏輯與多維度過濾 |
| Graylog Open | 需 Graylog + MongoDB + OpenSearch 三套服務,JVM heap 需求高 | Graylog Sidecar 或 rsyslog | 否 | 索引依 Index Set 保留,合規封存多屬 Enterprise 功能 | 完整 Pipeline 規則與 RBAC |
| Grafana Loki | 單一容器,但需規劃 Object Storage / Compactor | Alloy 或 Promtail | 否,需代理讀取 journal | 依 Stream 保留,封存需額外腳本串接 | LogQL,與 PromQL 語法相近 |
| VictoriaLogs | 單一二進位/容器,實測千萬筆常駐 160 MiB,磁碟佔用僅 236 MB | 零額外安裝,直接使用 systemd 原生 systemd-journal-upload |
是,/insert/journald 原生解析 Export 格式 |
支援 -retentionPeriod 與磁碟上限,匯出格式簡單 |
LogsQL,具 Grafana 專用 Datasource |
systemd-journal-upload(Debian/Ubuntu 位於 systemd-journal-remote 套件中),能以 native export 格式直接透過 HTTP POST 上傳。VictoriaLogs 原生支援該協定,_SYSTEMD_UNIT、PRIORITY、_TRANSPORT 等結構化欄位全數保留,完全不需在節點裝 Logstash、Fluentbit 或 Promtail。日誌架構主要由收集端的 Docker Compose 驅動,對外開放兩個接收埠:
9428:接收四台 Linux 節點透過 HTTP POST 送來的 journald export 流。514 (TCP/UDP):接收兩台 NAS 送出的 syslog。+-------------------------------------------------------+
| [Nodes] DGX Spark & PVE Hosts |
| systemd-journald ---> systemd-journal-upload (HTTP) |
+------------------------------------+------------------+
| Port 9428
+------------------------------------+ |
| [Storage] Primary & Secondary NAS | |
| QuLog Center (Syslog Sender) | |
+------------------+-----------------+ |
| Port 514 (TCP) |
v v
+-------------------------------------------------------+
| [Collector VM] |
| VictoriaLogs (Port 9428 / 514) |
| ├── Prometheus (up monitoring) |
| ├── Grafana (Datasource Plugin) |
| └── Daily Archiver Script ---> NFS (/mnt/worm) |
+-------------------------------------------------------+
systemd-journal-upload 實戰在 Linux 節點上啟用 journal 上傳相當簡單,但在實際佈署時有幾點需特別注意:
/var/log/journal/,systemd 的預設值 Storage=auto 即會啟用持久化。建議透過 drop-in 設定檔明確宣告 Storage=persistent。注意:切勿貿然在線上環境寫入過小的 SystemMaxUse,否則套用瞬間會直接清掉節點上的歷史日誌。systemd-journal-upload.service 採用 DynamicUser=yes 與 StateDirectory= 機制。上傳的游標(cursor)預設會落在 /var/lib/private/systemd/journal-upload/state,由 systemd 自身處理權限,不需手動為其建立系統帳號。vl_rows_dropped_total{reason="too_small_timestamp"}。若不想傳送歷史資料,可在啟動前將游標指標指向 journal 結尾。在 NAS 的 QuLog Center 設定「記錄傳送端」時,有兩大容易踩坑的細節:
-syslog.timezone=Asia/Taipei。在 Linux 系統中,若直接使用 UFW 限制連接埠,常會忽略 Docker 發佈的埠(Port Publishing)在 PREROUTING 階段做完 DNAT 後會直接走 FORWARD 鏈進容器,完全繞過 UFW 的 INPUT 規則。
為了確保日誌收集端不對外裸露,正確做法是利用 Docker 保留的 DOCKER-USER iptables 鏈:
0.0.0.0:9428),避免 docker-proxy 在 IPv6 位址產生非預期的監聽開口。當六個來源全部接通後,系統就逐步進入穩定狀態,接下來是近期觀察到的幾項關鍵維運細節:
原先預期日誌串流維度 (_HOSTNAME, _SYSTEMD_UNIT) 會維持在數百個以內。但實測發現串流數達到了 50,000 個以上。深入排查發現:每次 SSH 登入都會動態產生一個 session-N.scope,自動化維運工具頻繁連線造成串流暴增。
所幸 VictoriaLogs 的架構對於高基數(High Cardinality)場景擁有良好的耐受度,1,130 萬筆日誌壓縮後僅 186 MB,索引僅 5 MB,系統未受效能衝擊。
分析收集到的日誌,通常我們去仔細檢視,你可以發現佔用量最大的往往不是重要錯誤,而是週期性雜訊:
user@0.service,單日產生近 10 萬行日誌。loginctl enable-linger root,大幅收斂 PAM 與 Session 建立紀錄。LogLevelMax=notice,平日抑制常態紀錄,僅在 exit code 非零時保留異常紀錄。經過兩項最佳化,單台節點的日誌量從每天 22 萬筆降至 5 萬筆左右,整體日誌總量減少了約 75%。
日誌保存策略分為三層,兼顧「即時排查」、「中繼關聯」與「長期法規稽核」:
| 層級 | 存放位置 | 保存週期 | 核心目的 |
|---|---|---|---|
| 來源層 (Source) | 節點本機 journal、NAS 內部空間 | 依本機磁碟容量滾動覆蓋 | 本機緊急救援與本機離線排查 |
| 熱資料層 (Hot) | 收集端 VictoriaLogs | 90 天(配置 12 GiB 空間上限) | 即時告警關聯、Grafana LogsQL 交互查詢 |
| 封存層 (Cold) | NAS WORM 共用資料夾 | 180 天(依企業法規程序調整) | 符合資安稽核要求,防竄改與不可變更 |
在完成日誌降噪後,六台機器單日穩態日誌量約為 8.3 萬筆,磁碟每日增量僅約 2.75 MB。
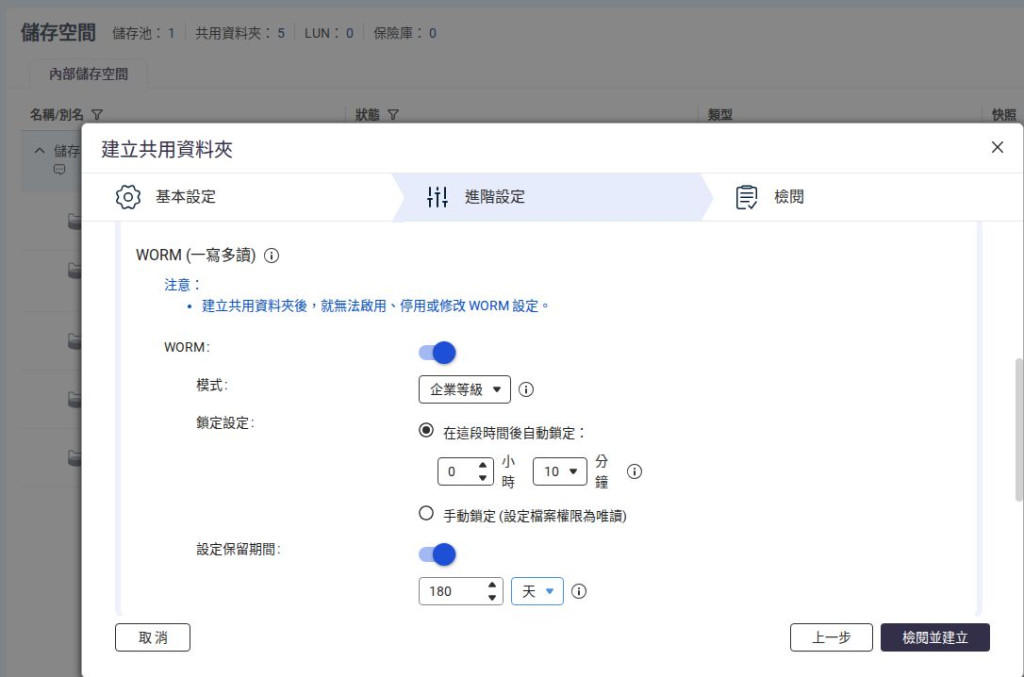
在 NAS 的 QuTS hero 系統建立 WORM 資料夾,設定為「企業模式」並啟用「10 分鐘自動鎖定」,保存期限設定為 180 天。
在自動化封存設計上,必須特別注意 WORM 的鎖定特性:
地雷設計:若封存腳本直接在掛載的 WORM 資料夾內建立
.tmp檔案進行逐行寫入,一旦匯出時間或網路延遲超過 10 分鐘,暫存檔將被 WORM 引擎無情鎖定。後續的重試或更名操作都會被系統阻擋,且該檔案必須在儲存池躺滿 180 天才能刪除。
健全的封存流程:
.jsonl.gz。lines)是否嚴格等於 VictoriaLogs 回報的查詢命中筆數(hits)。MANIFEST.tsv 與 SHA256SUMS,最後才以 cp 一次性複製至 /mnt/worm/。SHA256SUMS 是否存在作為當日封存完成的判定基準。若傳輸中斷,絕不在 WORM 留下半成品。# MANIFEST.tsv 範例
# source lines hits bytes sha256
journald-pve1 56291 56291 3418003 9ea92d71...
journald-spark02 10101 10101 682511 b067cc33...
syslog-nas-primary 1618 1618 112540 1a20025a...
在封存檔案鎖定延遲(10 分鐘)過後,進行七種蓄意破壞測試:
rm 刪除sudo rm -rf 強制刪除mv 移動更名tee -a 嘗試附加內容: > SHA256SUMS 截斷檔案touch 嘗試更新時間戳chmod 變更檔案權限測試結果:全部操作均由底層檔案系統直接回傳 Operation not permitted。由於 NFS 掛載設定了 All Squash,即使是收集端的 root 帳號亦無法跨越 WORM 的核心保護,證明日誌在寫入後具備高度的法律與稽核效力。
有了統一日誌平台後,Day 20 的 Prometheus 告警便能直接在 Grafana Explore 進行關聯查詢。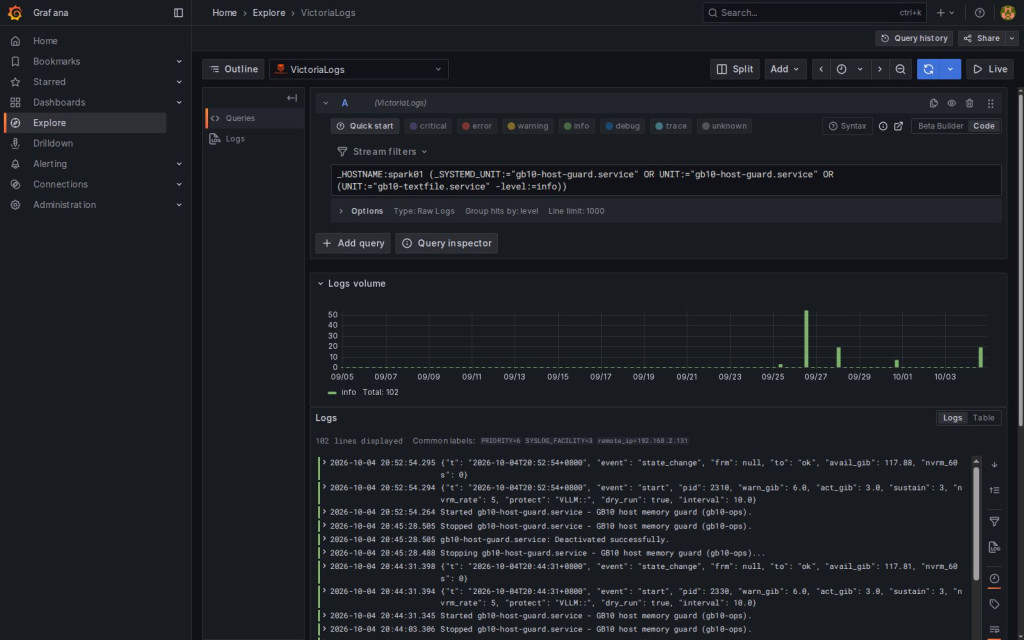
_transport:journal AND (trigger OR would_kill OR sigterm OR sigkill)
_TRANSPORT:=kernel AND (NV_ERR_NO_MEMORY OR NVRM OR Xid)
app_name:qulog AND "conn log:" AND (deny OR failed)
為了確保系統完全處於可重現與安全受控狀態(Air-gapped 概念),不建議在 Grafana 容器啟動時使用 GF_INSTALL_PLUGINS 動態連網下載外掛。
建議透過自建 Dockerfile,將預先驗證過 SHA256 雜湊值的 victorialogs-datasource 解壓縮置入 /opt/grafana-plugins,並配置 GF_PLUGINS_PREINSTALL_DISABLED=true 關閉未受監管的自動更新,維持環境版本絕對鎖定。
# 取得設定檔與專案
git clone https://github.com/ivanusto/onprem-logs && cd onprem-logs

# 啟動日誌核心
docker compose up -d

# 設定白名單防火牆規則(僅允許授權節點與 NAS 進入)
sudo install -m 0644 collector/onprem-logs-allowlist.default /etc/default/onprem-logs-allowlist
sudo install -m 0644 collector/onprem-logs-allowlist.service /etc/systemd/system/
sudo systemctl daemon-reload && sudo systemctl enable --now onprem-logs-allowlist

# 掛載 NAS WORM 共用目錄
sudo install -m 0644 collector/mnt-worm.mount /etc/systemd/system/
sudo systemctl daemon-reload && sudo systemctl enable --now mnt-worm.mount

# 設定排程封存與驗證工作
sudo install -d -o metrics /var/log/onprem-logs /srv/drills/onprem-logs /var/tmp/onprem-logs-stage
sudo install -m 0644 collector.cron /etc/cron.d/onprem-logs
在每台 DGX Spark 與 Proxmox VE 節點上執行上傳設定腳本,指向收集端位址:
# 指向收集端 IP
sudo ./node/install-journal-upload.sh http://<collector-ip>:9428
回到收集端,直接透過 HTTP API 檢視最近 5 分鐘各主機回報的日誌統計:
curl -s http://127.0.0.1:9428/select/logsql/query \
  -d 'query=_time:5m | stats by (_HOSTNAME, hostname) count()'
透過本篇的架構建置,我們在零外掛代理的前提下,達成了以下效益:
lines == hits 行數檢核與 SHA256 簽署,確保所有事件皆可對帳且無篡改之虞。在解決了「系統與服務發生了什麼事」之後,下一個維運關鍵是網路邊界防禦。Day 22 將進入防火牆日誌分析:我們將利用 LogsQL 剖析節點上的連線拒絕紀錄與 NAS 存取行為,並將具備攻擊特徵的行為轉化為即時告警規則。
系列文章與程式碼索引:onprem-ops-30days
本日程式碼:onprem-logs、onprem-metrics v0.2.1
參考資料
systemd-journal-upload 的設定與 -journald.* 旗標-syslog.* 旗標GF_PLUGINS_PREINSTALL 與停用預裝


 iThome鐵人賽
 看影片追技術