
網卡收到請求,要先由一顆 CPU 處理中斷,再叫醒回覆程式。這台 26 個核心在作業系統裡編號 CPU 0 到 CPU 25。比較中斷跟程式放在哪顆 CPU,量出三個結果:
NUMA 對齊只有主機有多個 NUMA node 時才需要,最常見的是雙 socket 的主機,兩顆實體 CPU 各管自己的 PCIe 槽跟記憶體,各算一個 node。網卡插在哪個 node 的槽,中斷跟程式就要放在那個 node 的 CPU 上,處理封包才不用跨 node 讀寫記憶體。所以先看這台有幾個 node:
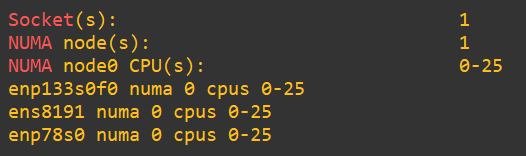
這台只有 1 個 socket、1 個 NUMA node。網卡屬於哪個 node、那個 node 有哪些 CPU,看 /sys/class/net/<介面>/device/ 底下 numa_node 跟 local_cpulist,三張網卡都是 0 跟 0-25,所以不需要 NUMA 對齊。
ExaNIC X25 的 port0 每 1 ms 送一個多播請求,X4522 上的回覆程式收到就回;交換器把請求和回覆都送到 X25 的 port1,由它打兩個硬體時戳相減,每輪 10000 個請求。
下面三個是 Linux 內建的設定,每台都查得到,值看驅動跟各自的配置:
| 設定 | 位置 | 管什麼 | 這台 |
|---|---|---|---|
| smp_affinity_list | /proc/irq/<中斷編號>/,編號在 /proc/interrupts 找 |
這條中斷由哪幾顆 CPU 處理 | 網卡中斷都是 25 |
| affinity_hint | /proc/irq/<中斷編號>/ |
驅動建議放哪顆 CPU,沒給就是 0 | queue 21 建議 CPU 21 |
| xps_cpus | /sys/class/net/<介面>/queues/tx-<N>/ |
哪幾顆 CPU 送封包時用這個 queue;沒設的話,送出 queue 不跟著 CPU 走 | CPU N 用 queue N |
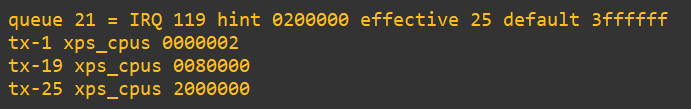
這次請求都由 X4522 的 queue 21 收進來,它的中斷在開機時被設到 CPU 25,沒照驅動建議。截圖裡 effective 後面的 25 直接是 CPU 編號;hint 跟 xps_cpus 的值是十六進位的 CPU 位元表(kernel 叫 cpumask),換成二進位後每一位代表一顆 CPU,最右邊是 CPU 0,哪一位是 1 就代表哪顆 CPU。例如 hint 的 0200000 換成二進位是 1 後面接 21 個 0,代表 CPU 21:
下表各輪只改兩個設定:queue 21 中斷的 smp_affinity_list,以及回覆程式用 taskset 綁哪顆 CPU:
| 收請求的中斷 | 回覆程式 | 中位數 | p99.9 | 開頭兩個以外最慢 |
|---|---|---|---|---|
| CPU 25 | CPU 19 | 4.64 µs | 5.18 µs | 468.90 µs |
| CPU 25 | CPU 25 | 3.89 µs | 4.40 µs | 5.05 µs |
| CPU 19 | CPU 19 | 4.04 µs | 4.50 µs | 888.81 µs |
| CPU 1(隔離) | CPU 1 | 4.18 µs | 4.60 µs | 4.82 µs |
中斷跟程式在同一顆 CPU 的三種擺法,中位數都比分開放的 4.64 µs 低。省下的時間主要在 kernel 收到封包到程式拿到這段,從 1.54 µs 降到約 1 µs,通常是因為不用跨 CPU 叫醒程式。
程式在 CPU 19 時,三輪都有一個請求卡住幾百 µs:表中兩輪是 468.90 跟 888.81 µs,第一列重量一次是 406.27 µs。時間都花在 kernel 收到封包之後、程式拿到之前,也就是封包到了,CPU 19 卻沒有馬上讓程式執行,通常是因為上面還有別的工作。CPU 25 也是一般的 CPU,這兩輪沒卡住不代表不會;隔離的 CPU 從設定上就不排一般程式,少了這類干擾。
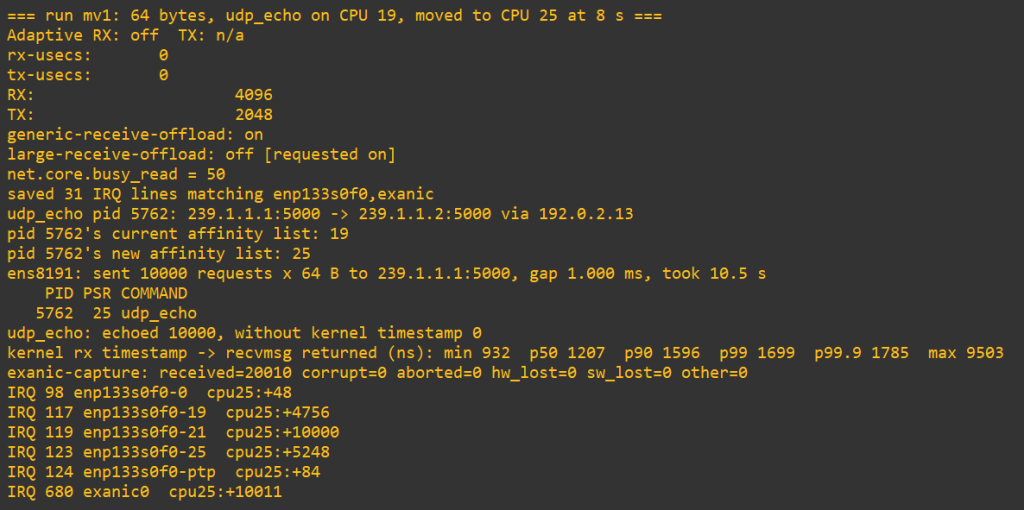
回覆程式沒綁 CPU 時,排程器可能中途把它換到另一顆 CPU。要確認換的那一筆會不會變慢,量到一半時用 taskset -cp 把回覆程式強制換到另一顆 CPU,另外不綁 CPU 跑兩輪,由排程器自己決定。
第幾個請求時換的,從送回覆的 queue 算得出來:每送一個回覆,程式所在 CPU 對應的 queue 就多一次中斷。兩個 queue 的中斷次數各扣掉 2 次(加入、離開多播群組的封包),就是換之前、換之後各送了幾個回覆:
| 程式怎麼換 CPU | 第幾個請求換 | 最慢的那一筆 |
|---|---|---|
| 強制從 19 換到 25 | 第 4755 個 | 第 4755 個,15.46 µs |
| 強制從 25 換到 19 | 第 4755 個 | 第 4755 個,14.60 µs |
| 不綁,排程器自己從 0 換到 25 | 約第 3355 個 | 第 3355 個,16.18 µs |
| 不綁,全程在 22 | 沒換 | 沒有特別慢的 |
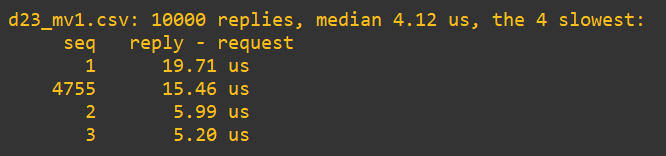
三次換 CPU,最慢的都剛好是換完後第一個請求,是中位數的 3 到 4 倍。不綁 CPU 時程式落在哪顆也不一定,落在 CPU 22 那輪的中位數是 4.81 µs,比綁在 CPU 19 的 4.64 µs 還慢。
| 項目 | 做法 | 時機 | 不符合時 |
|---|---|---|---|
| NUMA 拓撲 | lscpu 跟 /sys/class/net/<介面>/device/numa_node,看有幾個 node、網卡在哪個 node(-1 代表平台沒提供) |
上線前、換主機或網卡 | 網卡、它的中斷跟程式放回同一個 node |
| 綁核 | 程式用 taskset 綁住,收它那條 queue 的中斷放同一顆 CPU;要延遲穩定就用隔離的 CPU。irqbalance 開著會重新分配中斷,要先停用或排除 |
上線前 | 重新綁 |
| 綁定基線 | 每條中斷的 smp_affinity_list 跟程式的 taskset -cp 存成基線 |
開機、改設定後比對 | 列為 P2 |
| 程式換 CPU | 監看送出 queue 的中斷次數,程式該用的 queue 以外有沒有別的在增加(要有設 xps_cpus) | 持續 | 列為 P2 |
明天看 CPU 被其他程式佔滿、C-state 打開時,延遲會變多少。


 iThome鐵人賽
 看影片追技術