
昨天終於把 Webhook 接到 AI Agent。
現在整個架構已經變成:
外部系統 → Webhook → AI Agent → Memory / Tools → Response
也就是說,未來不管是自己的網頁、APP,甚至其他程式,只要能夠發送 HTTP Request,就有機會把訊息傳給 Agent。
但做到這裡,我突然想到一個問題:
如果別人也拿到了我的 Webhook URL 呢?
如果完全沒有任何限制,只要知道網址的人都有可能對 Workflow 發送 Request。
而我的 Agent 後面甚至還有 Google Sheets 等可以執行動作的 Tool。
所以今天不繼續增加 Agent 功能,而是來處理一件更重要的事情:
安全性。
昨天是:
外部使用者
    ↓
  Webhook
    ↓
 AI Agent
    ↓
   Tools
今天希望多一層驗證:
外部使用者
    ↓
帶著驗證資訊
    ↓
  Webhook
    ↓
驗證通過?
  ↙    ↘
否      是
↓       ↓
拒絕   AI Agent
簡單來說:
不是收到 Request 就直接交給 Agent。
而是先確認這個 Request 是否符合我們設定的存取條件。
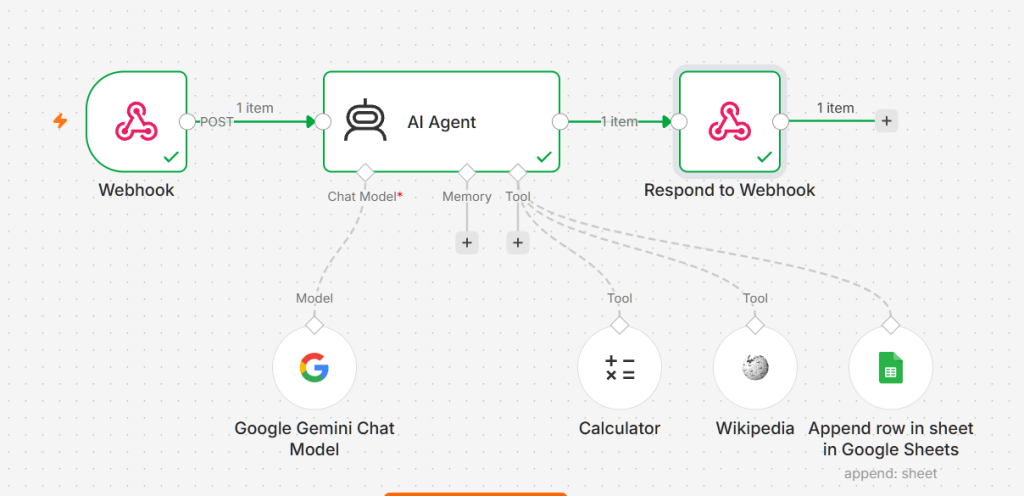
圖 1 替 AI Agent Webhook 加入驗證概念
假設昨天建立了一個 Webhook:
https://example.com/webhook/ai-agent
外部只要送:
{
  "message": "幫我記錄一筆資料"
}
Workflow 就開始執行。
如果完全沒有保護,可能遇到:
不認識的人一直呼叫 Webhook
AI API 額度被消耗
Google Sheets 被寫入垃圾資料
Workflow 被大量觸發
所以:
Webhook URL 本身不應被當成完整的安全機制。
今天就來加入一個簡單的驗證概念。
Day 21 學 API Authentication 時有提到 Header。
HTTP Request 不只有 Body:
{
  "message": "Hello"
}
還可以帶著 Header。
例如概念上:
X-API-Key: YOUR_SECRET_KEY
這樣 Request 就包含:
Header
X-API-Key: YOUR_SECRET_KEY

Body
{
  "message": "Hello"
}
伺服器收到之後,就可以先檢查 Header 裡的驗證資訊。
今天剛好把 Day 21 學到的東西真正用回來。
今天文章裡所有驗證資訊都只使用假的範例。
例如:
YOUR_SECRET_KEY
尤其截圖時,要注意:
API Key
Token
Authorization Header
Credentials
Webhook 中不適合公開的資訊
實際設定時,可以優先使用目前 n8n Webhook 所提供的驗證方式;不同版本的設定選項可能會有所差異。
今天先理解概念:
Request
↓
Webhook
↓
檢查驗證資訊
↓
正確
↓
繼續執行
如果驗證失敗:
Request
↓
Webhook
↓
驗證失敗
↓
拒絕 Request
這比:
Webhook
↓
直接執行 AI Agent
多了一道保護。
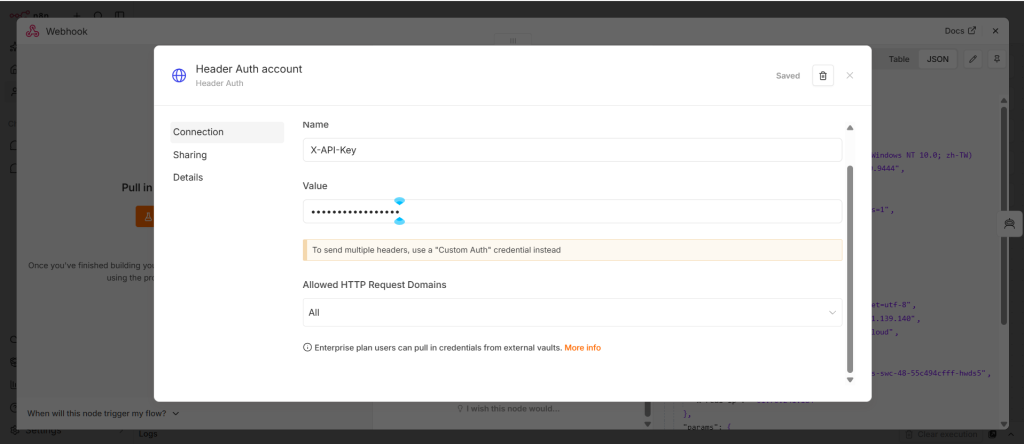
圖 2 Webhook 的驗證設定
設定完成後,我覺得最好不要馬上只測成功的情況。
先故意傳錯。
例如正確的驗證資訊假設是:
X-API-Key: YOUR_SECRET_KEY
測試時故意使用:
X-API-Key: WRONG_KEY
預期結果應該是:
外部 Request
↓
Webhook
↓
驗證失敗
↓
不執行 AI Agent
這個測試非常重要。
因為真正想確認的不是:
「正確的人進得去。」
還要確認:
「錯誤的人進不去。」
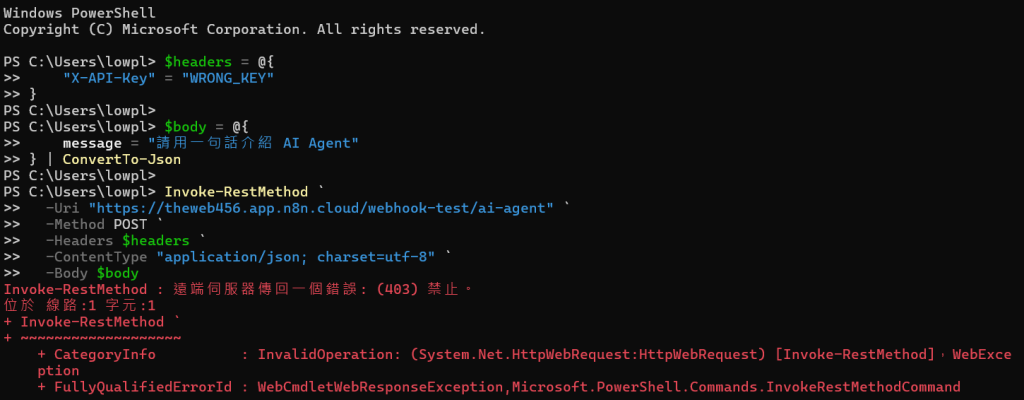
圖 3 使用錯誤驗證資訊時 Request 被拒絕
接著改成正確的驗證方式。
Body 還是一樣:
{
  "message": "請用一句話介紹 AI Agent"
}
但這次 Request 帶著正確的驗證資訊。
如果成功:
Request
↓
Authentication ✓
↓
Webhook
↓
AI Agent
↓
Response
Agent 才真正開始工作。
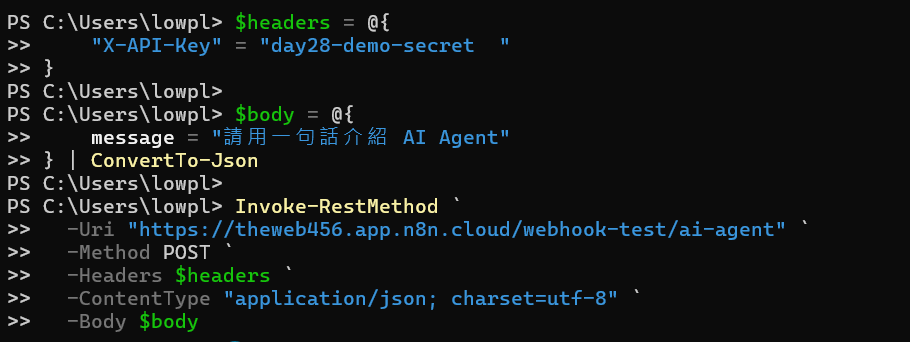
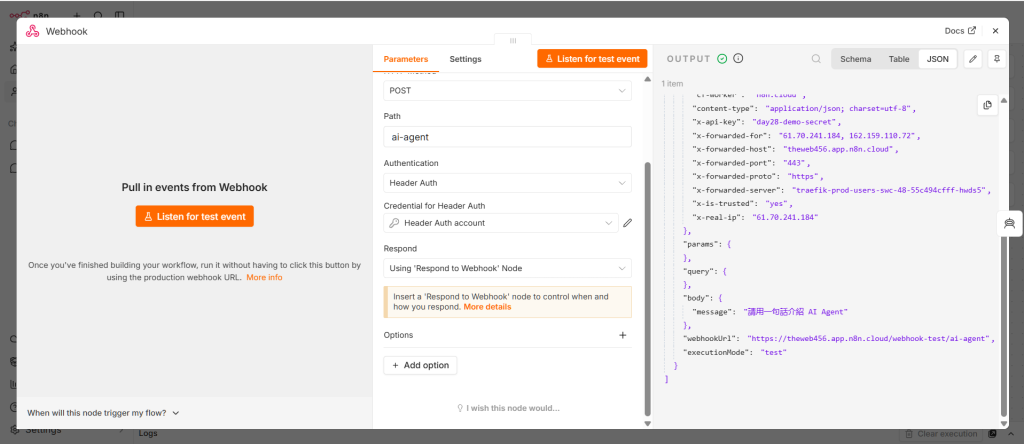
圖 4 通過驗證後成功執行 AI Agent
這樣今天就能做出非常清楚的對照:
| 測試結果 | |
|---|---|
| 沒有驗證資訊 | 拒絕 |
| 錯誤驗證資訊 | 拒絕 |
| 正確驗證資訊 | 執行 Agent |
假設把所有 Request 都先交給 AI:
Request
↓
AI Agent
↓
AI 判斷這個人能不能使用
這其實不太理想。
因為 Agent 都已經開始執行了,AI API 可能也已經產生成本。
更重要的是:
安全驗證不應該只靠 AI 自己判斷。
比較合理的概念是:
Request
↓
程式/系統驗證
↓
驗證成功
↓
AI Agent
也就是:
先驗證,再讓 AI 工作。
固定的安全規則應該交給明確的系統機制處理,而不是問 AI:
「你覺得這個使用者可以進來嗎?」
即使今天加入 Authentication,我還是會避免在文章中公開正式使用中的完整 Webhook URL。
截圖可以把部分內容遮掉,例如:
https://******.n8n.cloud/webhook/******
因為公開 Endpoint 之後,即使攻擊者沒有正確 Credential,也可能對它發送大量請求。
所以文章真正需要展示的是:
Workflow 怎麼設計
驗證概念怎麼運作
成功與失敗的測試結果
而不是把真正可以使用的網址、Key 全部公開。
Day 21 第一次接觸 API Key 時,很容易把它想成:
「API 的密碼。」
但今天再做一次之後,我覺得比較好的理解是:
API Key 是常見的 API 存取憑證之一。
不同服務可能使用:
API Key
Bearer Token
Basic Authentication
OAuth
而且每一種方式的安全性、用途與權限管理方式也不完全一樣。
所以實際串接服務時,還是應該按照該服務的官方文件設定。
假設今天不小心把真正的 API Key 截圖放到文章:
X-API-Key: abc123456789
這時候不能只把文章圖片刪掉,就覺得沒事了。
因為 Key 可能已經被其他人看到或保存。
比較安全的做法是:
立即停用、撤銷或重新產生該 Credential。
然後更新 n8n 裡使用的 Credential。
所以最好的方法還是:
從一開始就不要讓秘密資訊出現在公開內容裡。
昨天的 Agent 已經可以使用 Google Sheets。
未來甚至可能加入:
Database
Google Drive
HTTP Request
這時候安全問題就不只是:
「誰可以呼叫 Agent?」
還有:
「Agent 可以做什麼?」
例如 Agent 只需要:
新增 Google Sheets 資料
那就沒有必要額外給它:
刪除整份資料的能力。
可以簡單理解成:
只給完成任務真正需要的權限。
這就是很重要的「最小權限」概念。
做到這裡也不能覺得:
「有 API Key,所以系統現在百分之百安全。」
真正公開的系統還會遇到很多問題,例如:
大量 Request
惡意輸入
Credential 外洩
權限設定錯誤
AI Tool 被不當呼叫
所以今天只是第一次建立:
不要讓 Webhook 完全裸露。
這個安全觀念。
如果未來真的把系統公開給其他人使用,還需要更完整的安全設計。
今天可以整理成:
External Request
       ↓
Authentication
       ↓
     Webhook
       ↓
    AI Agent
   ↙    ↓     ↘
Memory Model  Tools
               ↓
         Google Sheets
       ↓
    Response
這比 Day 27:
Webhook → AI Agent
多了一個很重要的概念:
不是每個 Request 都應該直接進入 Agent。
前幾天一直在想:
怎麼讓 Agent 功能更多?
加入 Calculator、Wikipedia、Google Sheets、Memory、Webhook……
但做到今天,我開始覺得另一件事情也很重要:
功能越多,能造成的影響也越大。
如果 Agent 只能回答問題,出錯可能只是一個錯誤答案。
但如果 Agent 可以:
寫入資料
寄 Email
修改系統
就不能只考慮「能不能做到」。
還要考慮:
誰可以叫它做?它被允許做到什麼程度?
這也是今天我第一次真正感受到 AI Agent 的安全問題。
今天沒有替 Agent 加入新的功能,而是在 Webhook 前面加入了驗證與安全的概念。
從:
知道網址
↓
就可以呼叫 Agent
慢慢改成:
送出 Request
↓
提供驗證資訊
↓
驗證成功
↓
Agent 才開始工作
也重新把 Day 21 學到的:
API Key、Token、Authentication、Credentials
跟現在的 AI Agent 串在一起。
做到 Day 28,目前已經有:
Webhook → Authentication → AI Agent → Chat Model + Memory + Tools → Response
距離 30 天只剩最後兩天。
接下來不繼續一直增加新 Node,而是把這幾天做過的東西整理成一個真正完整的小專案。


 iThome鐵人賽
 看影片追技術