

本篇目的:讀者可以了解 dataclass、Pydantic 等儲存資料專屬的模組用法,並在資料留個階段選用適當的模組
我們在前面的文章中將資料流、UI 元件管理、設定檔管理都模組化了,也體驗到模組化有 api、編輯器自動提示等方便功能,但我們對於 SPEC 等資料卻只是使用 list、dict、tuple 等基本型別來儲存。這些型別雖然易用,但無法做到資料邊界驗證 (例如最小值當然要比最大值小),取值時打錯 key 或 index 名稱導致錯誤取值。
這些錯誤可能不會在執行期間爆發,例如最大最小值若相反仍可”正常”運作、只是篩選完成後沒有任何資料,我們可能會在多輪使用後才發現哪裡怪怪的,而這種沒有提示的錯誤很難除錯。
好消息是這次我們不用自己手搓資料儲存與驗證流程了,Python 內有相關模組可以處理這些資料問題。在今明 2 天的文章中,我們會從簡單的資料類別物件開始學習,到活用功能強大的驗證模組在輸入期間就確認資料正確性,兩天的內容預計如下:
Day 23:了解資料模組 dataclass、Pydantic 的差異與基本使用法 (寫入資料、轉成 dict)
Day 24:了解 Pydantic 的進階驗證方式, 例如大小值驗證、條件驗證
假設我們有 3 個 SPEC 設定如下,其中 2 個 SPEC 有出現字串以及大小值相反的異常
a_spec = {'Vf2_min': 3, 'Vf2_max': 3.3}
str_error_spec = {'Vf2_min': ' 3', 'Vf2_max': 3.3} # 輸入 3 時在前面多一個空格
opposite_error_spec = {'Vf2_min': 3.3, 'Vf2_max': 3} # 大小值相反
並且設定一 dataframe 如下
data = [
    {'SN':1, 'Vf2':3.7, 'Po': 1200.0},
    {'SN':2, 'Vf2':3.2, 'Po': 1250.0},
    {'SN':3, 'Vf2':0.7, 'Po': 0.8},
] # 測試資料

df_test = pd.DataFrame(data)
當我們對 dataframe 做篩選時,多一個空格的字串會跳出 error 並停止;但若最大最小值相反、或是打錯 key 的篩選會”正常運作”,只是沒有對應的篩選結果。這個預期之外的結果會一路沿著 data pipline 流進我們的報告中。
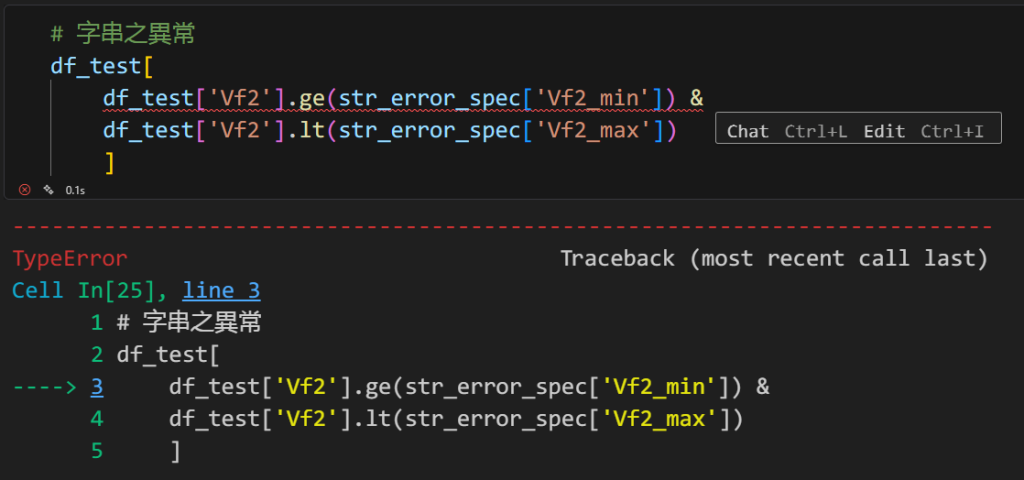
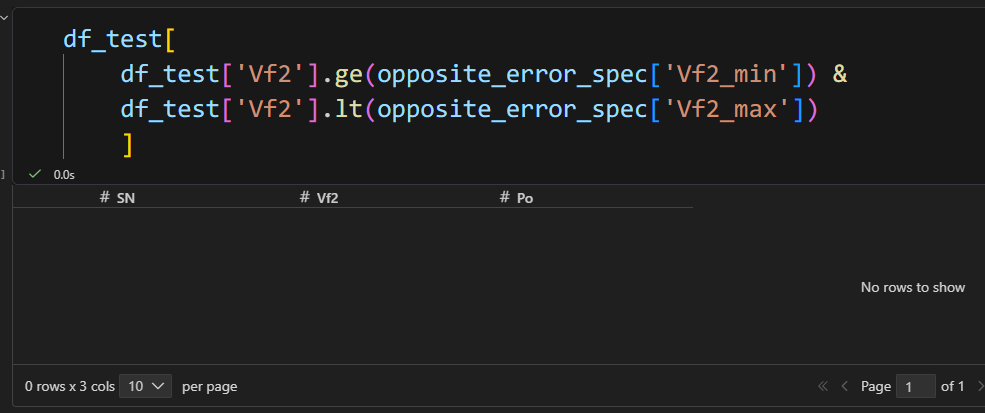
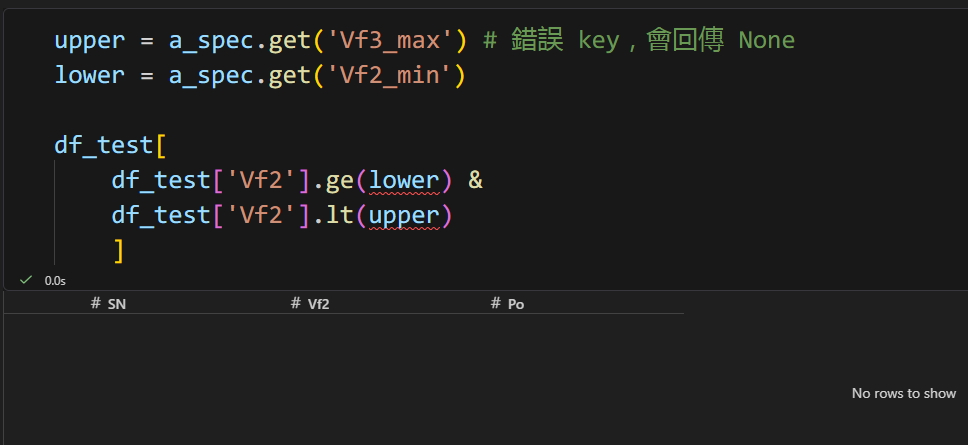
我們在 day 18 中知道了快速失敗的重要性,因此要排除這種執行期間完全無法發現的異常。以下的解紹模組會在輸入期間提供提示與驗證功能,在程式編輯階段便可攔截這樣的錯誤。
Dataclass 是一個輕量化、原生的資料模組,使用前直接 import 即可。
from dataclasses import dataclass, field
若要使用 dataclass,在 class 的定義式前加上 @dataclass 就會變成資料容器。此時只要在定義式下方設定 property:型別 即完成 property 設定,不用再呼叫 __init__ 了。
@dataclass
class AWafer:
    wafer_id:str
    lot_sn:int
    product:str
這個 class 的實例化也跟一般 class 一樣,呼叫類別名稱並傳入引數即可完成。
a_wafer = AWafer(wafer_id='VIP999', lot_sn=1, product='VIP888')
這個是使用 dataclass 的最大好處,我們像平常對物件取 property 一樣即可讀取資料。這樣子的讀取方式有以下好處:
語意清晰:比起用 tuple 儲存極值再用 a_spec[0] 讀取,我們會更清楚 a_spec.Vf2_min 的意義
支援 IDE 提示:不用再擔心打錯字了
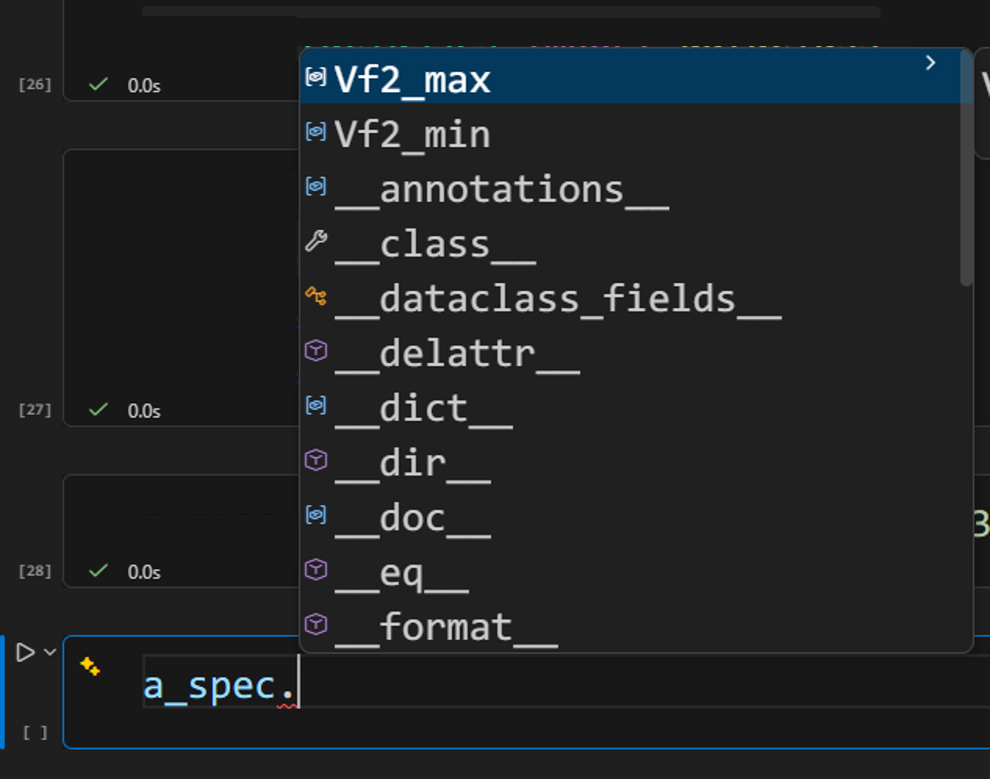
我們的資料可能會有預設值,或是不會在實例化物件時就記錄的屬性 (例如計算結果會在計算完成後才紀錄)。此時我們可以直接在該 property 設定預設值。
假設我們預設值要使用可變物件 (例如 list, dict 這種可以增加元素數量的對應物件),我們需要另外設定 field(default_factory=需求型別) 才能正常指定可變物件。
# 接續上面的 AWafer
    result:str = 'pass'
    fail_reason:list[str] = field(default_factory=list)
不可以在引數的預設值中使用可變物件的原因是預設值會隨計算過程變化,詳情請參考此處
當我們傳入資料並實例化這個 dataclass 後,這些資料就是我們資料 class 的 property 了。因此讀取資料的方式就是 物件.property 。
a_wafer.wafer_id # 'VIP999'
__post_init__(self):自動執行的流程__post_init__(self) 會在 dataclass 實例化後執行,因此適合放置會從初始屬性衍生之屬性
@dataclass
class Person:
  birth_year: int # 西元出生年
  birth_month: int
  birth_day: int

  def __post_init__(self):
    self.birth_year_minguo = self.birth_year - 1911 # 民國出生年
asdict():將 dataclass 轉成 dict 方便後續輸出我們若要輸出 dataclass 的內容,最方便的方式是先轉成 dict 後再轉換成 json/ dataframe 等格式。我們可以用 asdict() 快速的將 dataclass 轉換成 dict。
注意轉換出來之 dict 的 key 皆為字串
from dataclasses import asdict

asdict(a_wafer)
# {'wafer_id':'VIP999', 'lot_sn':1, 'product':'VIP888','result':'pass', 'fail_reason': []}
當我們直接使用 asdict() 時,所有 dataclass 內之屬性都會輸出到 dict 中。如果我們不希望輸出某些項目,可以先設定一個輸出格式的 function 再傳入到 asdict() 的 dict_factory= 中。
def my_dict(data:list[tuple[str, Any]]):
    # 'fail_reason' 會被 by pass
    return {field: value for field, value in data if field != 'fail_reason'}

asdict(a_wafer, dict_factory=my_dict)
# {'wafer_id': 'A123456789', 'lot_sn': 1, 'product': 'A888', 'result': 'pass'}
dict_factory= 支援各種輸出 dict 格式的設定,例如 by pass 某項目、巢狀 dict 等。
當我們呼叫 asdict() 時,其實是先將 dataclass 轉換成 list[tuple[str, Any]] 再輸出成 dict[str, Any]。我們可以利用這點做出各式各樣的格式:
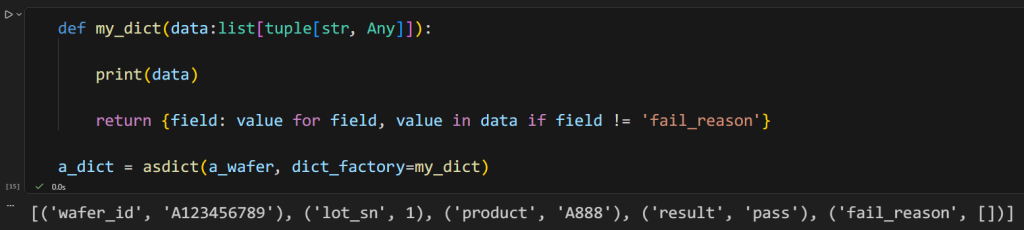
以下為巢狀表格之示範例:
def my_dict(data:list[tuple[str, Any]]):

    _res = {}

    for key, element in data:

        if key == 'wafer_id':
            _wafer_id = element # 抓取片號

        elif key == 'fail_reason': # 'fail_reason' 會被 by pass
            continue

        else:
            _res[key] = element

    return {_wafer_id:_res}

asdict(a_wafer, dict_factory=my_dict)
# {'A123456789': {'lot_sn': 1, 'product': 'A888', 'result': 'pass'}}
若我們把這些資料類別模組想像成放錢的器具,dataclass 是收銀機,店員收到錢要自己分類放入對應格子;而 Pydantic 就是投幣飲料機,從收錢、分類、出商品到開發票一應俱全。
Pydantic 是第三方模組,使用前要先用 pip 安裝。Pydantic 的基本 import 方式如下:
from pydantic import BaseModel
我們在自訂 class 中繼承 BaseModel 即可使用 Pydantic。
另外設定屬性的方式跟 dataclass 相同,為 property:型別 。
class YieldSPEC(BaseModel):
  product: str
  wavelength_type: Literal['wd', 'wp'] = 'wd'
  vf2_min:float = 2.8
  vf2_max:float = 3.3
  w_min:float = 440
  w_max:float = 460
傳入所需引數後即可實例化這個 class,另外要注意 Pydantic 只能用關鍵字引數 (key=)。
a_spec = YieldSPEC(product='LED', vf2_min = 2.9)
要讀取物件的資料也跟上面的 dataclass 一樣,呼叫 物件.property 即可讀取。
Pydantic 只能使用關鍵字引數的原因是
BaseModel的__init__設定只收關鍵字引數,目的是讓 self 也能當關鍵字引數使用。
這樣設計是因為 Pydantic 常用來處理網路資訊,某些資訊會有self=的 key,Pydantic 必須這樣設計才能用self=收這些資料 (來源)。
我們在 day 19 提到了讀取表格的資料(是字串)並轉換成適當型別。但在 Pydantic 中它會嘗試將我們輸入的型別不符資料、轉換成我們設定的型別,例如下面的 ' 2‘ 會被轉換成浮點數 2.0。
# vf2_min 的 2 是字串,而且前面還有空格
b_spec = YieldSPEC(product='bulb', vf2_min=' 2')

b_spec.vf2_min # 正常輸出 2.0
假設我們傳入的內容無法轉換成該 property 對應的型別,Pydantic 會直接發出 error。我們可以抓取這些 error 訊息在第一時間通知 user 設定有異常,避免錯誤流到後面去。
c_spec = YieldSPEC(product='bulb', vf2_min='aaa')

"""
ValidationError: 1 validation error for YieldSPEC
vf2_min
  Input should be a valid number, unable to parse string as a number [type=float_parsing, input_value='aaa', input_type=str]
"""
Dataclass 實例化時不會檢查型別,那些型別標示只是我們自己的筆記、讓 IDE 可以提示我們而已。
另外因為 Pydantic 是設計於接收網路資料使用,因此實例化時預設會忽略多出來的資料(若是 dataclass 會跳出 error)。例如下面的 foobar=...... 就會被忽略。
a = {'product': 'LED','wavelength_type': 'wd','vf2_min': 2.8,'vf2_max': 3.3,'w_min': 440,'w_max': 460, 'foobar':69}

b_spec = YieldSPEC.model_validate(a)
print(b_spec)
# product='LED' wavelength_type='wd' vf2_min=2.8 vf2_max=3.3 w_min=440.0 w_max=460.0
若希望有多餘資料時可以跳出 error,可以在 class 建立時加入 model_config = ConfigDict(extra="forbid") 。此時若有多餘引數會引發 error。
class YieldSPEC(BaseModel):

  # 剩餘 property 設定與上面相同
  model_config = ConfigDict(extra="forbid")

b_spec = YieldSPEC.model_validate(a) # ValidationError
使用
YieldSPEC.model_validate(dict)可以接收 dict 並實例化YieldSPEC
與 dataclass 的 asdict() 相同,Pydantic 也有一個 model_dump() 將資料以 dict 格式輸出。
我們可以使用引數 exclude= {property 名稱} 排除不想要輸出的欄位,使用上比 asdict() 的 dict_factory= 簡單。
a_spec.model_dump()
# {'product': 'LED','wavelength_type': 'wd','vf2_min': 2.8,'vf2_max': 3.3,'w_min': 440,'w_max': 460}

a_spec.model_dump(exclude={'product'})
# {'wavelength_type': 'wd','vf2_min': 2.8,'vf2_max': 3.3,'w_min': 440,'w_max': 460}
我們在 day 19 時實作在 controller 中、把 json 管理模組以及 table 管理模組連接在一起,讓使用者按下按鍵後可以將設定寫入到 json中。
若我們將限制使用者輸入與 Pydantic 這兩者結合,可以確保計算設定無論是 user 自行輸入、複製貼上、還是從 json 中讀取,都會是正確的格式。
今天我們會實作在 day 19 的存檔流程中加入 Pydantic 物件,將其當作過濾與轉換器轉換資料,再將資料寫入 json 中。新的流程如下圖所示。
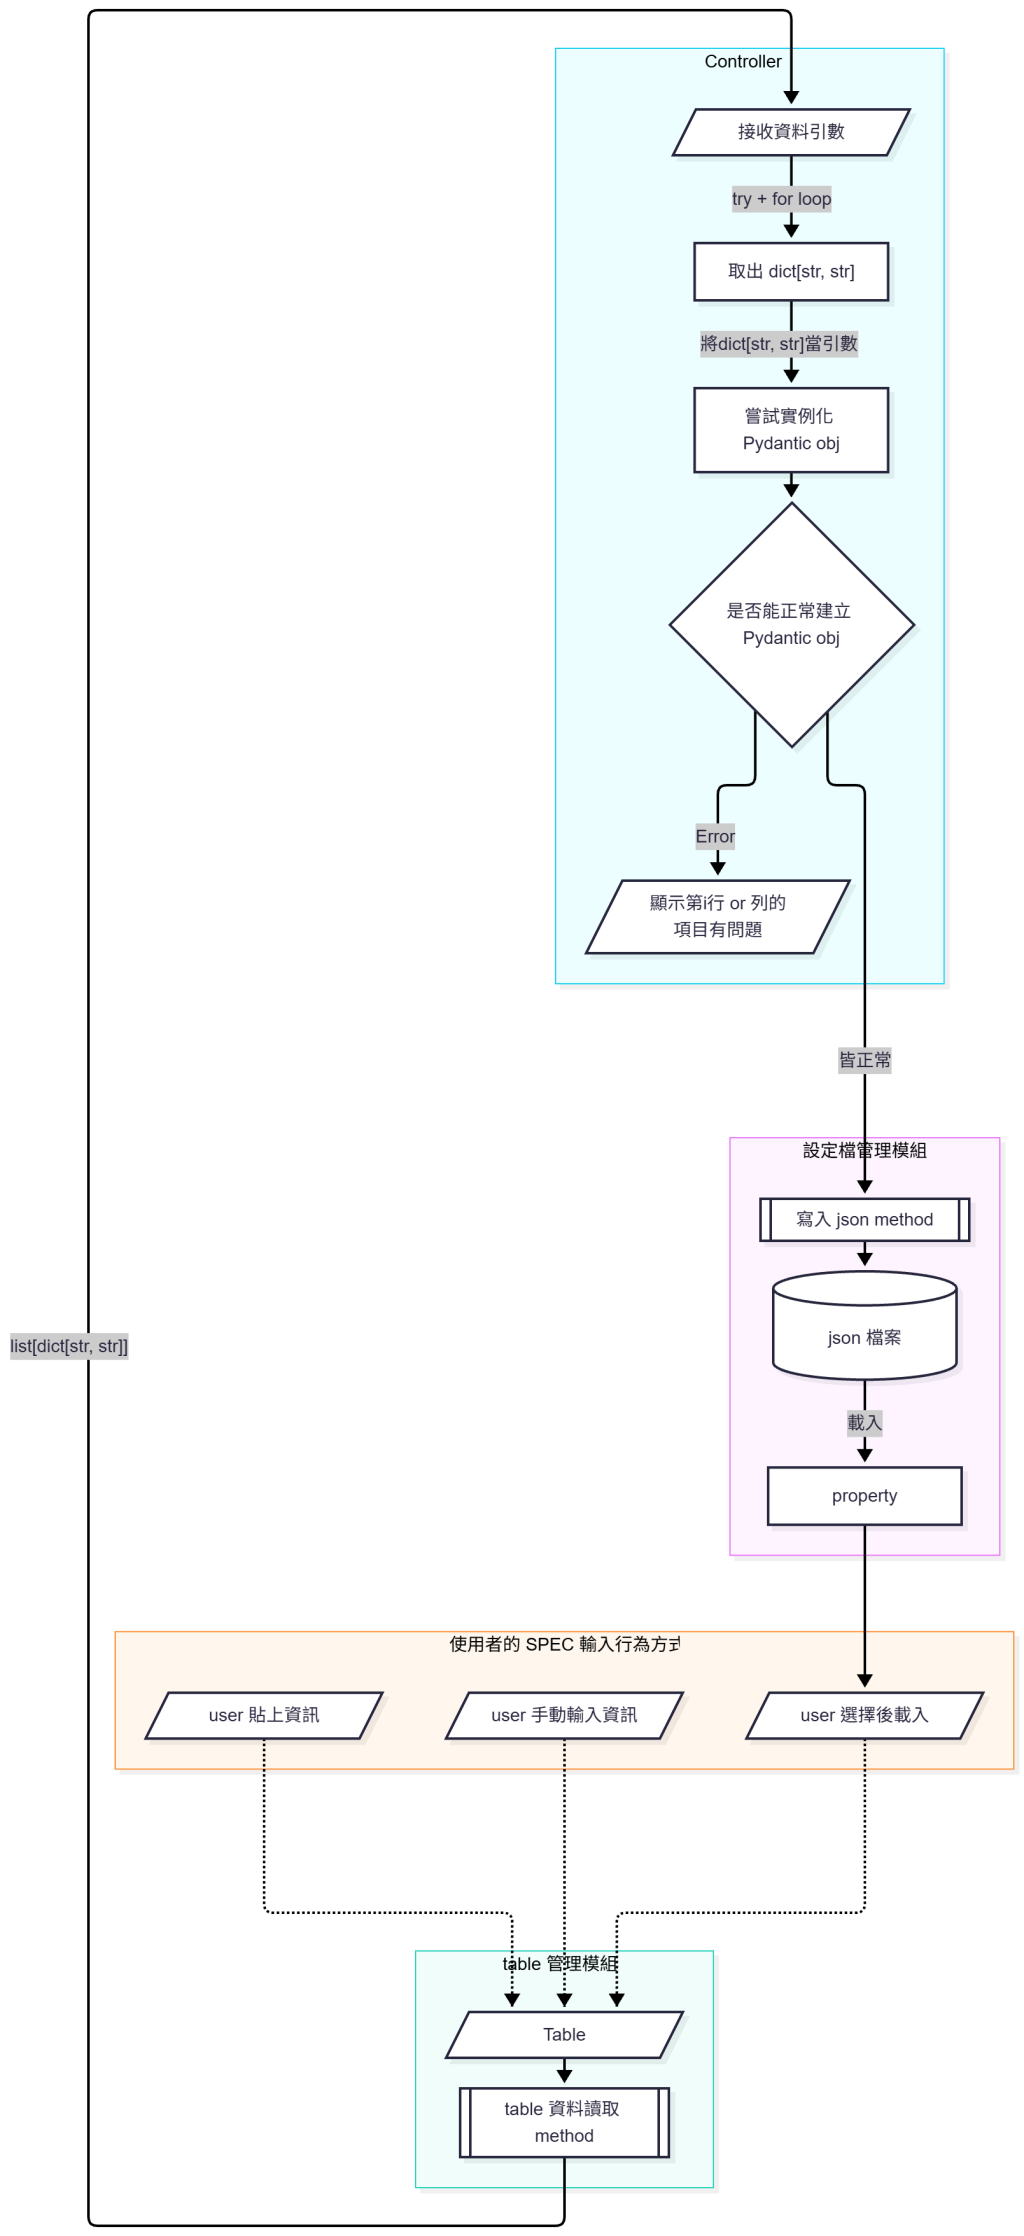
由於 Pydantic obj 也有自動轉換型別的功能,因此我們可以設定將 table 管理器的轉換型別關掉,先擷取出字串再讓 Pydantic obj 依設定型別作業。
def extract_table_data(self, parse_value:bool=True):

  # 前面省略,請看 day 19

      if read_direction == "v":

      # 逐列讀取資料
      for r in range(rows):
          row_data: dict[str, Any] = {}
          for c in range(cols):
              item = table.item(r, c)

              # 確認是否轉換資料
              if parse_value:
                  row_data[data_keys[c]] = _parse_value(item.text().strip())
              else:
                  row_data[data_keys[c]] =item.text().strip()# 直接寫入 str

          result.append(row_data)
接著再依照上面流程圖,在 controller 中將這三個物件串在一起便可在存檔前確保格式完全正確。
def add_data_to_user_spec(self) -> None:

    # 設定 SPEC 名稱
    write_spec = "user_spec"
    new_item_name = self.ui.a_lineedit.text().strip()


        raw_rows = self.spec_table_manager.extract_table_data(
            parse_value=False
        )

        validated_rows: list[dict] = []

        try:
            for row_index, raw_row in enumerate(raw_rows, start=1):
                # 使用 Pydantic obj 驗證輸入是否正確
                validated_row = YieldSPEC.model_validate(raw_row)
                validated_rows.append(validated_row.model_dump())

        except ValidationError as error:
            # 設定有異常會跳出錯誤並停止動作
            raise ValueError("\n".join(messages)) from error

        else:
            # 設定皆正確才寫入 json
            self.json_manager.save_user_config(
                spec_name=write_spec,
                new_item_name=new_item_name,
                data=validated_rows,
            )
簡單一句話:內部傳資料用 Dataclass; 從外面接收資料用 Pydantic
| 比較面向 | Dataclass | Pydantic |
|---|---|---|
| 使用情境 | 適合在程式內部傳遞資料 | 適合接收使用者輸入或 SPEC 等外部資料 |
| 執行速度 | 較輕量,沒有內建資料驗證 | 建立物件時會驗證資料,因此會多一些處理時間 |
| 多出欄位 | 傳入未定義的欄位會報錯 | 預設忽略多出的欄位,也可設定為保留或直接報錯 |
| 資料驗證 | 型別標註不會自動檢查資料 | 會依欄位設定檢查並轉換資料;自訂規則需另外設定 |
我們今天了解了資料物件的差別與使用方法,以及不同 class 之間的連動關係。
但今天的文章中有提到 ”Pydantic obj 可以做資料邏輯的驗證” (例如片號格式是否正確、大小值是否相反),這個部分會在明天 day 24 的文章中說明。


 iThome鐵人賽
 看影片追技術