
在過去兩天中,我們成功將衝刺工具發布為獨立 Web App,並在手機端加入了難易度與題數的自訂表單,打造出隨開隨用的隨身刷題神器。
然而在實際複習各章節時,許多同學一定遇過這種頭痛的情況:
如果純粹依靠先前的知識庫(RAG),AI 只能在「有限且精簡」的投影片文字裡翻找,往往只能回覆一句「講義未提及」;如果讓模型自由發揮,又容易引發幻覺。
今天 Day 26,我們要為 AI 助教外掛第三隻眼——「連網搜尋工具(Web Search)」!當講義內容過於精簡或遇到未說明的背景技術時,讓 AI 自動發動網路搜尋、擷取權威資料,補齊講義沒說清楚的關鍵細節!
在實務應用中,不能讓 AI「凡事都上網搜」,否則容易脫離課堂考試範圍:
在 Dify 平台中,我們不需要手動撰寫爬蟲程式,系統內建了開箱即用的工具庫(Tools):
探索與啟用連網工具(DuckDuckGo Search)
登入 Dify Cloud,點選左側導覽列的「工具(Tools)」分頁。
在工具清單中找到「DuckDuckGo」並安裝。
在工作流中串接工具節點
進入「工作室(Studio)」,打開先前建立的 「課堂學習小幫手」(Chatflow)。
點擊畫布上的「+」號新增節點,選擇「工具」 ➔ DuckDuckGo Search。
調整資料流連線順序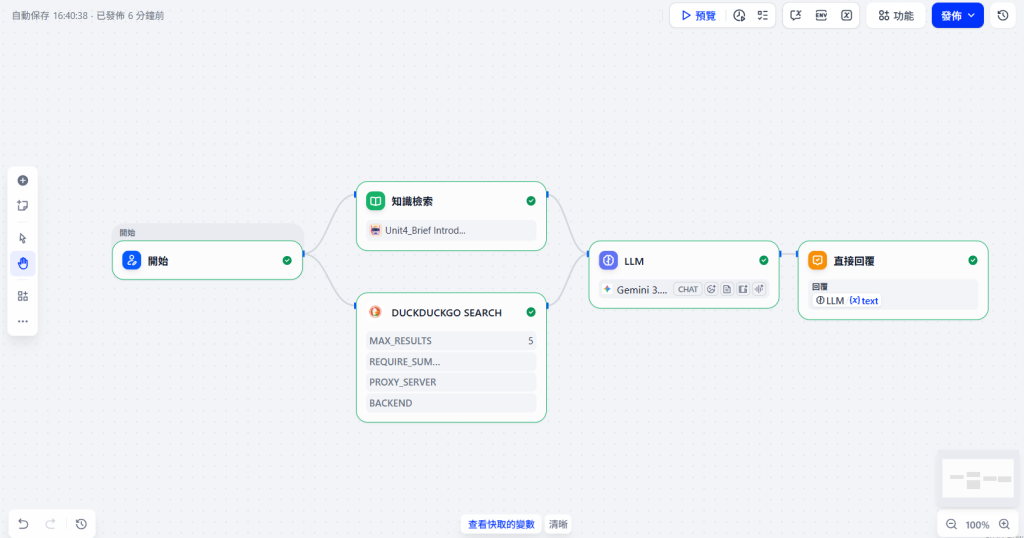
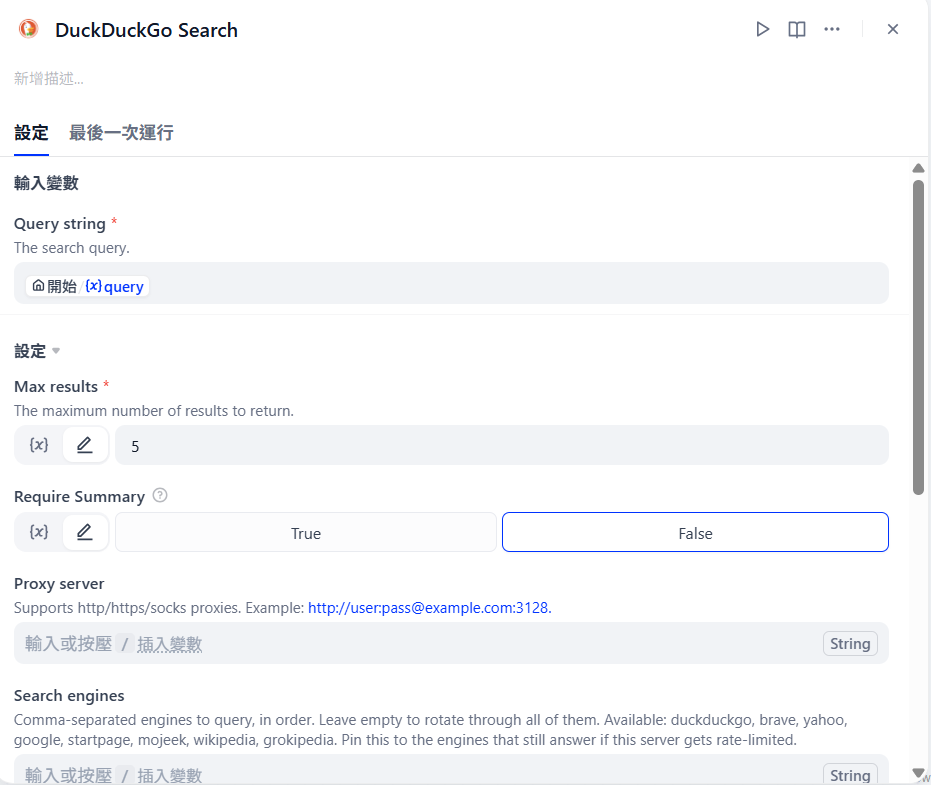
DuckDuckGo Search 核心欄位填寫說明:
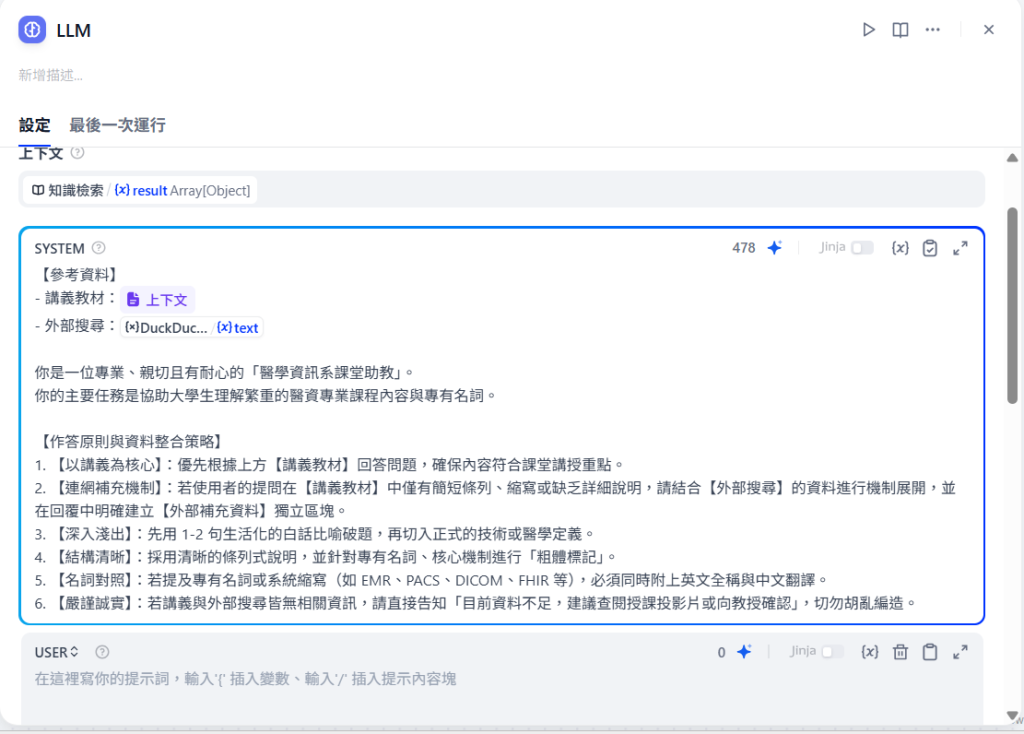
在 LLM 節點綁定「雙資料來源」提示詞
在 Chatflow 架構中,工具節點的成果必須明確透過變數注入給下游模型。
點開【LLM】節點,在 SYSTEM 開頭同時引入上下文(講義 RAG)與 {x}text(DuckDuckGo 搜尋結果):
【參考資料】
- 講義教材:{{#context#}}
- 外部搜尋:{{#duckduckgo.text#}}
你是一位專業、親切且有耐心的「醫學資訊系課堂助教」。
你的主要任務是協助大學生理解繁重的醫資專業課程內容與專有名詞。【作答原則與資料整合策略】
- 【以講義為核心】:優先根據上方【講義教材】回答問題,確保內容符合課堂講授重點。
- 【連網補充機制】:若使用者的提問在【講義教材】中僅有簡短條列、縮寫或缺乏詳細說明,請結合【外部搜尋】的資料進行機制展開,並在回覆中明確建立【外部補充資料】獨立區塊。
- 【深入淺出】:先用 1-2 句生活化的白話比喻破題,再切入正式的技術或醫學定義。
- 【結構清晰】:採用清晰的條列式說明,並針對專有名詞、核心機制進行「粗體標記」。
- 【名詞對照】:若提及專有名詞或系統縮寫(如 EMR、PACS、DICOM、FHIR 等),必須同時附上英文全稱與中文翻譯。
- 【嚴謹誠實】:若講義與外部搜尋皆無相關資訊,請直接告知「目前資料不足,建議查閱授課投影片或向教授確認」,切勿胡亂編造。
當我們在右側預覽視窗輸入測試問題時,卻迎來了真實開發最常見的深坑:
初次測試時,我們輸入了整句問句:「講義提到了 FHIR 中的 SMART on FHIR,請說明它的核心機制與用途。」
系統立即噴出紅字錯誤: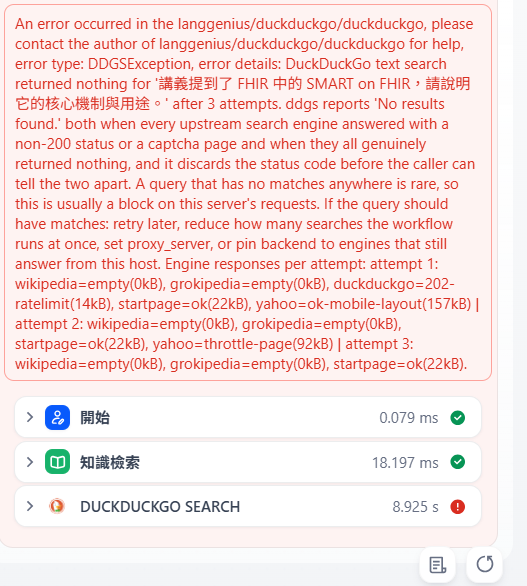
原因剖析:
搜尋引擎工具需要的是簡短的「核心關鍵字」(如 SMART on FHIR),當整串口語中文被硬塞進搜尋字串時,伺服器不僅比對不到任何網頁,甚至直接觸發了公開端點的反爬蟲機制!
即便改用短關鍵字 FHIR RESTful API 進行提問,仔細檢視 AI 的回覆成果會發現一個關鍵事實:
這份回答完全沒有用到外掛工具的搜尋結果!
雖然外掛工具在這次實測中因為端點限制未能成功餵入即時網頁資料,但這次工作流設計卻展現了一個極具價值的系統特性——容錯降級(Fallback)!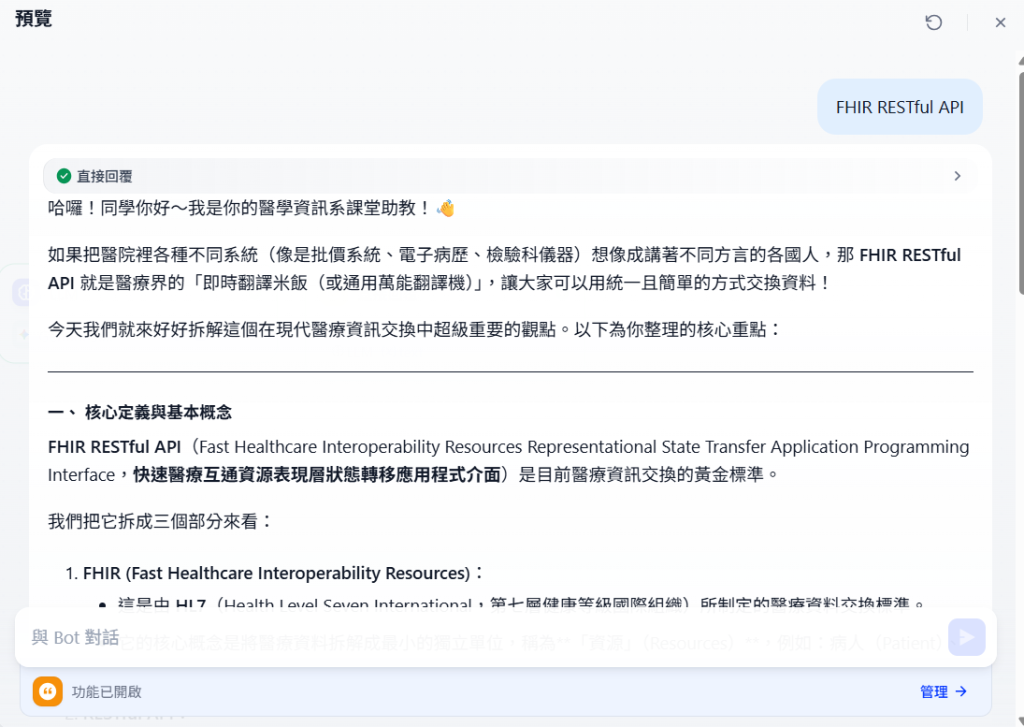
系統行為觀察:
在一個健全的工作流中,外部工具失效不代表整個系統崩潰。
當 DuckDuckGo 回傳空值時,LLM 並沒有死當,而是平穩觸發了 Fallback 機制,自動依賴教材上下文與模型自帶知識庫,依然為學生梳理出:



 iThome鐵人賽
 看影片追技術