
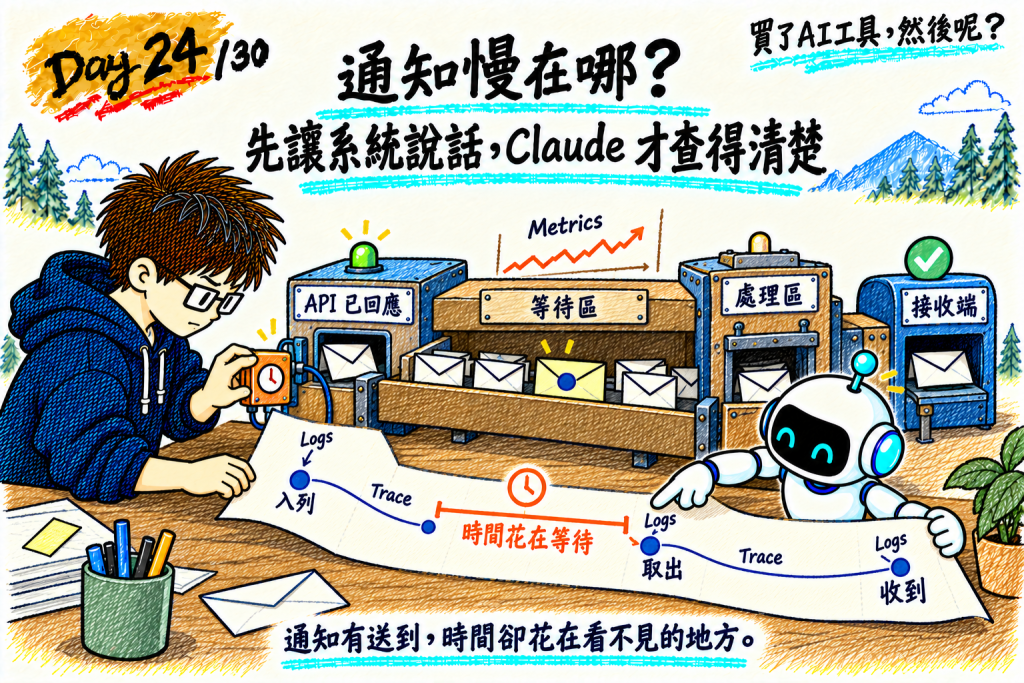
Day 22 結尾留了一個問題:服務持續運行時,該留下哪些訊號,才能及早發現問題? Day 23 先看到「沒留下」的代價:監控說成功,六筆通知卻沒到;而且能查出來,是因為我知道通知契約、當時的程式版本和兩端紀錄放在哪,先找齊、整理好,才交給 Claude。換成接手的同事,或半夜值班的人,手上通常只有一句客訴。
漏送問的是「有沒有」。這次換一個更常見、也更難查的客訴:「取消很快,通知卻晚了好幾秒。」 通知確實送到了,所以數筆數的對帳抓不到問題;要回答,得知道時間花在哪一段。原本的系統只在本機留下發送端與接收端各自的 JSON Log:API 有回應時間,通知在佇列裡等了多久沒有記錄,也沒有東西把同一筆通知從 API 串到接收端。稍後那輪查詢裡,Claude 對修改前那段時間的結論是:有多慢、慢在哪,未知。
所以今天要回答兩件事:通知慢在哪?系統又要先留下什麼、把什麼工具接給 Claude,它才查得清楚?
這是第四幕「服務上線之後怎麼維運」的第二篇。路線是:先回規格決定要留哪些訊號 → 把訊號補進程式 → 用 gcx 透過 MCP 把查詢工具交給 Claude → 用同一個客訴再問一次。 這次只改觀測、不修通知功能,用 .NET 訂單教學服務實作。
可觀測性,是系統出狀況時,能不能從它留下的線索理解發生了什麼。 監控告訴你「變慢了」,但要回答「慢在排隊、處理,還是接收端」,得有對得起來的 Log、指標與請求路徑。〈為什麼我們需要 Observability?〉這份分享把可觀測性拆成三步:讓系統說話、聽見並理解訊號、用數據驅動優化;今天做的是前兩步。
到了 AI 時代,第一步更不能等上線後才補。 程式產生得更快,團隊不一定讀得完、記得住每個分支;查問題的也可能是 Claude,它讀程式只看得到系統「可能」怎麼執行,要有同一版本的運行資料,才能核對「實際」發生了什麼。這就是可觀測性驅動開發(Observability-Driven Development,ODD):開發時就先問「上線後怎麼知道它做好了?沒做好要靠什麼查?」,再把訊號寫進程式,並在測試時確認查得到。以取消訂單為例,完成條件(Day 6)包含通知送達,就不能只留下 API 回傳成功。
要決定留什麼訊號,先回到規格。Day 18 我把「取消訂單後,通知怎麼送」整理成 wiki/notification.md,它的來源欄指向通知契約 v2.1。這次沿用同一份契約,沒有另寫一套新規格;為了讓實驗隔離,給 Claude 的是契約副本,不是讓它在這輪自己翻 Wiki。
我先拿回 Day 10 那條關係:取消 API → 背景 worker → 通知接收端。API 回應後,通知還可能在排隊;發送端說送出,也還要對接收端留下的紀錄。沿著這條路,逐段問需要留下什麼:
| 要回答什麼 | 可觀測性訊號(Signal) | 要留下什麼 | 為什麼只看 API 不夠 |
|---|---|---|---|
| 哪段時間開始變慢? | Metrics(指標) | 排隊等待的分布與樣本數 | API 很快回應,背景工作仍可能累積 |
| 這筆通知走到哪裡? | Logs(日誌) | 入佇列、開始處理、送出、接收端收到 | 要用同一個通知 ID 對兩端,不能拿送出計數代替 |
| 慢在等待還是下游? | Traces(追蹤) | API、worker、HTTP 呼叫與接收端的關聯 | 原請求結束後,背景工作的關聯仍要保留 |
notification_id 用來對同一則通知,trace_id 串起一次操作跨過的路徑,run_id 限定這次演練。這些識別碼放在 Log/Trace,不把每筆訂單變成一組 Metrics 標籤。通知契約沒有定義排多深、等多久才算異常,所以這次只量等待,不自行訂門檻。
我保留原始服務,另外建立 before 與 after 兩份副本,兩份使用相同取消規則;修改版只新增觀測。
OpenTelemetry(OTel)是一套開放標準,讓程式用同一種方式產生 Log、指標與 Trace,再送到支援的後端。 這次的埋點都用 OTel 的 API 寫:程式負責產生訊號,Collector 負責收集,Loki、Prometheus、Tempo 負責保存;之後要查,才輪到 gcx。訊號要經過這幾層,才到得了 Claude:
| 層 | 誰負責 | 這篇做什麼 |
|---|---|---|
| 決定留什麼 | 規格 | 從 Wiki 與契約推出:記排隊時間、串起 Trace、兩端各自留紀錄 |
| 產生 | OpenTelemetry 埋點 | 三處修改:接收端自己寫收到紀錄(不複製發送端)、把 API 的 Trace 接進背景 worker、另外量排隊時間 queue_wait_ms |
| 收集與保存 | Collector → Loki/Prometheus/Tempo | Log、指標、Trace 各存一處 |
| 查詢 | gcx | 從三個儲存庫讀資料 |
| 解讀 | Claude(透過 MCP 呼叫 gcx) | 看結果、決定補查什麼、對照程式 |
前兩層做完,資料才存在;gcx 只負責讀,不負責留。
關鍵改動在 after/src/Api/Program.cs。建立通知時,先記下它來自哪個 API 請求(Parent),以及開始排隊的時間(QueuedAt);worker 取出通知時,再補上這段:
using var span = Obs.Source.StartActivity(
    "notification.process", ActivityKind.Consumer, n.Parent);
var wait = Stopwatch.GetElapsedTime(n.QueuedAt).TotalMilliseconds;
span?.SetTag("queue.wait_ms", wait);
Obs.QueueWait.Record(wait);
看第一行的 n.Parent:它讓背景工作接回原本 API 的 Trace,API 回應之後,通知的後半段仍找得到。SetTag 留下這筆通知等了多久,Record 把等待時間送進指標的直方圖。Obs.Source、Obs.QueueWait 就是 OTel 的 Trace 與指標 API。
我另外查過後端,確認兩端紀錄、等待指標與跨程序的 Trace 都真的收到。這些埋點是備稿時的工程工作,下面才是 Claude 的實際查詢。
Day 17 已經用 Grafana MCP 讓 Claude 查過 Loki。這次要同時查 Log、指標與 Trace,所以查詢入口改用 gcx,Grafana 的命令列工具,原因有三個:
這種「工具取資料、模型判讀」的分工,也是 Grafana 官方 o11y-bench 評估 Agent 查觀測資料的方式;本篇只借鏡分工,不是 benchmark 成績,查得準不準留到後面再驗。
把工具接給 Claude,不只是讓它多幾個指令: 它能在授權範圍內自己取得資料,用查到的結果決定下一步。這次用一個自訂的唯讀 MCP 介面把 gcx 接給 Claude,它只看得到一個查詢工具,只能讀、不能改;Grafana 帳號是 Viewer,每次查詢都留紀錄。程式與通知契約則用本機 Read 讀取。這不是官方 Grafana MCP;設定、工具欄位與指令範例放在文末。
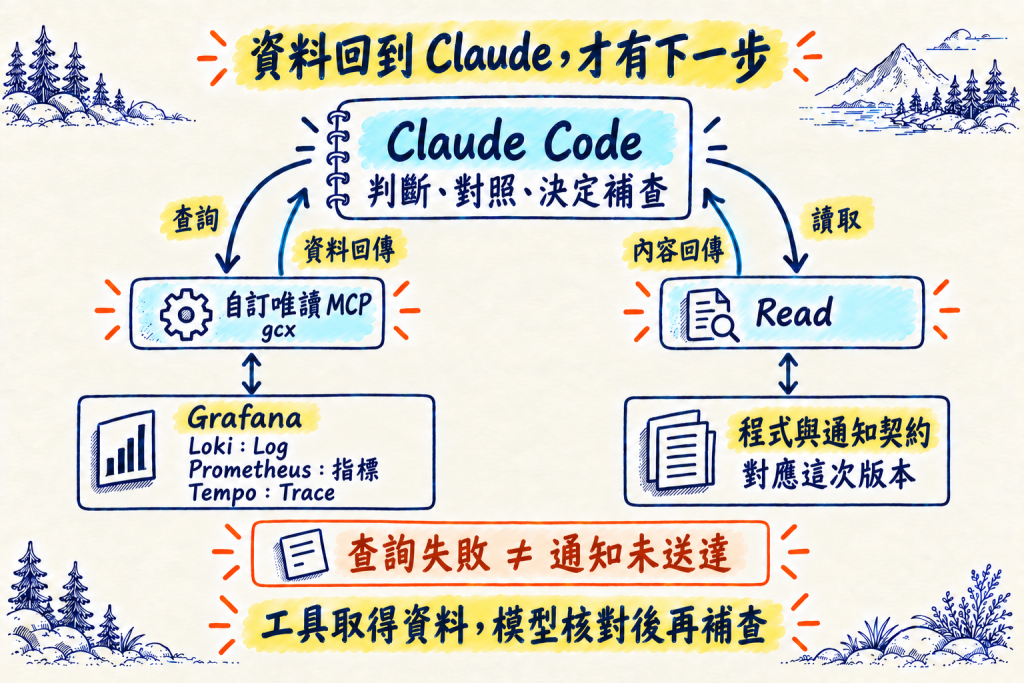
資料回到 Claude,由它決定下一個查詢。對照前面的分工表:OTel 負責留下線索,gcx 負責取得線索,Claude 負責對照。
我先固定比較條件:正常接收端與刻意延遲 250 毫秒的接收端,各跑一次觀測修改前、修改後,共四輪。每輪建立九筆訂單並取消,再重複取消第一筆,核對是否多發通知。250 毫秒是用來製造慢下游的教學設定,不是服務承諾。接下來要看的是:同一種情境,補完觀測後多查得到什麼。
我給 Claude 的是同一句客訴、修改前後各兩組時間窗、服務名稱與程式位置;沒有先貼好 Log,也沒有給它 Trace ID。它透過唯讀工具查了十次,關鍵是這幾步:
| 步驟 | Claude 做了什麼 | 結果 |
|---|---|---|
| 1 | 列出可用的資料來源 | 找到 Loki、Prometheus、Tempo |
| 2 | 一次查所有服務的 Log | 輸出超過長度限制,改成只查接收端 |
| 3 | 查兩個接收端的 notification_received |
正常、慢情境各 9 筆,有獨立的接收證據 |
| 4 | 用 after-slow-8 找發送端紀錄 |
拿到這筆通知的 trace_id |
| 5 | 讀那一條 Trace | 拆出 API、排隊、worker、下游四段時間 |
第 3 到第 5 步實際送出的查詢是這三行,看 --expr 怎麼一步步收窄,最後換成 traces get:
gcx logs query -d loki --expr '{service_name="day24-fakesink-slow"} |= "notification_received"'
gcx logs query -d loki --expr '{service_name="day24-api-slow"} |= "after-slow-8" | json'
gcx traces get -d tempo <trace_id> --llm
這就是「結果回到 Claude,由它決定下一步」:先證明通知真的到了,再挑一筆慢的,最後才讀 Trace 拆時間。
修改前,它的回答是:
前版沒有集中匯出,工具查不到……前版的實際行為、通知是否送出、有多慢,我標為未知,不當成沒執行。
修改後,同一個問題,它從一筆慢通知 after-slow-8 拆出:
| 階段 | 實測時間 | 依據 |
|---|---|---|
| API 回應 | 約 1.6 ms | POST /orders/{id}/cancel server span |
| 等 worker 取出 | 約 2,187 ms | queue_wait_ms,從建立通知、準備入佇列起算 |
| 呼叫接收端 | 約 266 ms | HTTP client span;接收端自身約 259 ms |
| worker 處理 | 約 269 ms | notification.process,包含下游呼叫 |
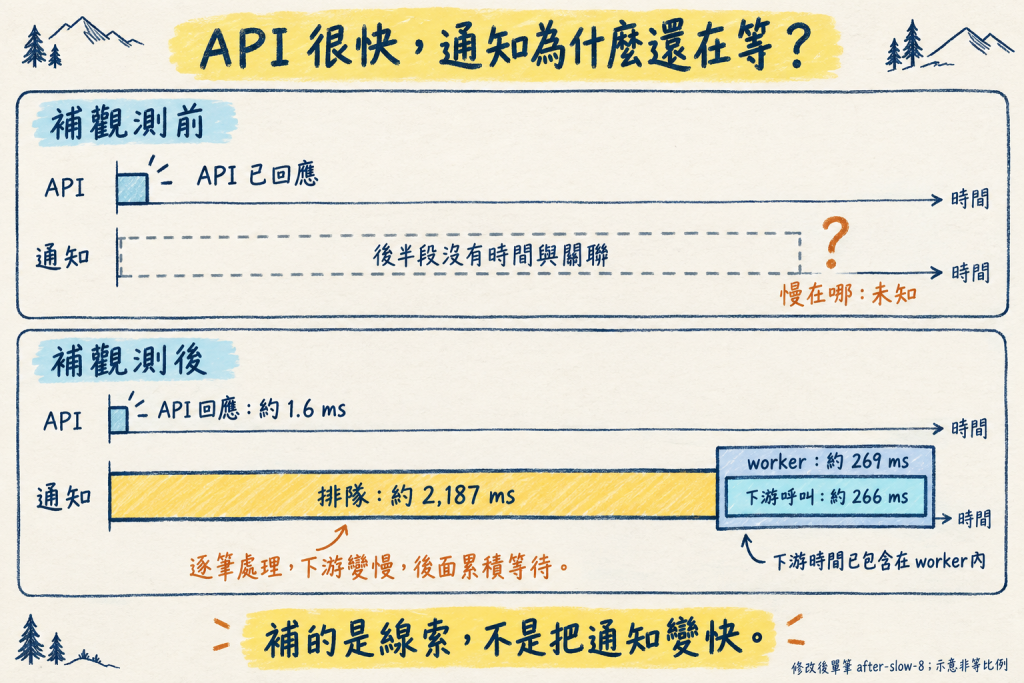
先看上半部的虛線:補觀測前,API 回應之後的那一段是空白。下半部才看得出時間花在排隊。
API 很快完成,通知卻大部分時間花在排隊;兩者量的是不同一段工作。 worker 一次只處理一筆,每筆都得等接收端回應,後面的通知便累積等待。Claude 沒有讀到刻意延遲的設定,所以把「下游變慢」保留為推論,我再用演練參數核對。等待主要發生在佇列,不代表成因與接收端無關;補的是線索,沒有把通知變快。
先核對功能:四輪(正常與慢接收端,各有修改前、修改後)都是取消 9 筆、收到 9 筆,重複取消也沒有多發通知。這由固定程式核對請求回應與接收端原始紀錄,只確認本輪功能一致,不代表整個系統已做完回歸。
Trace 中,worker 的 parent 指向原本 API span,下游 client 再接到接收端 server span;固定核對也驗了這條關係,確認兩個情境的十八筆接收紀錄都進了 Loki。所以「串起來了」不只是模型的說法,後端原始資料也查得到。
查詢也碰過兩次錯:除了上面那次查太廣,做 Log 數量查詢時又超過 500 組 series 上限,縮小到本次服務後才成功。
我也刻意讓它查一個不存在的來源。gcx 回非零退出碼,它記成查詢錯誤,沒有當成另一個漏送事故。
修改前那段時間查無資料,它寫成「未知」,沒有當成通知沒執行。修改前其實有本機接收紀錄,只是不在這輪授權範圍內;所以差別在取得資料的方式,不是補了觀測才有通知。
它只完整拆解了一筆慢通知,沒有逐筆核對所有 Trace;請求結果與接收數由固定檢查另行核對,不能都算成模型查出的。
這筆通知主要等在佇列。 API 1.6 毫秒就回應,通知卻等了兩秒多才被 worker 取出;逐筆處理又必須等待下游回應,讓後面的通知累積等待。補完觀測,這段時間才有依據可以核對。
這次我學到的,不是 Claude 又多會一種查詢:
可觀測性不是上線後才補的監控,而是開發時就決定「出事時要靠什麼查」;AI 寫得越快,這件事越不能等上線後再補,這也是讓 Claude 從讀程式猜,變成拿資料核對的前提。
今天驗的是讓 Claude 有條件查;面對未知故障,它能不能選對查詢、排除錯誤原因,也就是查得對,留到後面再驗。
線索查得到了。但團隊每天要看的不是一筆 Trace,而是使用者的工作完成了多少、還有哪些要處理。明天 Day 25,從規格把這張 Dashboard 做出來。
參考資料:


 iThome鐵人賽
 看影片追技術