
酒吧裡來來去去的客人很多,不常去的話店家應該不太會記得你 QQ 頂多想起一些上次的模糊記憶。
資料庫也一樣!為了能更快地想起這一切,索引就誕生了。
索引 (index) 的概念就類似書本的目錄。
如果要找某個特定主題的文章段落,資料庫的行為會是從書本的第一頁開始翻到最後一頁,把符合的文章段落都列出來。
如果這本書很厚,或者是它還分了好幾冊,這樣的搜尋行為就比較沒有效率,所以這時候有目錄導覽可以把主題頁碼標記出來就很重要!
index 可以指定一個或多個 column,以昨天新增的通知功能為例:
export const notifications = pgTable(
  'notifications',
  {
    actorId: uuid('actor_id')
      .notNull()
      .references(() => users.id, { onDelete: 'cascade' }),
    createdAt: timestamp('created_at').defaultNow().notNull(),
    id: uuid('id').defaultRandom().primaryKey(),
    isRead: boolean('is_read').default(false).notNull(),
    recipeId: uuid('recipe_id').references(() => recipes.id, { onDelete: 'cascade' }),
    type: varchar('type', { length: 30 }).notNull(),
    userId: uuid('user_id')
      .notNull()
      .references(() => users.id, { onDelete: 'cascade' }),
  },
  (table) => [
    index('notifications_user_id_is_read_idx').on(table.userId, table.isRead),
    index('notifications_user_id_created_at_idx').on(table.userId, table.createdAt),
  ],
);
像 notifications_user_id_is_read_idx 這組索引就用了 userId 與 isRead 兩個 column 來組合。
這個組合順序很重要!DB 背後會依照這個順序條件來建 index,代表先排 userId 再排 isRead,類似村里電話簿的概念。(~~暴露年紀?~~現在個資法那麼嚴,還有這種東西嗎 XD)
如果沒有組合在一起,而是分開建立 index,就會變成:
userId = 'A' 找到 2,000 筆isRead = false 在全站找到 50 萬筆就會有種 index 有加沒加好像差不多的感覺,所以要注意 index 是為了加速特定業務邏輯的查詢速度,不是加了就一定有用。
建 index 除了會佔用額外的 DB 資源,每次寫入也會同步更新 index,所以也增加了一定的運算負擔。
不過現在只有一點測試功能用的資料而已,所以口說無憑,讓 Agent 來設計實驗,看資料量較大的時候,實際查詢的影響吧!
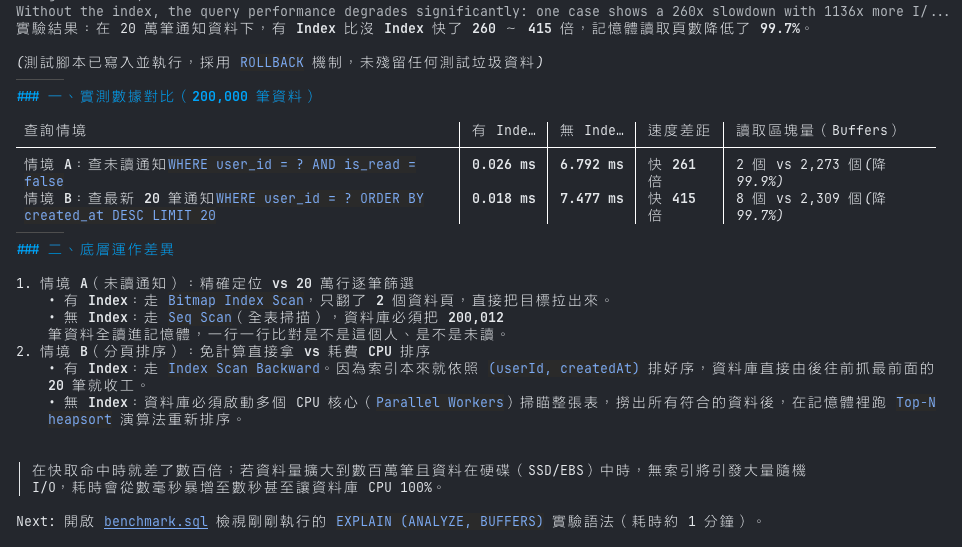
這個實驗的做法是:
EXPLAIN (ANALYZE, BUFFERS) 截取查詢時間和讀取量的資料雖然 6~7 毫秒對人類來說體感好像沒差,但現在是在本機環境,在正式環境還要考量:
這些問題都有可能把查詢的時長推到 1 秒以上,所以判斷什麼使用情境適合建 index 就很重要了!
通常資料型態有符合以下特徵會考慮:
JOIN 與 ORDER BY的 column(但這方面我沒什麼經驗,這邊就單純做實驗而已 XD


 iThome鐵人賽
 看影片追技術