
用 Claude Code 久了,最常聽到的兩種抱怨剛好相反:一種是「我明明講過了,它怎麼又忘了」,另一種是「才做一半,context 就滿了」。這兩件事其實是同一個問題的兩面:什麼東西該讓它記住、記在哪裡、什麼時候載入。今天把 Claude Code 裡「記得」的機制拆開,再講我怎麼分層,以及長任務怎麼收 context,讓它記得該記的、忘掉該忘的。
| 機制 | 誰寫 | 放什麼 | 什麼時候載入 |
|---|---|---|---|
| CLAUDE.md | 你 | 規則與指示 | 每次啟動,全文載入 |
.claude/rules/ |
你 | 拆開的規則,可限定路徑 | 沒設 paths 的啟動時載入;設了的碰到符合的檔案才載入 |
| auto memory | Claude | 你的糾正、偏好、從程式碼看不出來的專案狀態 | 啟動時只載入索引 MEMORY.md,個別記憶檔用到才讀 |
| session 續接 | 自動 | 整段對話歷史 | --continue、--resume 時 |
幾個常被誤會的地方:
@ 匯入不省 context。 匯入的檔案會在啟動時一起展開,它只是幫你整理長檔案,最多遞迴四層。/clear、/compact 或重開才載入。# 開頭快速加記憶的捷徑已經移除了。 現在對它說「記住某件事」,會存進 auto memory;要寫進 CLAUDE.md,就直接說「把這條加到 CLAUDE.md」,或用 /memory 打開編輯。auto memory 的索引 MEMORY.md 每次啟動只載入前 200 行或前 25KB,哪個先到算哪個。超過的部分不會被載入,寫入時還會要求重寫索引。官方也講了它會刻意不存的東西:能從程式碼推出來的架構、檔案路徑、除錯過程,以及 CLAUDE.md 已經寫過的事。開關在 /memory 裡,或設 CLAUDE_CODE_DISABLE_AUTO_MEMORY=1 關掉。
記憶檔存在 ~/.claude/projects/<專案>/memory/,同一個 repo 的各個 worktree 與子目錄共用一份。它只存在本機,不會跨機器同步,也不受一般 30 天的自動清理影響。要搬位置可以設 autoMemoryDirectory;想在多台機器之間共用,可以把它指到一個同步資料夾,但要留意記憶裡可能有不該外流的內容。不處理的話,換一台電腦,它就像第一次見到你。
如果團隊同時用 Claude Code 與其他 AI 工具,還有一個相容細節:Claude Code 只有在找不到 CLAUDE.md 時,才會改讀 AGENTS.md,切換方式在 /config 的 Project instructions。兩份並存時,它預設只認 CLAUDE.md。
規則寫久了會互相打架,官方也提供了檢查工具:CLAUDE.md 超過建議長度時,啟動與 /status 都會出現警告;/doctor 會提出精簡建議,/doctor prompt-audit 會找出過時或互相矛盾的指令。後者特別值得定期跑,因為規則矛盾通常不是一次寫錯,而是不同時期加進來的兩條,各自看都對。
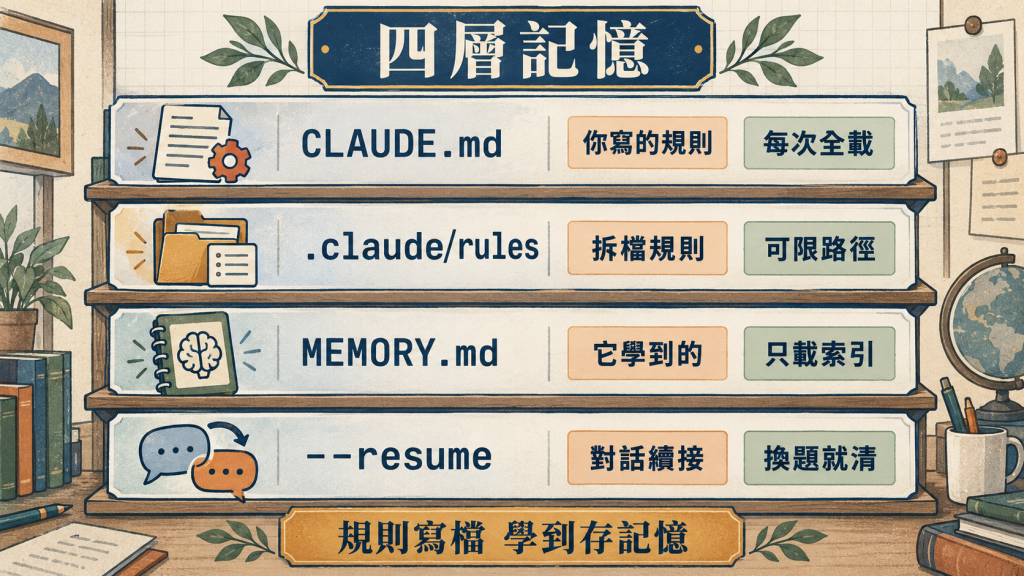
我的原則很簡單:規則寫進檔案,學到的存成記憶,對話裡講的不算數。 對話裡交代的事,在壓縮或換 session 之後都可能消失,真的重要就落到檔案裡。
CLAUDE.md 只放路由與少數硬規則。 它每次都全文載入,每一行都在付成本,官方建議每份控制在 200 行以內。我的寫法是把細節拆到規則檔,CLAUDE.md 只告訴它「什麼時候該去讀哪一份」:
# CLAUDE.md(示意)

- 回覆一律使用繁體中文。
- 修改資料庫 migration 前,先讀 `.claude/rules/migrations.md`。
- 改測試前,先讀 `.claude/rules/testing.md`。
- 完成前必跑:`npm test` 與 `npm run lint`。

<!-- 維護註記:HTML 註解在載入前會被拿掉,不佔 context -->
最後那行 HTML 註解是官方特別說明過的:區塊層級的 HTML 註解會在送進 context 前被剝掉,適合放給人看的維護說明。
只在特定檔案才需要的規則,用 paths 限定。 例如只有改前端元件時才需要的規範,沒有理由每次都載入:
---
paths:
  - "src/components/**/*.tsx"
---

元件一律用函式元件,props 用明確的型別,不寫 any。
paths 是規則檔唯一會被讀的 frontmatter 欄位,其他欄位會被靜默忽略。要注意它是在 Claude 讀寫符合的檔案時才觸發,所以真的需要常駐的規則,就不要加 paths。
被糾正過的偏好,存成一條一條的記憶。 auto memory 原本是 Claude 自己寫的,官方格式只要求 frontmatter 有 type。實務上可以讓它照一個更完整的格式記:加上名稱與一句描述,內文寫事實本身,再加「為什麼」與「怎麼套用」:
---
name: no-default-exports
description: 這個 repo 的模組一律用具名匯出,不用 default export
type: feedback
---

模組一律用具名匯出。

**Why:** 重新命名與自動匯入時,default export 常讓編輯器帶錯名稱。
**How to apply:** 新增或修改模組時改成具名匯出;看到舊的 default export 先問再改。
索引 MEMORY.md 只寫一行一條的指標,例如 - [不用 default export](no-default-exports.md):模組一律具名匯出。記憶的類型,官方分成使用者(你是誰、偏好)、回饋(你糾正過的做法)、專案(從程式碼看不出來的進度與決策)、參考(外部資源在哪裡)四種。「為什麼」這一行最重要:沒有理由的規則,下一次遇到邊界情況時它不知道怎麼判斷,有理由它才能類推。
一條新的東西該放哪裡,可以用這張表判斷:
| 內容 | 放哪裡 | 理由 |
|---|---|---|
| 每次都要遵守的硬規則 | CLAUDE.md | 全文常駐,越短越好 |
| 某類工作才用到的做法 | 規則檔加 paths,或做成 skill |
用到才載入 |
| 被糾正過的偏好、專案進度 | 記憶 | 跨 session 留著,索引常駐、內文按需讀 |
| 一定要執行、不能靠自覺的事 | hook | 不佔 context,也不靠它記得 |
| 這次對話才用得到的細節 | 不用存 | 結束就讓它消失 |
最後一列反而最常被忽略:不是每件事都值得存,什麼都存,記憶就變成另一種雜訊。
規則與記憶都要定期精簡。 規則檔每加一條教訓都會變長,最後自己變成 context 的負擔。做法是替規則檔訂一個行數上限,超過就把最少用的整塊搬到引用檔;已經結束的專案記憶,可以從索引移出、另外存放,不列在索引裡就不會每次載入。重點是只搬家與去重,不在精簡時順手改動規則的意思。
官方整理過各種擴充機制佔用 context 的方式:
| 東西 | 什麼時候載入 | 佔多少 |
|---|---|---|
| CLAUDE.md | 啟動 | 全文,每次請求都送 |
| skill | 啟動時只有描述,用到才載全文 | 描述每次都送 |
| MCP server | 啟動時只有工具名稱,用到才載完整定義 | 用到之前很少 |
| subagent | 被派出時 | 在自己的 context,與主對話隔離 |
| hook | 觸發時 | 不佔,除非它回傳額外內容 |
所以減量的方向很清楚:專門的指示搬到 skill,用到才載入;有 CLI 可用就別多接 MCP;不需要模型自己判斷何時使用的 skill,設 disable-model-invocation: true,描述就完全不佔 context;大量的搜尋與閱讀交給 subagent,只讓摘要回到主對話。最後一條,Day 4 提過一個好用的門檻:只要一件事要讀三個以上的檔案才能回答,就派 subagent 去讀,主對話只收結論與檔案位置,長產物落檔、只回路徑。
還有一個容易忽略的來源:hook 回傳的額外內容會進入 context,壓縮時再跟對話一起被摘要。像 SessionStart 這種每次開場都注入資訊的 hook,內容要短,只放開工真正需要的東西;寫得太長,等於每個 session 一開始就先付掉一段成本。
想知道現在 context 被什麼佔掉,用 /context,它會用格子圖分類顯示,並列出這次實際載入了哪些 CLAUDE.md 與記憶檔。子目錄的 CLAUDE.md 因為是按需載入,不會出現在這個清單裡。
/compact:壓縮。 它把目前為止的對話摘要成較短的版本,可以帶指示,例如 /compact 聚焦在登入錯誤的修正,摘要就會留下你指定的重點,而不是讓自動壓縮去猜。也可以在 CLAUDE.md 加一段 Compact Instructions,寫明每次壓縮都要保留的東西,例如「保留修改過的檔案清單與測試指令」。接近上限時它會自動壓縮,門檻可以用 /autocompact 調整,例如 /autocompact 500k 讓它早一點壓。
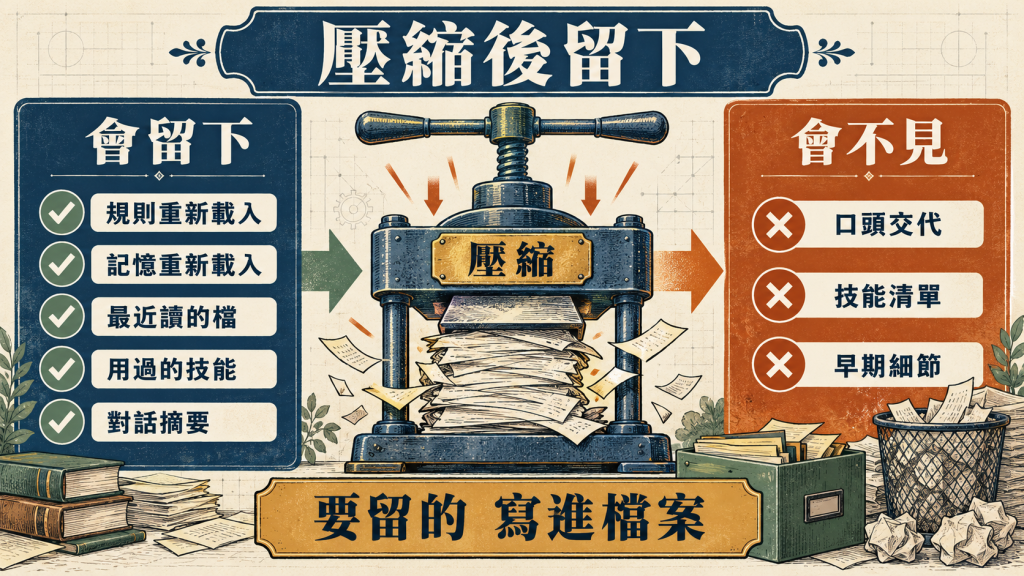
壓縮後哪些東西會留下,官方列得很清楚:專案根的 CLAUDE.md 與沒設路徑的規則會從磁碟重新載入,auto memory 也會;最近讀過或改過的檔案會重新讀回幾份;用過的 skill 本文會重新注入,但有上限。會不見的有三種:對話裡口頭交代的指令、skill 的描述清單、早期對話的細節。所以要撐過壓縮的東西,一律寫進檔案。
/clear:清空。 換到不相關的工作就清,官方說它不花任何成本,舊對話也還能用 /resume 找回來。官方給的判準很實用:同一件事糾正了兩次還是錯,就清掉重來,用更具體的 prompt 開始,因為 context 裡已經塞滿失敗的嘗試,繼續在上面修只會越修越偏。
/rewind:回到檢查點。 每次送出訊息都會建立檢查點,可以只還原對話、只還原程式碼,或兩者都還原,也可以從某一則訊息開始摘要。但它有幾個盲點:Bash 指令造成的檔案變更不會被追蹤,subagent 做的編輯也不會被還原,其他並行 session 的修改更不在範圍內。所以它是方便的後悔藥,不是版本控制,重要的變更還是要靠 git。
/autocompact:調壓縮門檻。 1M context 的模型預設在接近上限時才壓縮,視窗大不代表要用滿。context 越長,每一輪送出去的內容越多,延遲與成本都會上升,所以與其等它自動壓縮,不如在任務的斷點主動壓,或直接換 session。
1M context 本身沒有額外加價:官方說 1M 視窗用標準價格計費,超過 200K 的部分沒有溢價(Haiku 5.5 在超過 100K 的 prompt 會比較貴是例外)。在 Anthropic API 上,Sonnet 5.5、Fable 5.1、Haiku 5.5 與 Opus 4.7 以後的版本,都直接以 1M 視窗執行,不用再選 [1m] 變體。但「不加價」不等於「不花錢」:每一輪都會把整段對話送出去,context 長兩倍,每一輪就多送兩倍的內容。大視窗適合真的需要同時看很多東西的工作,例如一次對照很多份文件;拿它來拖延整理 context,只是把成本往後推。不想要 1M,設 CLAUDE_CODE_DISABLE_1M_CONTEXT=1 會改用 200K 的門檻壓縮。
還有一個小工具:做到一半想順手問一個跟目前工作有關的旁支問題,用 /btw。它只根據現有的 context 回答、不會動用工具,回答也不會進入對話歷史,不會打斷正在做的事。
這些動作都和 Day 23 講的快取有關。壓縮會讓對話層的快取失效,因為新的歷史已經跟舊的對不上;如果快取還熱,壓縮本身只要付一小部分的成本,但如果你離開超過快取的存活時間才壓,整段歷史要用未快取的價格重新處理一次。官方的建議是在任務之間的自然斷點才壓,不要在一件事做到一半時壓。
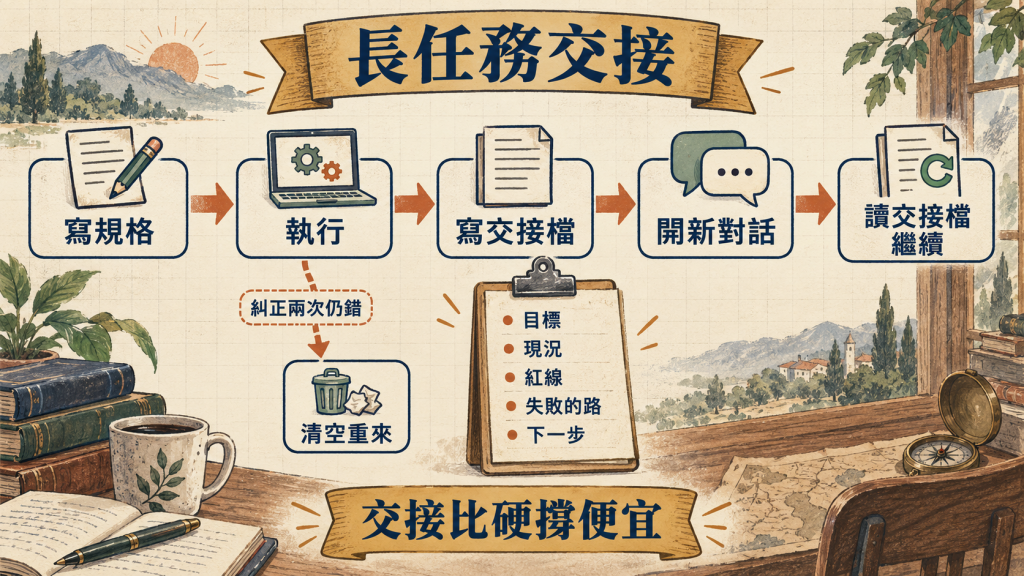
一件事要跨好幾個 session 時,與其一直壓縮硬撐,不如寫一份交接檔、開新 session。官方也有類似的建議:先讓它把規格問清楚寫下來,再開一個乾淨的 session 去執行,新 session 的 context 只放實作需要的東西,還有一份寫好的規格可以對照。
一份好用的交接檔,建議包含這幾段,示意如下:
# 交接:結帳流程重構

## 目標
把結帳拆成三個步驟,舊 API 保留到下個版本。

## 現況
步驟一、二完成並有測試;步驟三寫到一半,在 `checkout/confirm.ts`。

## 紅線
不能改資料庫 schema;所有金額計算要有單元測試。

## 做過、但失敗的路
用全域狀態管理步驟,測試互相污染,已放棄。

## 下一步
完成步驟三,補上整合測試,再請 fresh context 的 subagent 審查。
「做過但失敗的路」這一段最容易被省略,卻最有價值:沒有它,新 session 很可能重新踩一次同一個坑。交接時也值得順手檢查一次:這段工作裡有沒有值得長期保留的教訓,有的話寫回規則檔或記憶,交接檔只管這一次,教訓要放在下一次也讀得到的地方。
幾個 session 本身的工具也值得養成習慣。用 /rename 替 session 取名,把每一條工作線當成一個分支來管理,之後用 claude --resume <名稱> 直接回去;想保留原對話、另開一條試試別的方向,用 /branch。閒置超過約一小時、又超過十萬 token 的 session,在 Pro 與 Max 方案下 resume 時會詢問要不要從摘要接續;選摘要時第一次仍要處理完整歷史一次,之後每一輪才比較便宜。
對話紀錄本身存在 ~/.claude/projects/<專案>/<session-id>.jsonl,預設保留 30 天,由 cleanupPeriodDays 控制,最小 1 天。要留存某段對話,用 /export 匯出成純文字;要刪除某個專案的紀錄,用 claude purge,可以先加 --dry-run 看會刪什麼。這些紀錄的格式是內部格式,版本之間會變,不適合拿來寫依賴它結構的工具。
內建的 auto memory 只記「它判斷值得記」的東西,而且要它自己決定寫入。我另外裝了一個第三方的跨 session 記憶外掛,它用 hook 在每次 session 開始時,把近期的工作摘要注入 context,也提供搜尋過去紀錄的工具。好處是新 session 一開始就知道最近在忙什麼,不用我重講一次。
用這類外掛要記得兩件事。第一,它注入的摘要是模型自動產生的,可能有錯,適合當線索,真的要引用某件事,應該回到原始的對話或檔案去確認。第二,它每次開場都注入一段內容,本身就在佔 context,注入的量要節制。外掛記的是「發生過什麼」,規則檔與記憶檔記的是「以後要怎麼做」,兩者不能互相取代。
Day 18 講過 subagent 的 context 是隔離的。跟記憶有關的重點是:它會載入 CLAUDE.md 的各個層級,但內建的 Explore 與 Plan 會跳過;主對話的 auto memory 不會帶進去。所以真的要它遵守的規則,要在派工的 prompt 裡再講一次。
fork 是例外:它會繼承主對話的完整歷史與 system prompt,適合需要前面脈絡的旁支任務;它在過程中的工具呼叫不會回到主對話,主對話的 context 一樣保持乾淨。
想讓某個 subagent 有自己的長期記憶,可以在定義檔加 memory 欄位,值是 user、project 或 local,分別對應跨專案、可進版控的專案層、不進版控的本機層,它會在自己的記憶目錄維護一份 MEMORY.md。反過來,想讓某個 subagent 完全不受 CLAUDE.md 影響,例如一個只負責格式轉換的 agent,就設 omitClaudeMd: true,管理員層的政策檔仍然會載入。
paths 限定。/clear 重來。/rewind 不追蹤 Bash 與 subagent 的修改,重要變更靠 git。記憶與 context 管的是同一件事:讓對的資訊在對的時間出現。放太多,每一輪都在付錢;放太少,它就只能重新猜,而猜錯的代價通常更高。


 iThome鐵人賽
 看影片追技術