
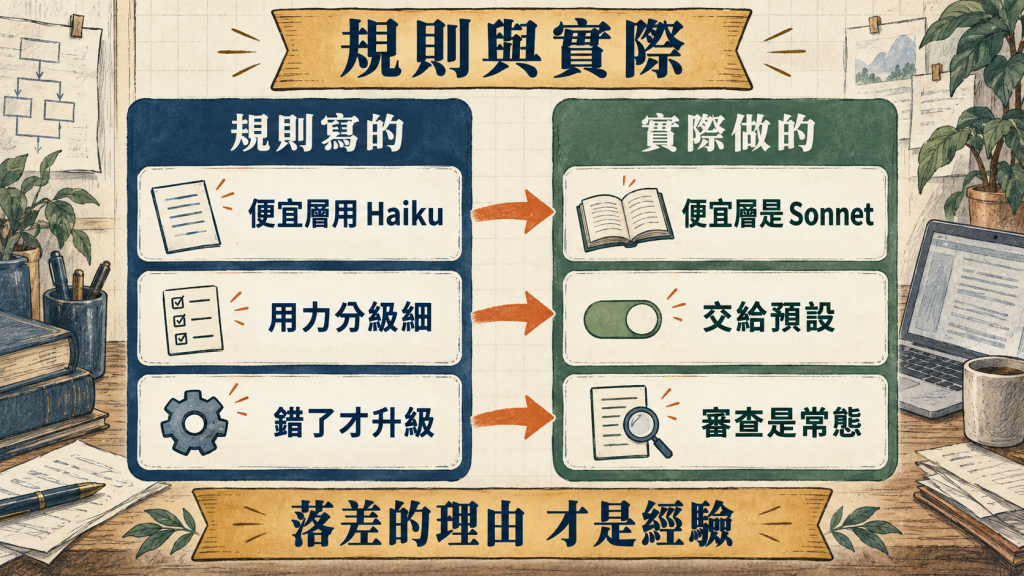
我替自己訂過一張很漂亮的模型分層表:機械性工作用 Haiku,標準產出用 Sonnet,判斷、審查與驗證用最強的模型,用力程度寫進派工的 prompt。這張表我用了兩個半月,回頭看這段時間的派工,實際的做法跟表上寫的不太一樣。今天講的就是這個落差,以及落差背後真正在運作的邏輯。
大部分的派工我交給 Sonnet,其次是 Opus,Haiku 幾乎沒用到。審查與驗證大多交給 Opus,搜尋與盤點則是 Sonnet。subagent 自己再往下派也很常見,Day 18 講的巢狀派工,我其實天天在用。
主對話的模型則大致跟著新模型上線走:一開始用 Sonnet,後來轉向 Opus,Fable 出來之後,需要規劃與決策的 session 改用它,5.5 系上線後又換到新版本。日常開發則常在 Opus 與 Sonnet 之間切換。
effort 我很少主動去調,大部分時候就是模型預設。有趣的是,升級模型這件事,等於悄悄替我把大部分工作的 effort 從 high 降成了 medium,因為 5 系預設是 high,5.5 系預設是 medium。
把這幾點跟規則表擺在一起,落差很清楚:表上的便宜層是 Haiku,實際是 Sonnet;表上寫了細緻的用力程度分級,實際上交給預設;表上的升級是「錯了才升」,實際上審查本來就是流程的一部分。後面幾節就是在講這些落差為什麼合理,以及哪些地方其實該照規則改回來。
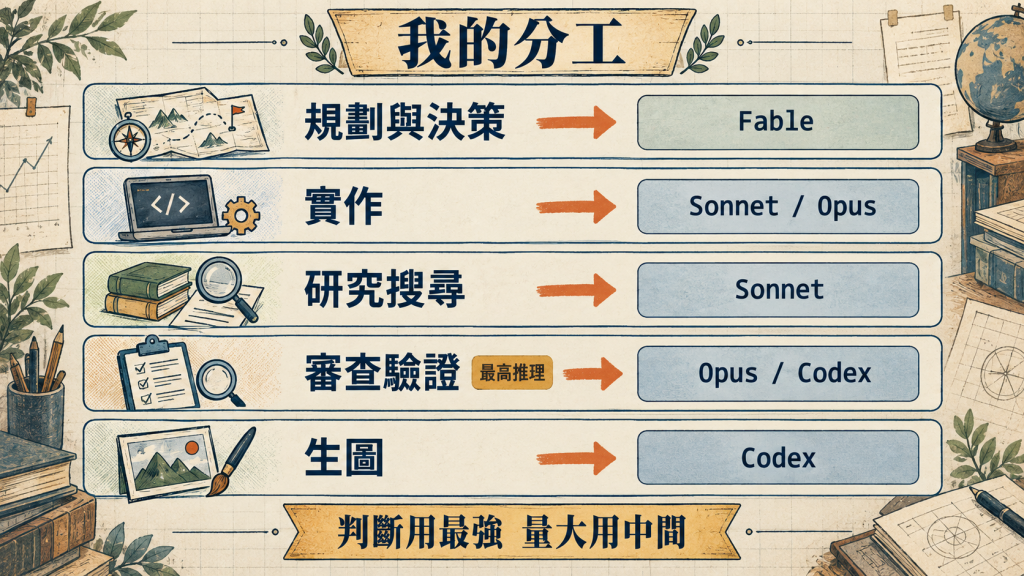
我的分工是按「工作性質」分,不是按「任務難度」分。下表是我在指令裡會特別指定的模型,沒特別指定的大量日常工作,多半交給 Sonnet。
| 工作 | 我會指定的模型 | 我下過的指令 |
|---|---|---|
| 規劃、架構、技術主導 | 最強的 Fable | 「plan 階段呼叫 Fable 當 Tech Lead」 |
| 夜間無人值守的決策 | Fable,但限制權限 | 「不要中途問我,可以派 Fable 做決定」 |
| 開發實作 | Sonnet 或 Opus;額度緊時交給 Codex | 「implement 為了省額度可以呼叫 Codex」 |
| 研究與搜尋 | Sonnet 的 agent team | 「派 Sonnet agent team 做研究跟搜尋」 |
| 審查與對抗驗證 | Opus,需要第二意見時換到 Codex 用最高推理力 | 「Codex 用 max 做 review 與對抗式驗證」 |
| 長篇寫作 | 先用 Fable,額度用完換 Opus 接手 | 「Fable 快用完了,用完就用 Opus 接手,也要照著做」 |
| 生圖 | Codex,推理力用 medium | 「架構圖用 Codex medium 來做」 |
有幾條原則藏在這張表裡。
判斷用最強的,量大的用中間的。 規劃與決策是整條鏈的上游,錯了後面全部白做,所以給最強的模型;研究與搜尋量大、可以並行,交給 Sonnet 開一隊人去跑。我曾經直接講過一句很實際的理由:派 Opus subagent 去做,比較不會燒到 Fable,Fable 比較貴。
驗證要換一個腦袋。 產出與審查用同一個模型,它會沿著同一套假設檢查自己,抓不到自己的盲點。所以審查我至少換一個 fresh context 的 subagent,需要第二意見時連引擎都換,讓 Codex 用最高推理力挑錯。我用過的一條鏈是:Opus 的 agent team 產出、Codex 做對抗驗證、最後由主對話的 Fable 收斂修正。三個角色、兩個引擎,每一段都用最適合那一段的模型,而不是讓一個模型從頭做到尾。
最強的模型也拿來當代理決策者。 夜間我不在的時候,原本該問我的決策,我授權給 Fable,而不是授權給便宜的模型,並且明講可以先做一版、之後再改。有一晚我同時把它的權限收得很緊:唯讀、只產出一份決策文件、規則不明確的一律走保守,並標明全部是暫定決策。決策權可以交給強模型,破壞力要用權限收住。
長篇寫作重的是一致,不是單篇的巔峰。 連續好幾天的長篇寫作,額度一定會在中途用完,所以我事先講好換手規則:強模型用完就由下一級接手,而且要照著原本的做法繼續。換手越平順,讀者越看不出差別。
生圖不需要高推理。 我用 Codex 的時候,大部分是在生圖,這時推理力指定 medium,把高推理留給審查。
主對話的模型,我的選法跟官方的建議很接近。官方的說法是大部分工作從 Opus 5.5 開始,遇到要求很高的推理、長時間的 agent 工作,或 Opus 在較高 effort 下仍然不夠時,才換 Fable 5.1。我實際是這樣分:要拆解問題、做架構決策、或要它整晚自己跑的 session,主對話用 Fable;一般開發用 Opus;文字與研究整理量大的 session,用 Sonnet 也夠。官方對 Fable 的使用提醒也值得照做:描述你要的結果,不要描述步驟;把模糊的問題交給它;不必再提醒它驗證;任務切大塊一點。另外有一個 opusplan 別名,plan mode 用 Opus、執行時自動切到 Sonnet,適合想要「想清楚再動手」又想省錢的人。
subagent 的模型則有明確的優先序,由高到低是:派工時帶的 model 參數、定義檔的 model、環境變數 CLAUDE_CODE_SUBAGENT_MODEL、最後才是主對話的模型。這裡有兩個坑。第一,2.1.251 之前,環境變數的順序在最前面,會蓋過派工參數與定義檔;升級前後行為不同。第二,沒指定模型的 subagent 會繼承主對話,所以當你在主對話用 /model 切到 Fable,所有繼承的 subagent 也一起變成 Fable(內建的 Explore 與 Plan 另有規則),額度消耗會突然暴增。我的做法是派工時一律顯式指定模型,很少讓它繼承。想強制所有 subagent 用同一個模型,就再設 CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1,這時定義檔與派工參數都會被忽略。
把分工落實成設定,常駐 agent 的 frontmatter 可以這樣寫:
---
name: reviewer
description: 以 fresh context 對抗式審查,只讀不寫,逐條附出處。
model: opus
effort: high
tools: Read, Grep, Glob
---
---
name: searcher
description: 在 repo 裡找出指定的東西,只回檔案與行號,不做判斷。
model: sonnet
effort: low
tools: Read, Grep, Glob
experimental:
  cacheTtl: 1h
---
審查者用強模型加 high,因為它的價值就在多驗一點、多找一個邊界;搜尋者用 Sonnet 加 low,要的是快與準,不需要它自己發揮。
臨時派工時,模型只是其中一個欄位。我的派工 prompt 固定有三塊:目標與動機、驗收條件、回報格式,再加上明確的模型與一句用力程度的描述:
目標:找出專案裡設定時區的地方,我接下來要把顯示改成 UTC+8。找到就好,不要改。
驗收:每個位置附檔案與行號,並用一句話說它在做什麼;找不到就說找不到。
回報:結論、關鍵位置、待決事項,不要貼整個檔案。
「找到就好,不要改」與「逐一驗證、挑毛病」這兩種句子,對結果的影響不比換模型小。模型決定它有多少能力,這幾句決定它把能力花在哪裡。
Haiku 幾乎不用。 表上寫搜尋與盤點交給 Haiku,實際上幾乎沒用。我的判斷是:搜尋的結果是後面所有判斷的地基,盤點漏了一個檔、找錯一個位置,後面的審查與實作都建在錯的資料上,這個代價比省下的錢大得多。而且從官方定價看,Haiku 4.5 的輸出價格是 Sonnet 5.5 的一半,差距沒有大到值得承擔這個風險;Haiku 4.5 也不支援 effort,少了一個可以調的旋鈕。所以我實際的「便宜層」是 Sonnet,不是 Haiku。官方成本文件的建議是簡單的 subagent 任務可以指定 Haiku,這個方向沒錯,適用的是結果不會被拿去當判斷依據的工作,例如格式轉換、把一份清單整理成表格;只要結果會流到下游的決策,我就寧可多付一點。
降級真正發生在額度層,不在任務層。 我很少因為「這件事簡單」就換便宜模型,但很常因為「額度快用完」而調度:Fable 用完就讓 Opus 接手,實作外包給 Codex。關鍵是換手時品質靠什麼守住。我的答案是同一組機檢:不管哪個模型產出,都過同樣的字數、紅線與格式檢查。品質綁在檢查上,不綁在模型上,換模型才不會怕。
跨引擎也是同一個邏輯。把審查交給 Codex,除了額度,更重要的是它是不同的模型家族,盲點跟 Claude 不重疊。我替它設推理力時是反過來的:審查用 max 或 xhigh,生圖用 medium。也就是說,同一個引擎裡,用力程度依任務的「錯了有多貴」來分,而不是依「任務有多難」。
「先 Sonnet 再 Opus」不是失敗後升級。 同一件事先派 Sonnet、再派 Opus,多半是固定流程:Sonnet 先產出,Opus 再稽核。審查本來就是常態流程的一部分,不必等錯了才升級。
真的需要升級的時候,我的規則有三條。第一,升級要帶著失敗軌跡:前一次的 prompt、它回了什麼、為什麼判定錯,一起交給更強的模型,不然它只會重踩一次同樣的坑。第二,先問失敗的原因是不是 prompt 沒講清楚,目標、驗收與格式缺一塊時,換再強的模型也猜不到你要什麼,該修的是派工,不是模型。第三,升到最強的模型連錯兩輪就停下來,不再重試,回頭檢查方向是不是錯了,或直接去問人。重試是同一個方法再做一次,換模型或換方法才是新的嘗試,兩者要分清楚。
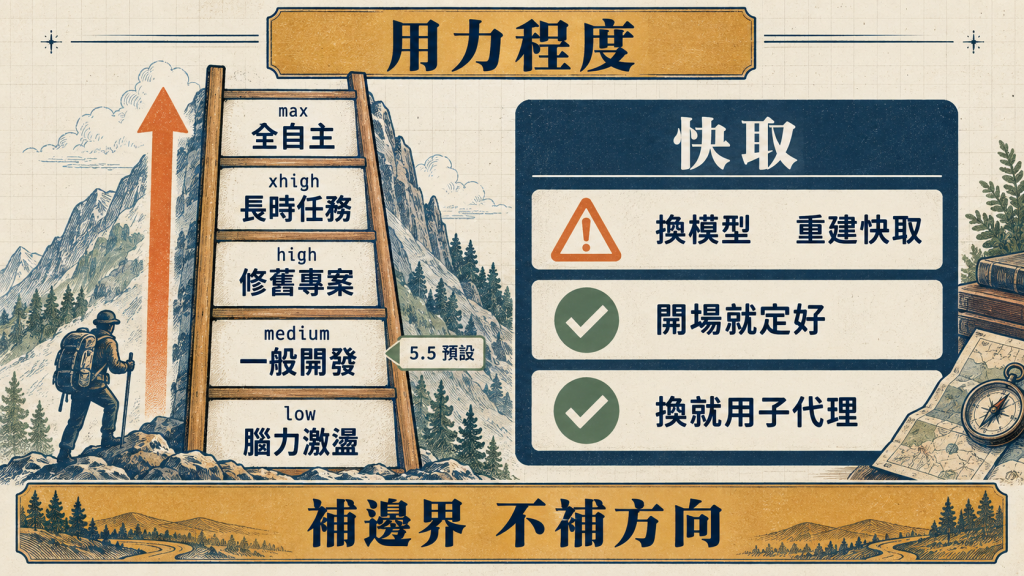
effort 有 low、medium、high、xhigh、max 五級。官方的定義是它影響回應中所有 token,包括文字、工具呼叫與思考,而且它是行為訊號,不是嚴格的 token 預算。在 Claude Code 裡,支援 effort 的模型預設是 high,但 Opus 5.5 與 Sonnet 5.5 預設是 medium。官方的說法是 Opus 5.5 在 medium 的表現,已經達到或超過 Opus 5 在 high 的水準;同一個等級名稱,在不同模型上代表的不是同一個值。
我很少主動調 effort,這不全是壞事:預設本身就是官方校準過的起點。但官方部落格 Spending your effort 給了一個我很認同的用法:
| 等級 | 適合的工作 |
|---|---|
| low | 需要快速回應的來回:腦力激盪、草擬、簡單修改 |
| medium | 大部分的一般開發,例如實作新功能 |
| high | 驗證很重要、有邊界情況的工作,例如修舊專案的 bug |
| max | 讓它完全自主解決難題,例如從頭建一個 app 並驗證 |
作者自己的日常流程是:先讓模型訪談他、補齊規格,用 low 實作,人看一遍方向對不對,最後用 high 做驗證與測試。這跟我的「產出與驗證分開」是同一個結構,只是他用 effort 切,我用模型切。
文中有一個我覺得最重要的提醒:提高 effort 會減少「漏掉邊界情況」的失敗,但修不好「方向錯了」的失敗。方向錯是規格與判斷的問題,不是多想一點就能救。這也是為什麼我把最強的模型放在規劃,而不是在實作時把 effort 開到最大。
同一篇文章裡有一個很直觀的例子:用 Opus 5.5 做同一個健身 app,low 花 1.5 分鐘,medium 4 分鐘,high 11 分鐘,max 67 分鐘;low 的成品只是一個紀錄表加一張簡單圖表。把規格寫得很清楚之後,每一級都花得更久,但各等級的結果變得接近得多。另一組是 Fable 5.1 在 Terminal-Bench 3.0 的分類結果:effort 拉高時,資安與硬體這類驗證多的領域進步最多,維運這種照規則手冊做的工作幾乎沒什麼變化。這些是官方的內部測試,但方向很清楚:effort 最值錢的地方,是驗證與邊界多的領域,而規格越清楚,各等級之間的差距越小。另一個副作用也要知道:effort 越高,模型會替你做越多假設,規格模糊時,它會往你沒想到的方向做完。
設定的方式有幾種,優先序由高到低:環境變數 CLAUDE_CODE_EFFORT_LEVEL、啟動時的 --effort 或對話中的 /effort、settings 的 effortLevel 或每個模型的 modelSettings,最後才是模型預設。subagent 與 skill 的 frontmatter 也能寫 effort,在它執行時覆蓋 session 的設定。只想讓某一回合多想一點,在 prompt 裡寫 ultrathink 就好,不會改動 session 的設定。幾個細節:max 除非用環境變數設定,否則只在當前 session 有效,settings 的兩個鍵都不接受 max;/effort auto 會清除該模型已存的等級;Haiku 4.5 不支援 effort,設了也沒作用。
如果要從現況往前一步,我最想做的是把 effort 寫進常駐 agent 的定義:審查類的 agent 設 high,搜尋類的設 low,而不是全部吃預設。我現在的常駐 agent 都還沒設 effort。同樣的道理也適用於 skill:做 code review 或安全檢查的 skill 適合把 effort 寫成 high,產生樣板、改格式這類照表操課的 skill 寫 low 就夠。skill 裡還能用 ${CLAUDE_EFFORT} 讀到當下的等級,讓同一份指引在不同等級下給出不同深度的要求。
官方另一篇 Prompt caching is everything 講的是一件常被忽略的事:快取是前綴比對,前綴任何一處改變,後面全部失效。這直接影響模型怎麼切:
experimental 底下設 cacheTtl: 1h,但用 usage credits 時 1h 會被忽略。官方的一句話建議是:在 session 開頭選好模型與 effort,把 /compact 留給任務之間的自然斷點,中途改動越少,快取命中越高。這也改變了我對 /model 的看法:在對話中途切模型,每一次都是重建整段快取;與其中途切,不如開一個新 session,或把那一段工作交給指定了模型的 subagent。順帶一提,對話中途編輯 CLAUDE.md 不會打壞快取,但也不會生效,要等 /clear、/compact 或重開。
價格上,以每百萬 token 的輸出計,Fable 5.1、Opus 5.5、Sonnet 5.5、Haiku 4.5 是 50、20、10、5 美元,比例約 10 比 4 比 2 比 1。快取讀取在 Fable 5.1 只要基本輸入價的 0.025 倍,Opus 5.5 是 0.05 倍,其餘模型是 0.1 倍。所以對越貴的模型,快取打壞的代價越大。
fast mode 不是另一個模型,是 Opus 的高速設定,官方說最多快 2.5 倍,單價也較高,Opus 5.5 是每百萬 token 輸入 8 美元、輸出 40 美元,是標準價的兩倍,Sonnet 與 Haiku 不支援。它適合現場除錯、快速來回迭代這種「等待很貴」的時候,成本比延遲重要時就關掉。因為它是快取 key 的一部分,要在 session 一開始就決定。
觀測成本,我看三個地方。/usage(/cost 是它的別名)列出這個 session 每個模型的輸入、輸出、快取讀寫與估算金額,訂閱方案的金額只是參考。status line 的 JSON 有 cost.total_cost_usd 與 prompt_cache,可以把快取命中率放在眼前。用 -p 或 SDK 時,要看 modelUsage 而不是 usage:usage 只算最上層的 agent 迴圈,一旦有 subagent 就會低估,modelUsage 才是整棵樹、並按模型拆開的數字。這些金額都是客戶端估算,不是帳單。作為參考,官方給的企業部署平均是每位開發者每個活躍日約 13 美元、每月 150 到 250 美元,九成使用者每個活躍日低於 30 美元。
規則表寫的是我希望自己怎麼做,紀錄寫的是我實際怎麼做。兩者有落差不奇怪,值得花時間的是弄清楚落差背後的理由。這次看下來,那些理由比規則本身更像是真正的經驗。


 iThome鐵人賽
 看影片追技術