
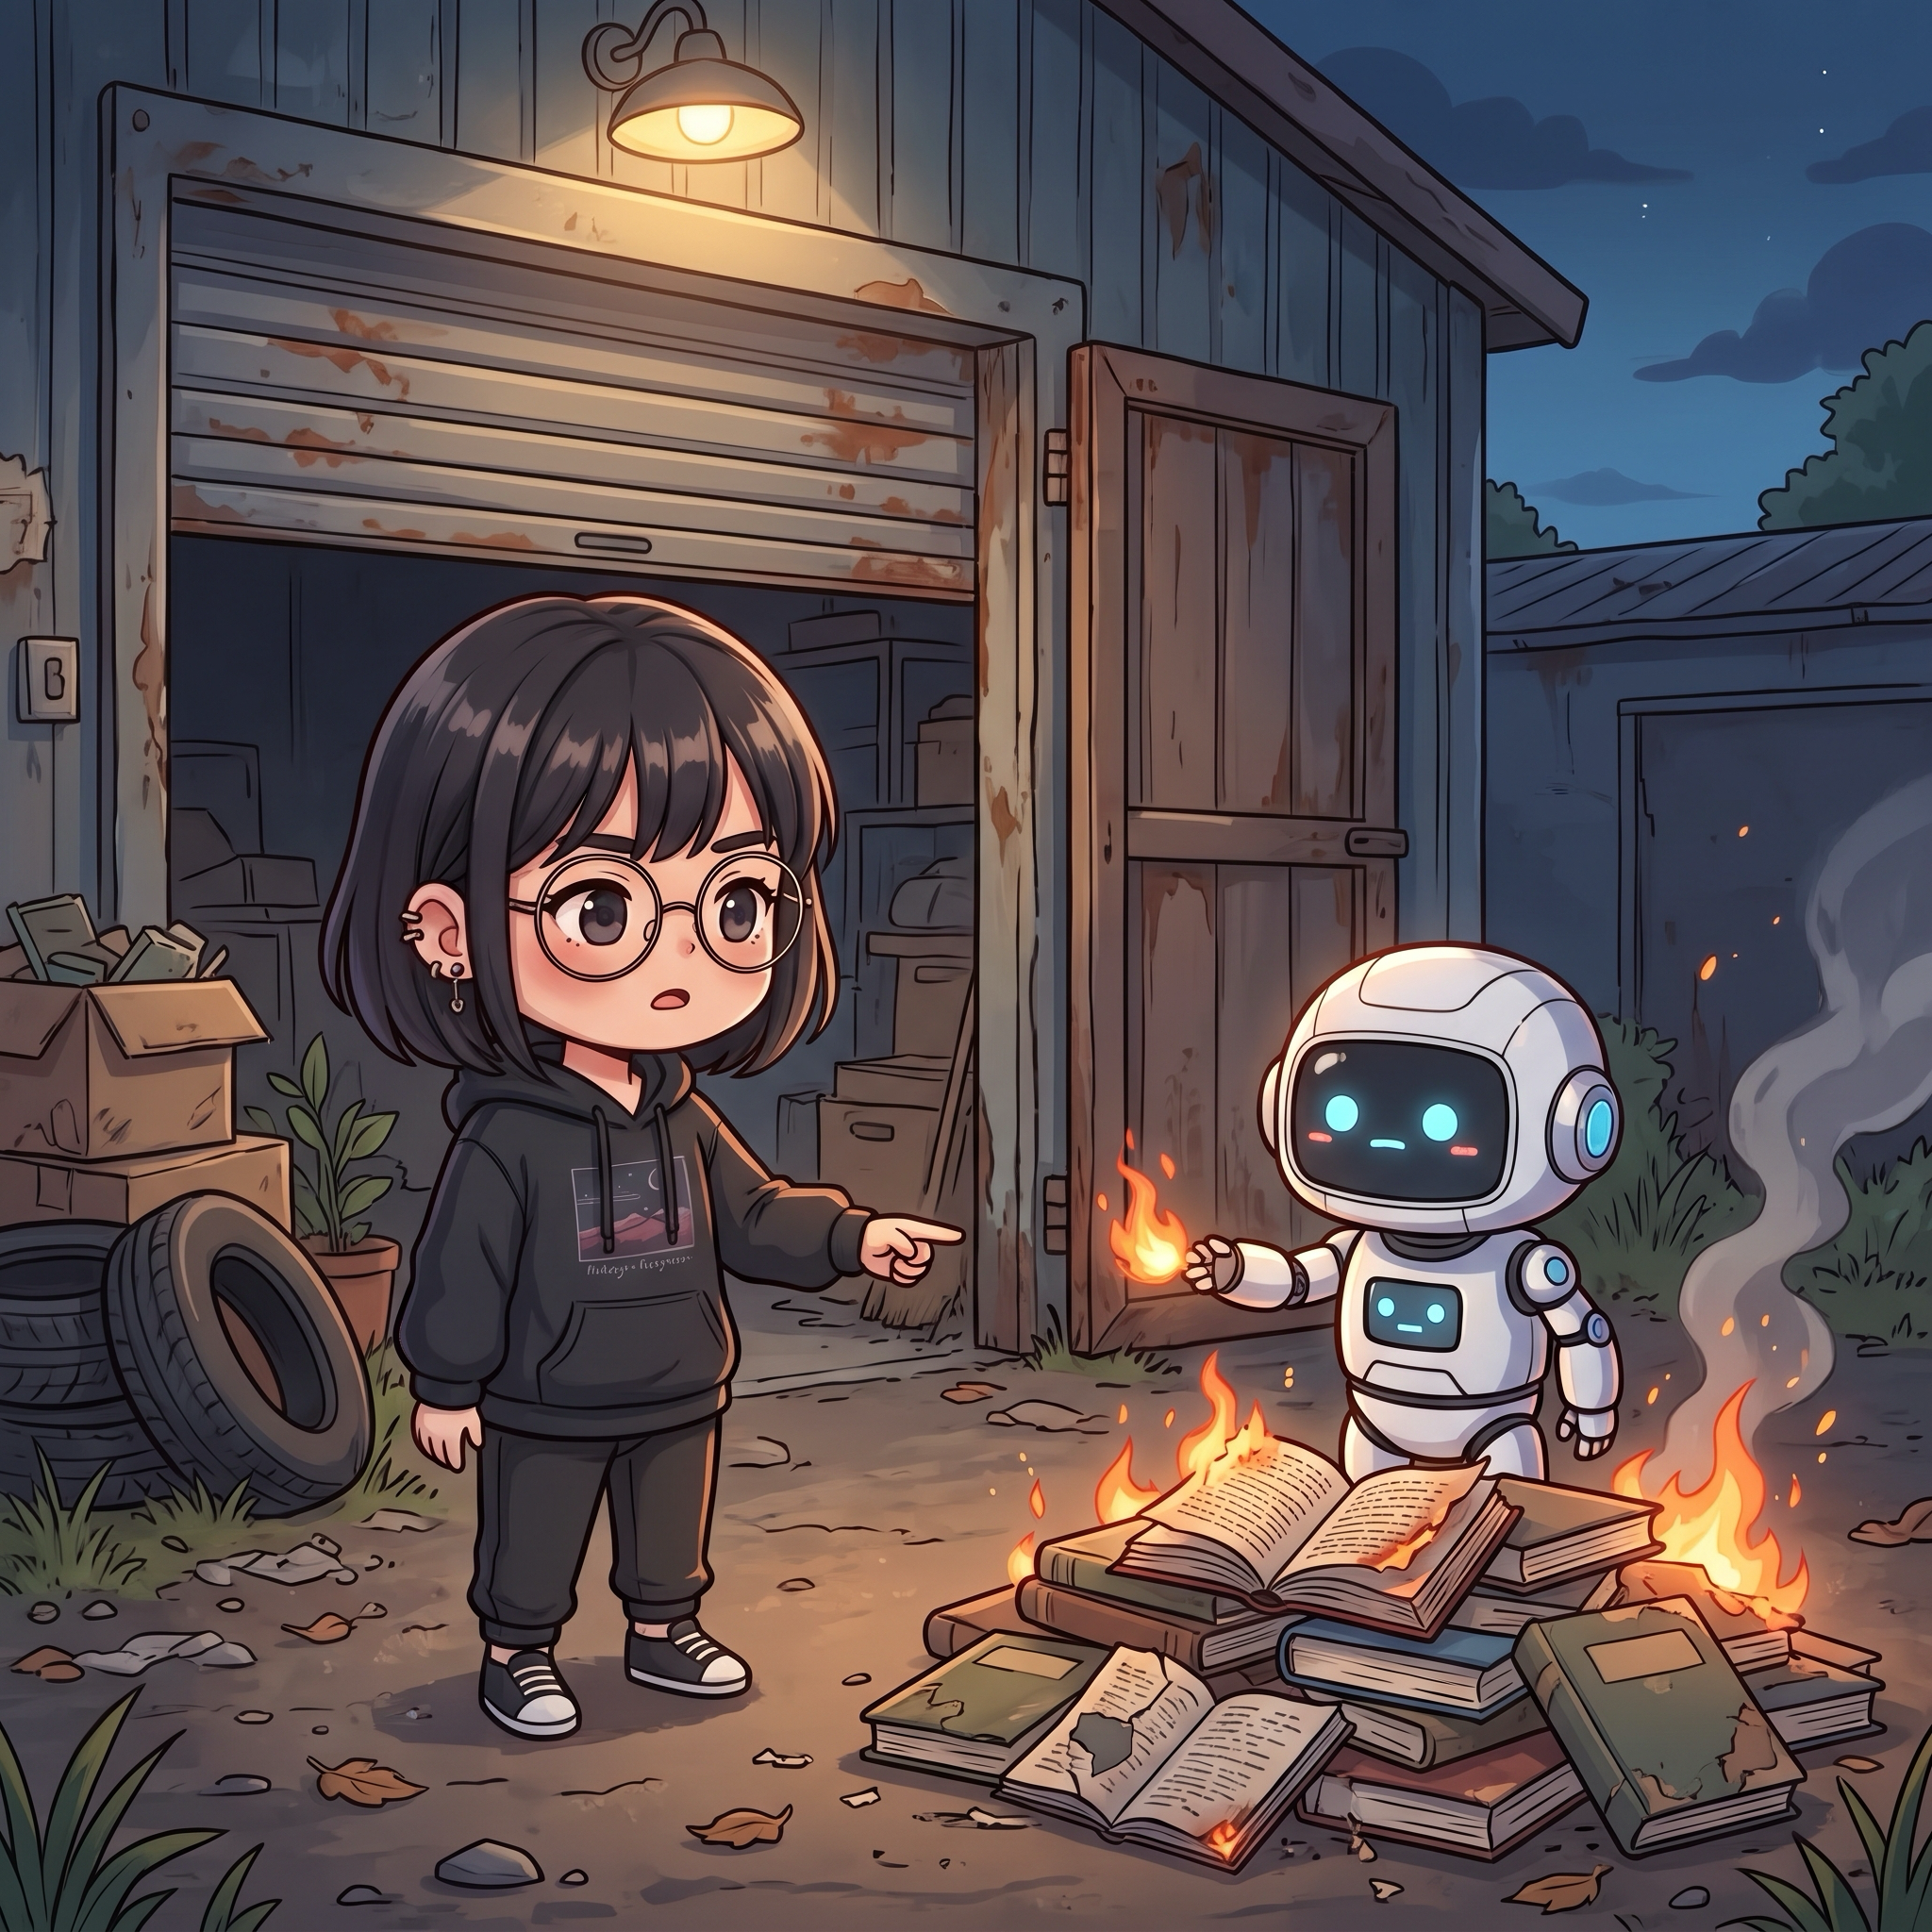
目前填寫材料時,命中部分關鍵字時會像 Google 搜尋那樣推薦資料庫已經有的材料:
因為也開放填寫自訂材料,所以酒譜慢慢變多起來,就會有些亂填的東西要清理!
自訂材料在目前的邏輯中會被設為 ingredientEntityId = null,所以要撈出來並不難。
不過洗資料這件事我也是頭一次做,目前可能的步驟是:
ingredientEntityId
來看看 Agent 的怎麼說:
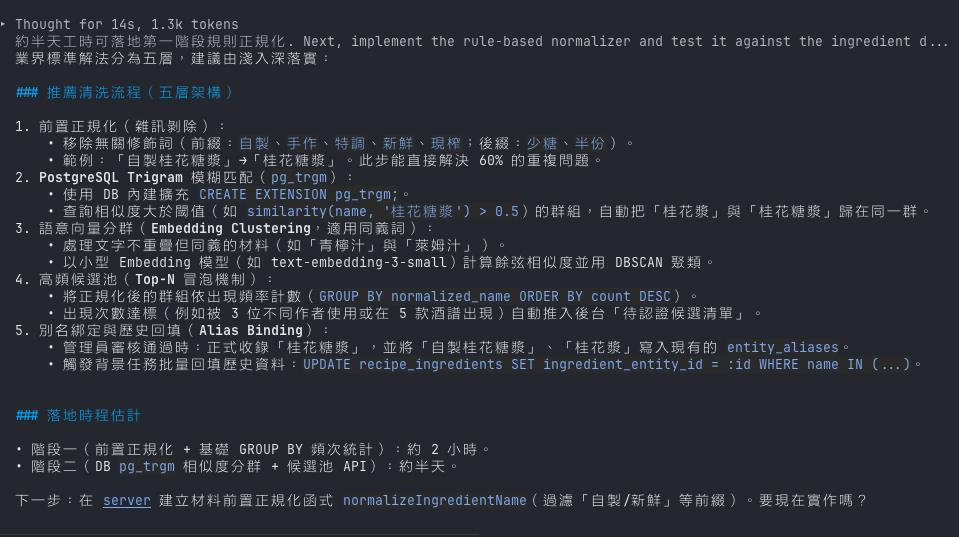
Agent 在描述一些我們不懂的知識並給予建議時,絕對不要照單全收,尤其是洗資料這種特別危險的操作,要把步驟拆解出來,所以這裡我再請 Agent 提供 SQL 時就發現了問題:
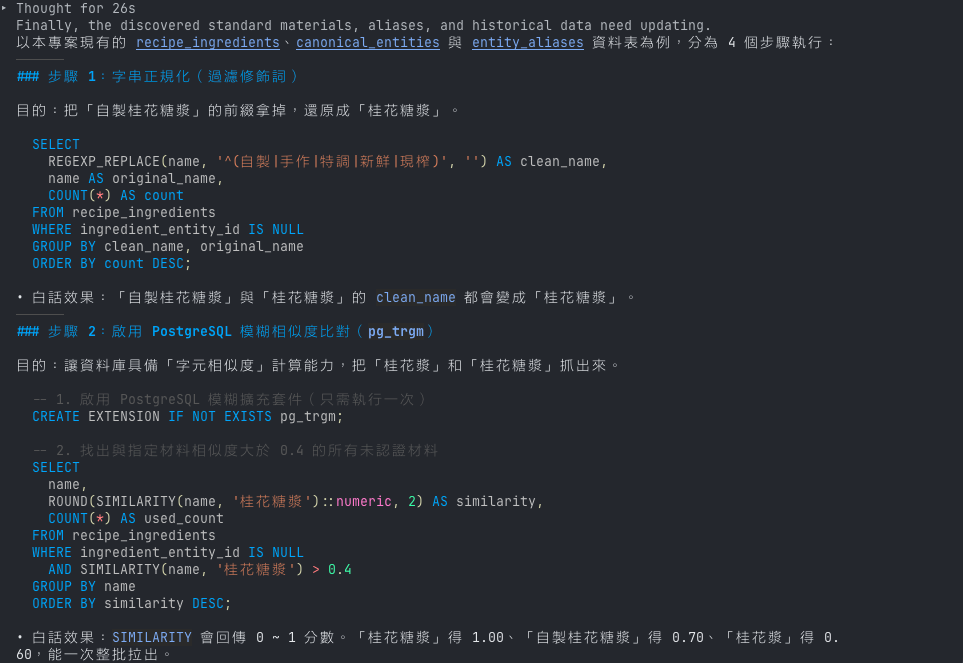
我個人認為是不需要做步驟 1 的 REGEXP_REPLACE,因為根本就沒有辦法窮舉使用者寫的前綴或是亂填的內容。
SELECT
  LOWER(TRIM(name)) AS normalized_name,
  COUNT(*) AS recipe_count,
  ROUND(COALESCE(AVG(abv::numeric), 0), 1) AS suggested_abv
FROM recipe_ingredients
WHERE ingredient_entity_id IS NULL
GROUP BY LOWER(TRIM(name))
ORDER BY recipe_count DESC;
輸出範例:
| 材料名稱 | 出現次數 | 建議預設ABV |
|---|---|---|
| 檸檬汁 | 25 | 0.0 |
| 桂花糖漿 | 10 | 0.0 |
| 新鮮檸檬汁 | 8 | 0.0 |
| 自製桂花糖漿 | 3 | 0.0 |
| 桂花漿 | 2 | 0.0 |
利用 word_similarity 把寫法相近的詞撈出來:
-- 1. 啟用 pg_trgm 擴充套件
CREATE EXTENSION IF NOT EXISTS pg_trgm;

-- 2. 兩兩比對相似度大於等於 0.50 之項目
WITH distinct_names AS (
  SELECT DISTINCT LOWER(TRIM(name)) AS name
  FROM recipe_ingredients
  WHERE ingredient_entity_id IS NULL
)
SELECT
  a.name AS term_a,
  b.name AS term_b,
  ROUND(GREATEST(word_similarity(a.name, b.name), word_similarity(b.name, a.name))::numeric, 2) AS similarity
FROM distinct_names a
JOIN distinct_names b
  ON a.name < b.name
 AND GREATEST(word_similarity(a.name, b.name), word_similarity(b.name, a.name)) >= 0.50
ORDER BY similarity DESC;
但 CTE 語法我也不太會,只能先相信 Agent 了 XDDD
如果可以串 LLM 的話這部分也許就可以自動化了,但我也沒把握,所以初期還是先自己抓吧 QQ
| 參數項 | 說明 | 範例值 |
|---|---|---|
entity_id |
材料唯一識別碼 | ing_osmanthus_syrup |
name_zh |
標準中文名稱 | 桂花糖漿 |
name_en |
標準英文名稱 | Osmanthus Syrup |
category |
材料分類(固定為 ingredient 或 base_spirit) |
ingredient |
default_abv |
標準酒精濃度 | 0.0 |
target_names |
需批次正規化為標準名稱之歷史字串 | {'桂花糖漿', '自製桂花糖漿', '桂花漿'} |
BEGIN;

-- 1. 寫入字典
INSERT INTO canonical_entities (id, name_zh, name_en, category, default_abv)
VALUES (
  'ing_osmanthus_syrup',
  '桂花糖漿',
  'Osmanthus Syrup',
  'ingredient',
  0.0
);

-- 2. 批次更新歷史酒譜:關聯實體 ID 並統一覆寫為標準中文名稱
UPDATE recipe_ingredients
SET
  name = '桂花糖漿',
  ingredient_entity_id = 'ing_osmanthus_syrup'
WHERE ingredient_entity_id IS NULL
  AND LOWER(TRIM(name)) IN (
    '桂花糖漿',
    '自製桂花糖漿',
    '桂花漿'
  );

COMMIT;
做到這裡其實我已經反覆跟 Agent 確認幾次這些 SQL 寫法和安全性了,像是一開始步驟 4 回填居然沒有下 transaction,雖然洗之前要備份是常識,但洗壞了還是會覺得心情很幹 XD
而且還發現 entity_aliases 這張沒什麼用的 table,既然都要洗資料了,那就不需要多一張 table 來存自訂材料,所以資料模型的改動真的要審核!
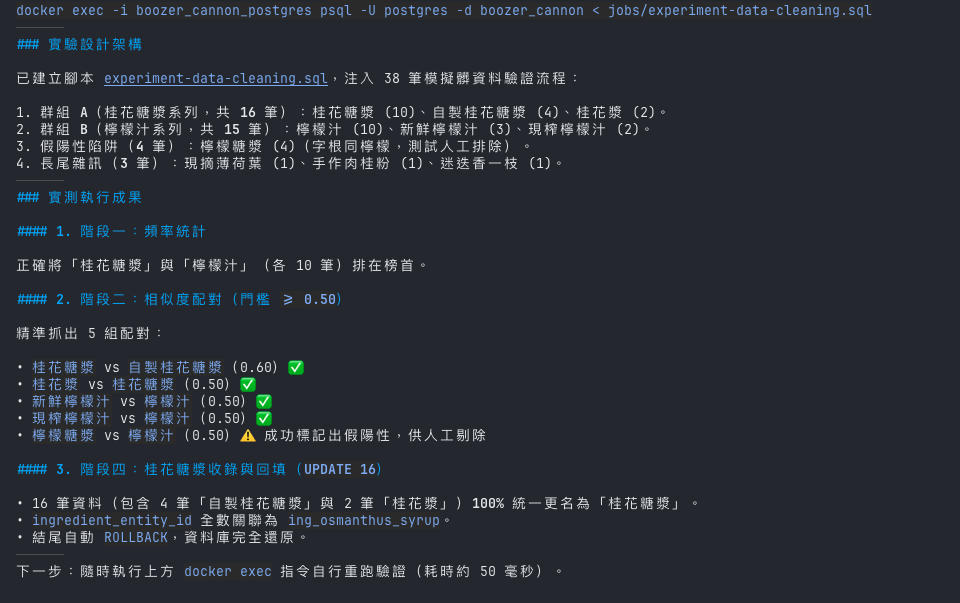
最後就讓 Agent 自己實驗洗資料的效果吧:
在清理孤兒資料、過期資料的時候,邏輯上已經被我們歸類為是無用資料,所以可以用 cron job 自動定期清理。
但資料清洗會需要一些人工的判斷,通常會 dump 一份在測試環境洗洗看,再跑前後端的測試,看看有沒有改壞,沒辦法直接用 cron job 跑,所以這時有沒有寫單元測試就很重要了!


 iThome鐵人賽
 看影片追技術