
本篇會簡略介紹 L-BFGS 的發展脈絡,接著用一個簡單的神經網路訓練任務,實際比較 SGD、AdamW 與 L-BFGS 三種優化器的差異。
現在的神經網路訓練,主要是基於梯度下降法(Gradient Descent)作為優化器進行訓練。梯度(gradient)就是根據損失(loss)算出的一階導數,它可以告訴我們:現在往哪個方向走,可以讓 loss 下降最快
不過單純看 gradient,可能會讓我們在陡峭方向上走得太大,在平坦方向上又走得太慢。所以我們想到了,如果也算出具有「曲率」意義的二階導數,那就可以再增加梯度更新的效率

BFGS & L-BFGS: The Algorithms...
原本的梯度下降法 θ ← θ - η∇L
而牛頓法會使用二階導數作為自適應學習率,也就是說前面陡峭就走慢一點、前面平就走快一點θ ← θ - H⁻¹∇L
關鍵就是這個 H,要算出二階導數矩陣,又稱為 Hessian Matrix
這就引出一個問題了,Hessian Matrix 會是一個 N × N 的矩陣,因為二階導數還會考慮到每個維度的交互作用,所以當參數量 N 為一百萬個的時候,我們就需要一兆個元素的空間來存算 Hessian Matrix
BFGS 根據四位貢獻者 Broyden–Fletcher–Goldfarb–Shanno 命名
核心想法就是,我們直接「用兩個一階梯度去估計二階導數」,也就是用現在算的 gradient g_now 減去前一次的 gradient g_prev
H ~ (g_now - g_prev) / (θ_now - θ_prev)
這樣就大幅減輕計算負擔!而更進一步,L-BFGS 就是不會把 H 存下來,而是在需要時才計算更新方向
這邊只是概念性講解,公式有大幅被簡化過
使用 PyTorch,用 Sin 函數擬合的任務來比較 SGD、AdamW(目前 LLM 常見的優化器)與 L-BFGS
先看三個優化器的訓練損失,可以明顯看到 L-BFGS 下降得非常快,接著是 AdamW,最後是 SGD。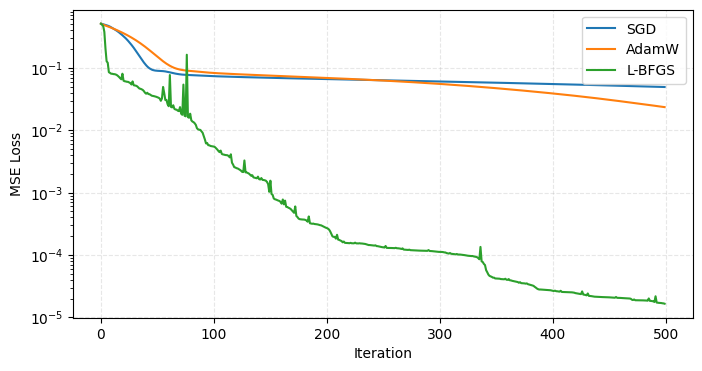
我們在直接看最後擬合的結果,L-BFGS 基本上是可以說完美擬合,再來是 AdamW,然後是 SGD。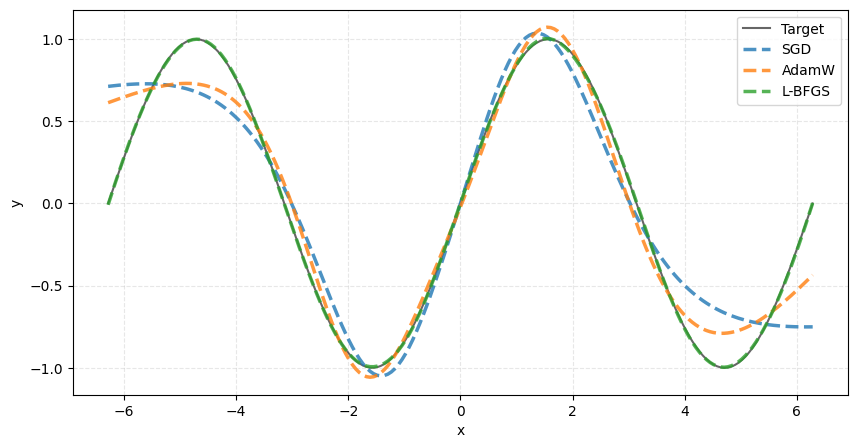
不過我們再看看訓練的時間效能。跑完一樣的 step,L-BFGS 可以說是其他兩個的 6 倍左右。
但其實仔細評估一下,如果把時間限制在 0.5 秒左右,可以看到 L-BFGS 還是有比較好的效果。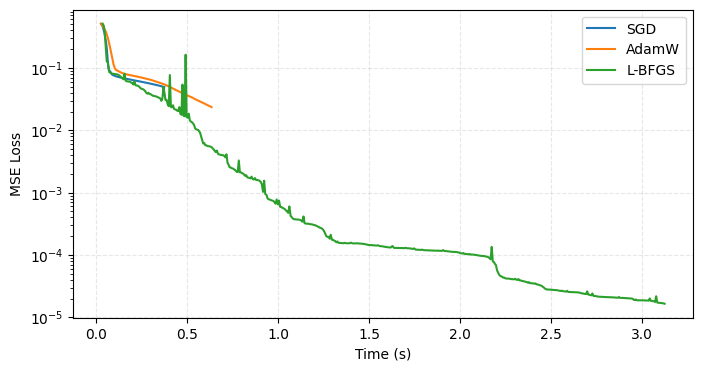
這個算法有一個很大的限制:基本上需要一次使用全部的資料來計算 gradient
這也代表當資料量變大時,每一次更新的計算成本都會變得很高
相較之下,SGD、AdamW 可以使用 Mini-batch,只使用一小部分資料就能更新模型,因此更適合大型神經網路的訓練

 Keyboy

 iThome鐵人賽
 看影片追技術