
昨天的大 Key、熱 Key,都是出事了才去找。其實 Redis 自己就記著很多數字:用了多少記憶體、快取有沒有命中、連了幾條連線,下 INFO 就看得到。
INFO 一次會印出兩百多行,分成 # Server、# Memory、# Stats 等 11 段,後面加段落名稱就只看那一段,前面用過的 INFO stats、INFO persistence 就是這樣。今天只挑平常要盯的幾個。
INFO stats 裡的 keyspace_hits 是讀 key 有讀到的次數,keyspace_misses 是沒讀到的次數。有讀到的佔幾成,就是命中率:
命中率 = keyspace_hits ÷ (keyspace_hits + keyspace_misses)
重新啟動 Java,先把累計的數字歸零,再跑一次 Day 22 的擊穿(在主機的終端機下):
docker exec redis30days redis-cli CONFIG RESETSTAT

docker exec redis30days redis-cli DEL product:1

./k6/run.sh breakdown

docker exec redis30days redis-cli INFO stats | grep keyspace
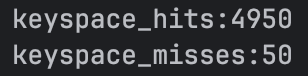
快取剛好過期那一下的 50 次沒讀到,其他 4950 次都有讀到,命中率是 4950 ÷ 5000 = 99%。
接著跑 Day 21 的穿透(在主機的終端機下):
./k6/run.sh penetration

docker exec redis30days redis-cli INFO stats | grep keyspace
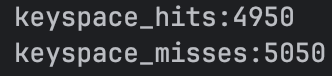
穿透的 5000 次全部沒讀到,命中率一下掉到 4950 ÷ 10000 = 49.5%。平常很穩的命中率突然掉下來,就是有人一直在查快取裡沒有的東西,或是一大批 key 同時過期。
這兩個數字是整台 Redis 一起算的,不只快取,像扣庫存的 Lua 裡那個 GET 也算在裡面。
跑完上面共 1 萬次,看一下現在連了幾條(在主機的終端機下):
docker exec redis30days redis-cli INFO clients | grep connected_clients
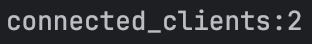
只有 2 條:一條是 Java,一條是正在下指令的 redis-cli。50 個人同時打,Java 跟 Redis 之間還是只有一條連線,因為 Spring 用的 Lettuce 預設大家共用同一條,Redis 回得夠快,一條就夠用。
例外是 MULTI 跟 Pipeline,它們的指令要連在一起送,不能跟別人的混在一起,所以要自己一條連線。沒有連線池的話,每次都是新開一條、用完就關掉。
用 Day 19 的 /transfer 轉帳 100 次,看累計連進來幾條(total_connections_received,在主機的終端機下):
docker exec redis30days redis-cli MSET balance:A 100 balance:B 50

docker exec redis30days redis-cli CONFIG RESETSTAT

for i in $(seq 1 100); do curl -s -o /dev/null -X POST "localhost:8080/transfer?amount=1"; done

docker exec redis30days redis-cli INFO stats | grep total_connections_received
curl -s -o /dev/null 是不印出回傳的內容。

101 條:轉帳 100 次就新開了 100 條,另外 1 條是 redis-cli 自己。
pom.xml 加上連線池:
<!-- Day 28:連線池。Spring Boot 看到它就會自動開,版本也是 Spring Boot 管 -->
<dependency>
    <groupId>org.apache.commons</groupId>
    <artifactId>commons-pool2</artifactId>
</dependency>
重新啟動 Java,同樣四行再跑一次(在主機的終端機下):

剩 3 條:連線池裡的 1 條、Java 平常共用的那 1 條(Java 剛重開,這條也是重新連的),加上 redis-cli 自己。轉帳用完的連線會還回池子,下一次直接拿出來用。
連線池預設最多 8 條(spring.data.redis.lettuce.pool.max-active),都被拿走的時候,後面的人要排隊等。沒什麼在用 MULTI、Pipeline 的話,不加連線池也沒關係。
INFO memory 先看三個數字(在主機的終端機下):
docker exec redis30days redis-cli INFO memory | grep -E "used_memory_human|used_memory_rss_human|mem_fragmentation_ratio"
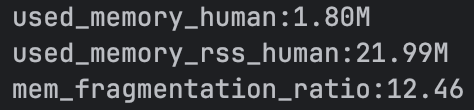
used_memory_human:資料用了多少,Redis 自己算的used_memory_rss_human:作業系統實際給了 Redis 多少mem_fragmentation_ratio:大約是 rss 除以 used_memoryratio 12.46 看起來很嚇人,其實是資料太少:rss 裡有一部分是 Redis 程式本身要用的,資料只有 1.8MB 的時候,比例就會很大。資料多起來,這個數字才準。
做 400 萬個 key 放在 db2,再隔一個刪一個,刪掉一半(在主機的終端機下):
# db2 塞 400 萬個 key:k:0 到 k:3999999
docker exec -i redis30days sh -c 'awk "BEGIN{for(i=0;i<4000000;i++) printf \"SET k:%d %d\r\n\", i, i}" | redis-cli -n 2 --pipe'

docker exec redis30days redis-cli INFO memory | grep -E "used_memory_human|used_memory_rss_human|mem_fragmentation_ratio"

# 隔一個刪一個:k:0、k:2、k:4⋯⋯
docker exec -i redis30days sh -c 'awk "BEGIN{for(i=0;i<4000000;i+=2) printf \"DEL k:%d\r\n\", i}" | redis-cli -n 2 --pipe'

docker exec redis30days redis-cli INFO memory | grep -E "used_memory_human|used_memory_rss_human|mem_fragmentation_ratio"
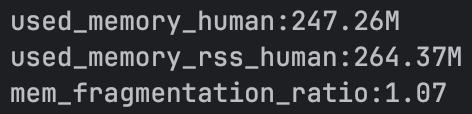
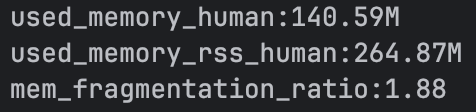
塞完是 1.07,資料多的時候兩邊差不多。刪掉一半之後,used_memory 從 247MB 降到 141MB,rss 沒有跟著降,還是 264MB 多,ratio 變成 1.88。
Redis 跟作業系統拿記憶體,是一整塊一整塊拿的。隔一個刪一個,每一塊裡都還有沒刪的 key,一塊都還不回去,空出來的位子散在每一塊裡,這就是記憶體碎片。這些空位之後寫進來的資料還用得到,只是在作業系統看來,Redis 還是佔著 264MB 多。
這些數字看不懂,也可以直接問 Redis(在主機的終端機下):
docker exec redis30days redis-cli MEMORY DOCTOR
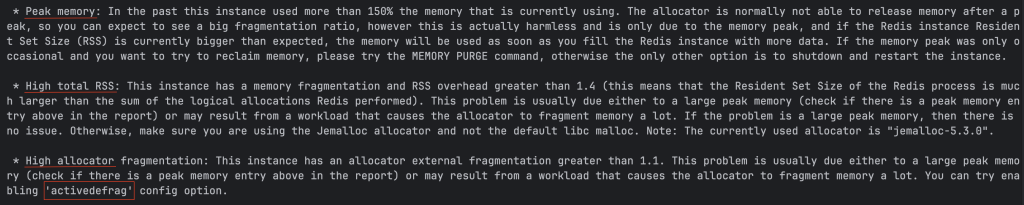
它列了三點:曾經用過的比現在多很多(Peak memory)、作業系統給的比實際用的多太多(High total RSS)、碎片太多(High allocator fragmentation),最後一點直接建議打開 activedefrag。
資料不到 5MB 的時候問它,只會回一段 Hi Sam, this instance is empty...,不會分析。
照它說的打開(在主機的終端機下):
docker exec redis30days redis-cli CONFIG SET activedefrag yes
等一分鐘左右再看一次(在主機的終端機下):
docker exec redis30days redis-cli INFO memory | grep -E "used_memory_human|used_memory_rss_human|mem_fragmentation_ratio"
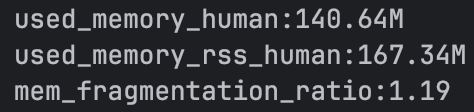
rss 從 264MB 多降到 167MB,ratio 降到 1.19。activedefrag 會在背景把還在用的 key 搬到一起,整塊空出來的才還得回去。
搬資料會吃 CPU,預設是關的。打開之後,也要碎片超過 100MB(active-defrag-ignore-bytes)才會開始搬。這也是為什麼要塞 400 萬個:200 萬個刪一半,碎片還不到 100MB。
測完還原,db2 也清掉(在主機的終端機下):
docker exec redis30days redis-cli CONFIG SET activedefrag no

docker exec redis30days redis-cli -n 2 FLUSHDB ASYNC
FLUSHDB 是清掉整個 db,ASYNC 跟昨天的 UNLINK 一樣丟給背景釋放。
keyspace_hits、total_connections_received 都是從啟動(或 CONFIG RESETSTAT)開始加,跑越久,突然掉下來的那一段越看不出來。像上面穿透的 5000 次一次都沒讀到,累加起來看還有 49.5%。正式環境通常會用 Prometheus 這類工具定時去抓 INFO,畫成圖、算每一段時間的命中率,掉下來就發通知。maxmemory 管不到碎片。 之前設的 maxmemory,比的是 used_memory,不是 rss。像上面刪完一半,used_memory 是 141MB,rss 還是 264MB 多。就算 maxmemory 設 200MB,Redis 也覺得還沒滿,但作業系統那邊已經給了它 264MB。所以機器的記憶體要比 maxmemory 多留一些。相關範例程式碼可以參考 https://github.com/gary880306/redis-30days/tree/dev
明天是最後一個技術題:如果用分散式鎖,Redis 自己出事的時候還靠得住嗎


 iThome鐵人賽
 看影片追技術