

上一篇我們實際做了一次 SQL Injection,也看到問題的核心:
使用者輸入的「資料」,被資料庫當成「語法」執行了。
今天就來看怎麼防。
方向其實很單純:
不要讓資料有機會變成語法。
具體有三個做法,而且要一起用。
這是最關鍵的一個。
參數化查詢(Parameterized Query)的意思是:
SQL 語法和資料分開送,不要自己拼在一起。
Day 18 其實就已經這樣寫了:
cursor.execute("INSERT INTO tasks (name, completed) VALUES (?, ?)", ("洗碗", 0))
那個問號就是「這裡等一下會放一個值」的位置,
真正的值是透過第二個參數另外傳進去的。
把昨天的危險版本改成參數化,只改兩行:
def login(username, password):
    # 安全版本:參數化查詢
    sql = "SELECT * FROM user WHERE username = ? AND password = ?"

    print("實際執行的 SQL:")
    print(sql)

    result = cursor.execute(sql, (username, password)).fetchall()

    if result:
        print("登入成功:", result)
    else:
        print("登入失敗")
    print("-" * 50)
存成 injection_fixed.py,然後跑一次:
python injection_fixed.py
結果:
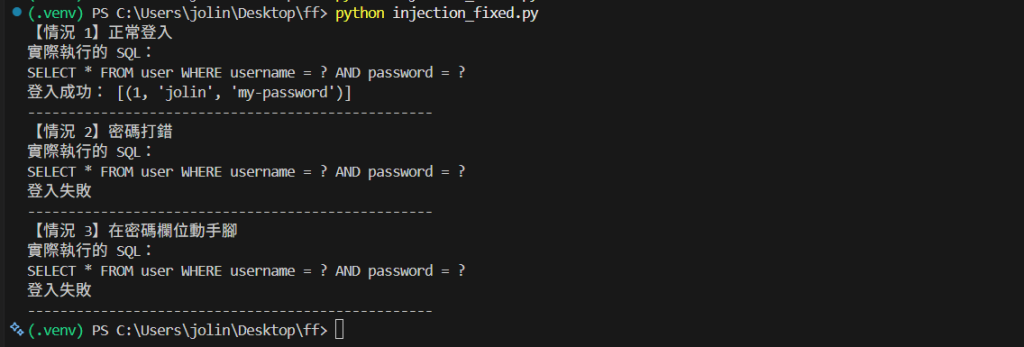
改成參數化之後,同樣的攻擊字串變成登入失敗
同樣的輸入,這次沒有用了。
而且注意印出來的 SQL:不管使用者輸入什麼,它永遠都長一樣,問號不會變。
因為送出去的東西變成兩份:
第一份是 SQL 語法:
SELECT * FROM user WHERE username = ? AND password = ?
第二份是資料:
('jolin', "' OR '1'='1")
資料庫會先看語法,決定「這句話要做什麼」,
然後才把值填進問號的位置。
這個時候值只是「一個字串」,不管裡面有單引號、有 OR、有分號,
都只會被當成一段普通的文字拿去比對。
所以 ' OR '1'='1 就真的變成在問:
有沒有一個使用者的密碼剛好是「' OR '1'='1」這串字?
答案當然是沒有,所以登入失敗。
拼接和參數化最大的差別就是:
拼接 → 資料有機會改變語法
參數化 → 語法先決定好,資料只能是資料
不同的資料庫套件寫法可能不太一樣(有的是 ?,有的是 %s,有的是 :name),
但概念都是同一個。
參數化只能用在「值」,不能用在表名、欄位名。
例如這樣是不行的:
# 這樣不會動
sql = "SELECT * FROM ? WHERE id = ?"
如果真的需要讓使用者決定排序欄位之類的,正確做法是用白名單:
ALLOWED_SORT = {"id", "name", "completed"}

if sort_by not in ALLOWED_SORT:
    api.abort(400, "不支援的排序欄位")

sql = f"SELECT * FROM task ORDER BY {sort_by}"
重點是那個值一定要是「我們自己清單裡的」,而不是使用者說了算。
我們從 Day 19 開始用的 SQLAlchemy,預設就會幫我們做參數化。
想確認的話,可以在設定裡加上 SQLALCHEMY_ECHO,把 SQLAlchemy 實際送出去的 SQL 印出來:
app = Flask(__name__)
app.config['SQLALCHEMY_DATABASE_URI'] = 'sqlite:///tasks.db'
app.config['SQLALCHEMY_ECHO'] = True        # ← 加這行

db = SQLAlchemy(app)
位置要注意:一定要加在 db = SQLAlchemy(app) 的前面。
因為 SQLAlchemy(app) 那一行就會把設定讀走、把連線建好,寫在後面就來不及了(我兩種都試過,放後面完全沒作用)。
不想動到 app.py 的話,也可以另外寫一個小檔案 echo_test.py 來看:
from flask import Flask
from flask_sqlalchemy import SQLAlchemy

app = Flask(__name__)
app.config['SQLALCHEMY_DATABASE_URI'] = 'sqlite:///tasks.db'
app.config['SQLALCHEMY_ECHO'] = True          # ← 要驗證的設定

db = SQLAlchemy(app)


class Task(db.Model):
    id = db.Column(db.Integer, primary_key=True)
    name = db.Column(db.String(100), nullable=False)
    completed = db.Column(db.Boolean, nullable=False, default=False)
    due_date = db.Column(db.String(20))
    priority = db.Column(db.Integer, nullable=False, default=0)


with app.app_context():
    db.session.scalars(db.select(Task).filter_by(name='洗碗')).all()
跑一次:
python echo_test.py
終端機會印出:
2026-10-12 01:14:53,346 INFO sqlalchemy.engine.Engine BEGIN (implicit)
2026-10-12 01:14:53,348 INFO sqlalchemy.engine.Engine SELECT task.id, task.name, task.completed, task.due_date, task.priority
FROM task
WHERE task.name = ?
2026-10-12 01:14:53,348 INFO sqlalchemy.engine.Engine [generated in 0.00024s] ('洗碗',)
2026-10-12 01:14:53,350 INFO sqlalchemy.engine.Engine ROLLBACK
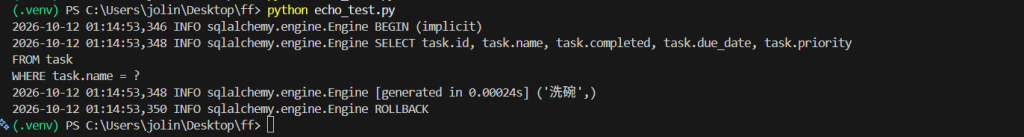
開啟 SQLALCHEMY_ECHO 之後,終端機顯示的 SQL 用的是問號
重點在中間那三行:
WHERE 後面是一個問號 ?,不是「洗碗」這兩個字。
真正的值在下一行的 ('洗碗',) 單獨列出來。
也就是說,語法和資料是分開送給資料庫的 —— 這正是參數化查詢。
(頭尾那兩行 BEGIN (implicit) 和 ROLLBACK 可以不用管。
SQLAlchemy 查詢前會自動開一個交易,這個小程式只是查資料、沒有寫入,
結束的時候就把交易收掉了,不是出錯。)
看完記得把這行關掉或註解起來:
# app.config['SQLALCHEMY_ECHO'] = True # 需要看 SQL 的時候再打開
不然之後每一個請求都會在終端機吐一大串 SQL,真的出錯的時候反而找不到錯誤訊息。
這點我實際跑了一次給自己看。
寫一個小程式 text_test.py,放在跟 app.py 同一個資料夾(這樣才找得到 instance/tasks.db):
from flask import Flask
from flask_sqlalchemy import SQLAlchemy
from sqlalchemy import text

app = Flask(__name__)
app.config['SQLALCHEMY_DATABASE_URI'] = 'sqlite:///tasks.db'
db = SQLAlchemy(app)


class Task(db.Model):
    id = db.Column(db.Integer, primary_key=True)
    name = db.Column(db.String(100), nullable=False)
    completed = db.Column(db.Boolean, nullable=False, default=False)
    due_date = db.Column(db.String(20))
    priority = db.Column(db.Integer, nullable=False, default=0)


attack = "' OR '1'='1"

with app.app_context():
    total = len(db.session.scalars(db.select(Task)).all())
    print('資料表總共有', total, '筆')

    print('--- 1 ORM filter_by(安全)')
    rows = db.session.scalars(db.select(Task).filter_by(name=attack)).all()
    print('    查到', len(rows), '筆')

    print('--- 2 text() + f-string(危險)')
    rows = db.session.execute(text("SELECT * FROM task WHERE name = '%s'" % attack)).fetchall()
    print('    查到', len(rows), '筆  ← 整張表都被撈出來')

    print('--- 3 text() + 綁定參數(安全)')
    rows = db.session.execute(text("SELECT * FROM task WHERE name = :name"), {"name": attack}).fetchall()
    print('    查到', len(rows), '筆')
三種寫法的差別就在中間那三段:ORM 的 filter_by、text() 自己拼字串、text() 用綁定參數。
跑一次:
python text_test.py
結果:
資料表總共有 3 筆
--- 1 ORM filter_by(安全)
    查到 0 筆
--- 2 text() + f-string(危險)
    查到 3 筆  ← 整張表都被撈出來
--- 3 text() + 綁定參數(安全)
    查到 0 筆
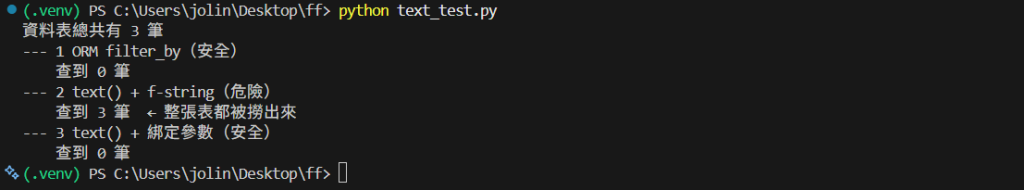
第 2 種就是昨天說的「用了 ORM 還是會中」。
雖然是透過 SQLAlchemy 執行的,但因為我們自己把字串拼起來,
它就只是幫我們把那句話送給資料庫而已,該中的還是會中。
所以如果真的需要自己寫 SQL(有些複雜查詢用 ORM 反而難寫),
正確的寫法是第 3 種:用 :name 當參數位置,值另外用字典傳進去。
(筆數會跟你資料表裡有幾筆有關,重點是「安全的查到 0 筆、危險的把整張表都撈出來」。)
Day 25 做的事情,在這裡也是一層防護。
例如:
name 必須是字串、不能超過 100 個字
completed 必須是布林值
id 一定是整數(我們用 <int:task_id>,非整數根本進不來)
這樣可以擋掉一部分奇怪的輸入。
但是要講清楚一個觀念:
輸入驗證是「加分」,不是「主要防線」。
真正的主要防線是參數化查詢。
因為驗證再嚴格,只要哪天有一個地方忘了驗證、或規則寫得不夠周全,
只要那裡是用字串拼 SQL,就會中。
反過來說,只要全部都用參數化,就算使用者輸入一整段 SQL,也只是一段文字而已。
順序是:
參數化查詢 → 一定要做
輸入驗證 → 再多一層保險
來做一個有趣的測試。
拿昨天那種攻擊字串,直接打我們自己的 API(記得先 Authorize):
POST /tasks
{
  "name": "Robert'); DROP TABLE task;--",
  "completed": false
}
Execute。
結果是:新增成功,回傳 201。
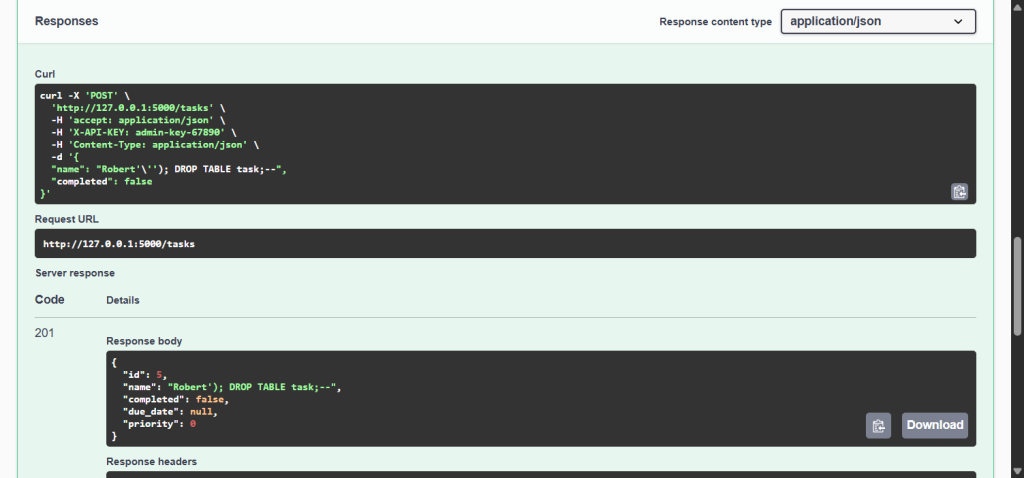
用攻擊字串新增作業,回傳 201
然後用 GET /tasks 看,最後新增的那一筆長這樣:
{
  "id": 5,
  "name": "Robert'); DROP TABLE task;--",
  "completed": false,
  "due_date": null,
  "priority": 0
}
(截圖裡有兩筆一樣的名稱,是因為我前面測過一次,不影響結果。)
它就只是一筆「名字很奇怪」的作業而已。
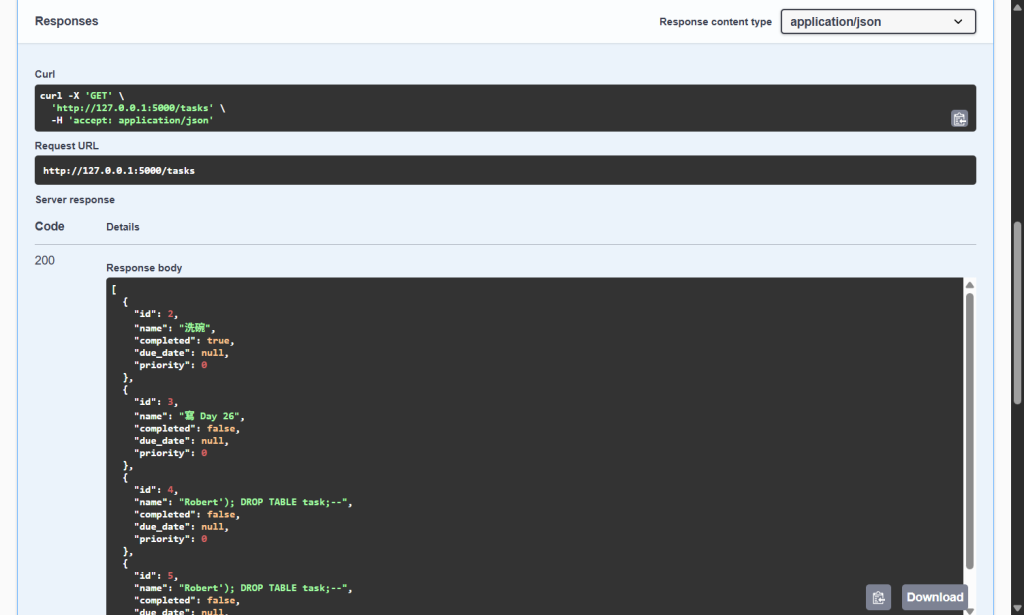
GET /tasks 顯示那串字被當成普通的名稱存起來
再用 check_db.py 確認資料表還在不在:
python check_db.py
=== 資料庫裡有哪些表 ===
[('alembic_version',), ('task',)]
=== task 表裡面的資料 ===
(2, '洗碗', 1)
(3, '寫 Day 26', 0)
(4, "Robert'); DROP TABLE task;--", 0)
(5, "Robert'); DROP TABLE task;--", 0)
資料表沒有被刪掉,資料都還在,那串字只是一個名稱
task 表還在,其他資料也都在。
這就是參數化查詢在保護我們,而我們其實什麼都沒特別做,
只是因為一直都用 ORM,沒有自己拼 SQL 字串。
除了上面三個,還有幾個習慣:
資料庫帳號用最小權限
應用程式用的帳號,只給它真正需要的權限。
例如只需要讀寫資料,就不要給它刪除資料表的權限。
這樣就算真的被攻擊,損害也會小很多。
錯誤訊息不要外洩
Day 24 和 Day 27 都提過,把詳細錯誤留在伺服器端的 log。
套件要更新
資料庫驅動、ORM 都可能有漏洞,定期更新。
不要只靠前端
前端的檢查對攻擊者來說是不存在的(Day 25 已經示範過了)。
寫完程式可以自己看一下:
有沒有地方用 f-string 或 + 把變數拼進 SQL?
有沒有用 text() 又把變數拼進去?
表名、欄位名有沒有讓使用者決定?如果有,是不是用白名單?
錯誤訊息會不會把資料庫的細節回傳給使用者?
輸入有沒有基本的驗證?
只要第一項和第二項都沒有,其實就已經避開九成的風險了。
參數化查詢 → 語法和資料分開送,最重要的一招
ORM → 預設會幫我們參數化,但 text() 拼字串一樣會中(實測過了)
輸入驗證 → 第二層保險,不是主要防線
最小權限、不外洩錯誤訊息、定期更新 → 習慣問題
也實際驗證了我們的 API 現在可以擋住這種攻擊。
到這裡,錯誤處理和基本資安的部分就告一段落了。
前面 28 天,我們從「前端後端是什麼」一路走到 Flask、Flask-RESTX、資料庫、Migration、錯誤處理和資安。
下一篇就把這些全部串在一起,做出一個完整的 API。


 iThome鐵人賽
 看影片追技術