
Day 27 處理了日期、週界與篩選範圍。接下來,我想讓儀表板回答更進一步的問題:有告警觸發紀錄的設備,平均觸發幾次?已完成審核的草稿,有多少目前處於退回狀態?
這兩個問題看起來只是除法,真正需要釐清的卻是分母。我把第一個指標命名為「每台有觸發紀錄設備的平均觸發次數」,明確排除沒有觸發紀錄的設備;它不能稱為全體設備故障率。審核退回比例則描述草稿處理狀態,不能與告警平均合成設備健康分數。
以下延續設備維運的設計情境,新增公式、審核統計與驗收流程尚未經真實資料驗證。
沿用 Q17 的事件設計,E501、E503 是觸發,E502 是恢復。計算平均前,我先保留去重後的觸發事件,再套用 Day 27 定義的台北日期與設備條件。設備識別碼缺失或空白的事件另列,並從這個平均的分子、分母一併排除,避免有事件進入分子,卻沒有設備進入分母。
在這個準備好的範圍上,BigQuery 的計算式是:
SAFE_DIVIDE(COUNT(*), COUNT(DISTINCT device_id))
若 Data Studio(原 Looker Studio)來源保留每筆去重事件,且 event_id 有效,非零分母時可用 COUNT(event_id) / COUNT_DISTINCT(device_id) 核對同一指標。官方的 COUNT_DISTINCT 計算欄位中的不重複值,輸入必須是未彙總的欄位或運算式。
我會先分別核對觸發事件數與不重複設備數,最後才核對平均。分母去重不會替分子去重;若重複事件仍留在來源,即使設備數正確,平均仍會被抬高。
如果 Q17 在不同日期都有觸發紀錄,每天的不重複設備數都會計入它。但把每日設備數加起來,得到的是設備在各日出現的次數,不是整週有多少台不同設備。
觸發事件在不重疊、已去重的日期分組下可以加總;整週設備數則要回到所選範圍,重新對設備識別碼去重。每日平均也不能直接平均成整週平均,因為各日設備數可能不同,而且同一設備會跨日出現。
即使按每日設備數加權,分母仍是每日設備數的合計,不能代替整週不重複設備數。若摘要資料只剩日期、觸發次數與設備數,失去設備識別資訊,就無法還原精確的整週分母。
因此,我會保留可跨日辨認設備的資料。使用 SUM 加總數值時,也要核對欄位是否已由連接器彙總;官方 SUM 不接受已彙總欄位或另一個彙總函式的結果。
草稿可能先被退回,修改後再確認。如果我同時把這兩次審核計入,算到的是審核動作的分布,而不是目前有多少草稿待修正。
主圖因此規劃採用「每個回報選定草稿版本的最新審核狀態」,計算方式是:
退回比例=退回數 ÷(退回數+確認數)
草稿與待審另外顯示,不進入這個分母。選定版本時,我仍保留回報編號、文字版本與分析設定版本,並辨認草稿版本;模型呼叫重試不能被當成多份已審草稿。
若日後要觀察返工負擔,我會另做歷次審核統計,以每次審核動作為計數單位。最新狀態與歷次動作有不同用途,不能共用一個「退回率」名稱。退回比例低,也只能描述已完成審核的選定草稿,不能證明待審草稿或模型輸出都正確。
當範圍內沒有可計入的觸發事件,或草稿全部仍待審,就沒有足夠分母計算上述指標。這時若顯示零,讀者可能誤以為沒有告警,或所有草稿都通過審核。
BigQuery 的 SAFE_DIVIDE 在除零等錯誤發生時回傳 NULL。我會在 SQL 端保留這個差異,並規劃讓報表以「尚無可計算資料」說明,而不把空值一律轉成零。這是 BigQuery 的處理方式,不是把 SAFE_DIVIDE 當成 Data Studio 函式。
空值原因也要一起留下:是沒有符合範圍的資料、設備識別碼缺失,還是尚未完成審核?尤其「沒有觸發紀錄」仍須配合 Day 27 的資料完整性判斷,不能直接解讀為設備正常。
建立計算欄位時,我先確認它放在資料來源,還是單張圖表。官方說明指出,來源層欄位可供使用該來源的報表引用;圖表層欄位只存在於該圖。公式明確指定彙總方式,可以讓計算依指定方式執行,但不會替我驗證分母的業務意義。
若審核來源已整理為每份選定草稿的最新狀態,可規劃未彙總的退回與確認旗標,再以總退回數除以總完成審核數。這是先分別彙總分子、分母,再相除;不能先算各組比例,再取簡單平均。
我也會記錄來源版本、計數單位、排除條件與零分母處理。若 SQL 先算好某個固定範圍的比例,報表不能假設改個篩選就能還原分子、分母並重新計算。
官方的比例彙總錯誤文件,主要以 Google Ads、Google Analytics 等已彙總來源說明限制,也指出 BigQuery 可以提供未彙總資料。因此,我要查的是實際來源保留了什麼,不能推論所有 BigQuery 自訂比例都無法重算。
公式儲存後,我規劃把指標放進摘要卡,再切到查看模式,與同範圍 SQL 核對:
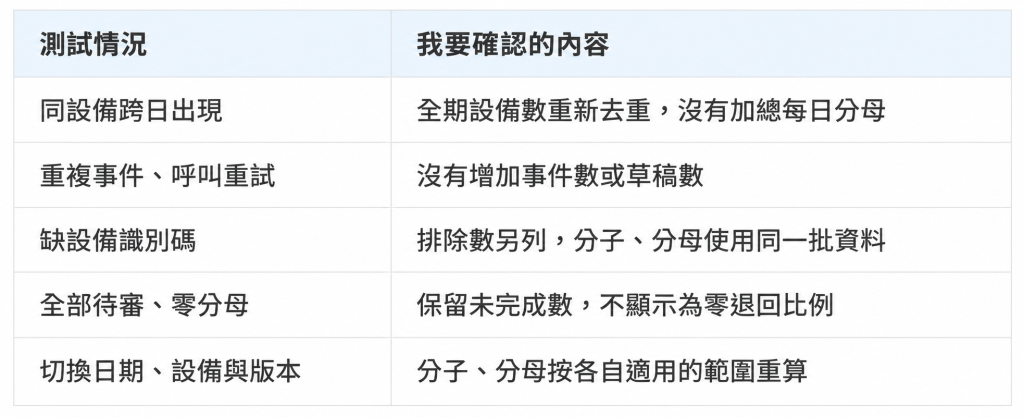
審核資料若沒有可靠設備關聯,就不受設備事件篩選;最新狀態的截止時間也要固定,避免兩次比較之間有人完成審核,卻被誤認為公式算錯。
最後,我會先比較分子、分母與未四捨五入的結果,再檢查小數位及百分比格式。顯示精度只改變呈現,不能修正錯誤公式;只有設定與測試規劃,也不能宣稱已通過驗收。
平均與比例的定義清楚後,下一步才是看 AI 議題分布:哪些回報被歸為告警處理、操作介面或校正資訊?即使分類比例算對,這些結果又能支持哪些判斷,哪些仍需要回到逐筆證據確認?


 iThome鐵人賽
 看影片追技術