
前一天介紹 AgentEvals 與 Inspect AI,討論如何測試 Agent 是否遵守 SOP。今天接著看 Uber 的 Legal Redlining Agent(LRA):當 Agent 進入日常工作,如何利用專家的修正,改善下一次的建議?
Uber 從標準 RAG 出發,逐步加入歷史回饋、語氣調整與條款修改。這裡的 Self-Learning,主要是更新模型推論時取得的參考資料,並非重新訓練模型。
LRA 整合在 Microsoft Word Add-in,讓律師在原有文件中查看建議、追問、維護規則及提供回饋,不必另外上傳合約、複製結果。
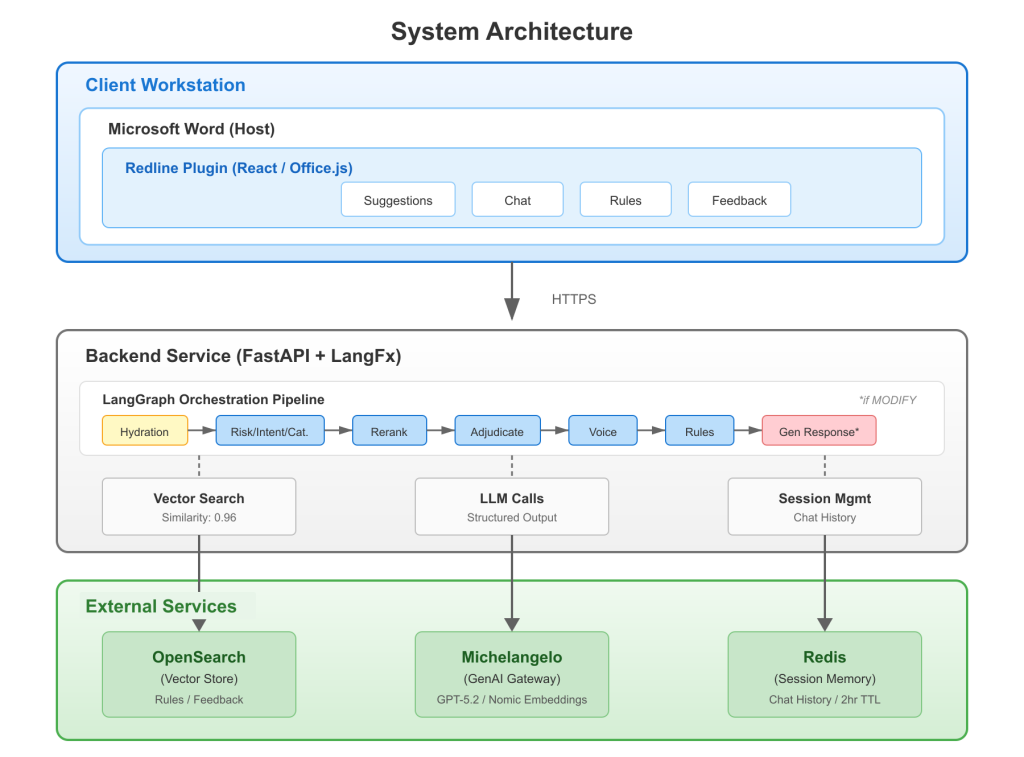
| 元件 | 用途 |
|---|---|
| React、TypeScript、Office.js | 讀取 Word 修訂、呈現建議及收集律師操作 |
| FastAPI、LangGraph | 串接意圖與風險分析、檢索、決策、語氣調整及條款生成 |
| OpenSearch | 儲存與檢索正式規則、歷史談判案例 |
| Redis | 保存對話狀態,支援針對文件追問 |
| Uber GenAI Gateway | 提供模型呼叫入口 |
LangGraph 會平行執行沒有相依性的工作,例如修改意圖分析與風險評估。整合 Word 也有工程成本:官方提到,修訂 API 在部分文件結構下可能出錯,刪除文字也可能回傳空字串,因此需要額外管理文字狀態。
但這套系統最重要的改變,仍在於它如何取得決策依據。
Uber 的 LRA 經歷四個版本,依序改善決策依據、回覆語氣與條款修改能力。
V1|標準 RAG:根據 Legal Playbook 判斷是否接受
LLM 先分析客戶的修改意圖,再檢索 Legal Playbook,產生接受或拒絕建議。但客戶用語與文件不一定能正確匹配,Playbook 也未必記錄實際談判中可以接受的妥協方式,因此「找到相關文件」仍不足以做出合適決策。
V2|加入歷史回饋:參考律師實際採用的答案
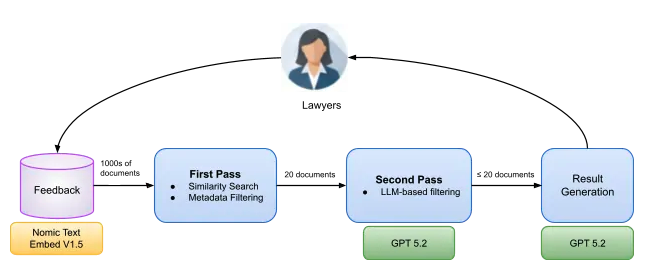
相較於 V1 主要依賴政策文件,V2 加入歷史談判與律師修正紀錄,補上文件沒有交代的處理經驗,核心特色是 Feedback Loop:
nomic-embed-text-v1.5 與 GPT-5.2。這裡的 Self-Learning,是把專家修正整理成下一次推論的參考案例,並非重新訓練模型。時間衰減也不能取代規則更新:若付款政策今天改變,仍須立即更新正式規則。
V3|調整語氣:讓建議符合實際談判方式
決策正確之後,回覆仍可能過於強硬或過度讓步。V3 因此增加一次專門調整語氣的 LLM 呼叫,由法律專家維護 Prompt 的三部分:Objective 定義修正目標、Style 指定表達方式、Conversation Starters 提供開頭範例。
Uber 稱此做法為 Proactive and Pessimistic Reflection:直接要求模型處理已知的語氣問題,省去先判斷是否需要修改的步驟,也不是持續重試的多輪 Reflection Loop。
V4|生成替代條款:從「建議修改」走向「提供修改文字」
只有 Modify 決策,律師仍須自行重寫。V4 結合原始合約、正式規則與歷史修改,生成可供審查的替代條款。例如,將「建議縮短付款期限」進一步寫成「Payment shall be made within 45 days.」。
這一步需要保留原合約的法律用語與上下文,避免加入未定義的名詞或額外條件,最終是否採用仍由律師決定。
除了上述迭代,Uber 也利用標準合約的共同結構提高檢索準確度:按分號、句點與換行切分原文,以原始句子定位條款及相關紀錄,再以修改意圖尋找類似談判經驗。兩者分別回答「改的是哪一條」與「對方想改什麼」,但官方未公開完整查詢順序與合併權重。
Uber 在 OpenSearch 中設置兩個主要 Index:
| Index | 內容 | 檢索依據 |
|---|---|---|
| Rules Index | 公司立場、允許的替代條件、回覆範例 | 目標條款的 Embedding |
| Feedback Index | 過去談判、律師決策及修正 | 談判意圖的 Embedding |
沿用付款案例,「最多 45 天,超過須主管核准」屬於正式規則;「客戶要求 60 天時,通常先提出 45 天」則是談判經驗。
律師可以在 Word Add-in 選取原始條款,建立公司立場、Fallback Position 與回覆範例,其中 Fallback Position 指經允許的替代條件。這些規則編輯、儲存與檢索功能由 Uber 自行開發,並非 LangGraph 的內建設定。
官方將非協商政策描述為 deterministic Rules Engine,表示命中規則後可覆蓋模型判斷;同時也說明,流程包含語意檢索、高信心匹配、將規則加入模型 Context,以及最後一次 LLM 合規檢查。
因此,規則具有優先地位,不等於公開資料已證明所有違規輸出都會被程式攔截。Uber 未公開完整執行程式,無法確認強制檢查的範圍。
若自行開發 SOP Agent,付款上限、改票資格等不可違反的限制,應在實際執行工具或後端服務中檢查;核准狀態也必須來自有權限的系統,不能只相信模型回傳的值。
Uber 在後端持續執行 LLM-as-a-judge 評測,公開的指標包含:
| 指標 | 檢查重點 | 付款案例中的問題 |
|---|---|---|
document_quality_metric |
檢索文件及相關內容的品質 | 是否取得現行的 45 天規則,而非只有舊案例? |
rule_adherence_metric |
模型輸出是否遵守規則 | 已取得 45 天規則,卻仍接受 90 天? |
兩者有助於區分檢索與決策問題,但官方未公開完整 Judge Prompt、評分格式、頻率或門檻,也不能直接把文章提到的 91% 決策準確率視為這兩個指標的計算結果。
回到航空改票 SOP Agent,若客服發現 Agent 沒查票規就修改訂位,應保存實際動作、預期步驟及適用規則,再將失敗案例轉成回歸測試。修正方式則取決於問題位置:


 iThome鐵人賽
 看影片追技術