
資訊基準日:2026-10-27,基於 Splash 1.4.0、Strata v0.2.6、Qwen3.8-Flash-Next(Strata v0.2.7 於同日稍晚發布,本文未涵蓋)。兩個專案都在 2026-09 建立、幾乎每天發版,數字與支援範圍請以當下的 README 為準。
Qwen3.8-Flash-Next 有 125B 參數,每個 token 只動用約 6B。Splash 與 Strata 這兩個本地推論引擎(inference engine)讓它在記憶體放不下的機器上仍跑得快:Q2_0 量化檔有 66.4 GB [2],比 64GB 的 M5 Pro 記憶體還大,Splash 在這台機器上量到約 95 tok/s [5];Strata 在 12GB 顯卡加 64GB RAM 的電腦上量到約 94 tok/s [9](官方量測,條件見表 2)。
「12GB 顯卡跑 125B」這個說法站得住腳。Strata 文件裡的實測是 12GB 顯卡搭配 64GB 系統 RAM [9]:顯卡能小,是因為 RAM 存放其餘的 expert、CPU 負責計算它們,SSD 則放 n-gram 表。RAM 再少也能跑,速度會隨 RAM 下降:文件中 32GB 的 M4 Mac mini 靠 SSD 串流 expert,約 14 tok/s [10]。
另外,這兩個引擎也不是同一類東西。Splash 只能在 Apple Silicon 的 Mac 上跑 [4];Strata 支援多種顯卡,也有 Mac 版 [7]。本文把它們各自當作一種做法來看,不排名次。
外面流傳的三個數字各自指不同的範圍,先對齊再往下讀。
| 流傳的說法 | 實際範圍 | 出處 |
|---|---|---|
| 125B | MoE 本體的參數量;每個 token 激活約 6B | [1] |
| 177B(也有人寫 176B、180B) | 把 51B 的 n-gram embedding 一起算進去;ISTA 的 GGUF 回報 176,943,899,520 個參數,官方卡的 safetensors 合計約 180B | [1][2] |
| 12GB 顯卡跑 125B | 成立。文件上的實測是 12GB 顯卡搭配 64GB RAM(引擎 0.1.36,文件「History」段的舊版量測);RAM 放不下全部 expert 時改從 SSD 讀,仍能跑,速度會降 | [9][10] |
n-gram embedding 是以連續幾個 token(n-gram)為索引的查表式參數。Qwen 官方卡的說明是,這種參數比 MoE 更適合搬到較慢的儲存層 [1]。這份表在 GGUF 檔案裡佔 28.8 GB,以固定 4.5 bpw(IQ4_NL)儲存 [2]。後面會看到 Strata 把它放在 SSD,Splash 在記憶體放不下時也會從 SSD 串流 [5][8]。
MoE(Mixture of Experts,混合專家)模型的每一層有許多個小型子網路,稱為 expert,每個 token 由 router 挑其中幾個來算。
Qwen3.8-Flash-Next 有 48 層,每層 512 個 expert,每個 token 用 10 個 routed expert 加 1 個 shared expert [1]。全部加起來是 24,576 個 expert [8],但同一個 token 只會碰到其中一小部分。
這帶來一個可以利用的不對稱:計算量跟著激活的參數走,容量卻得放得下全部。所以常被選中的 expert 可以放在快的記憶體,其餘放在慢的儲存層,小記憶體就能撐起大模型。Strata 的文件用「常用的放在檯面上,其餘收進儲藏室」來形容這個做法 [8];把 MoE 搬到消費級硬體,以及快閃儲存的頻寬是瓶頸,在 2023 年的論文裡就有討論 [20]。
Strata 的做法是讓顯卡和 CPU 一起算,並把模型拆成三層,分給不同速度的硬體存放。
Strata 是 Niko1221 發布的本地推論引擎,MIT 授權,2026-09-24 建立,v0.2.6 於 2026-10-25 發布 [7]。README 的硬體表列出 NVIDIA、AMD Radeon、Intel Arc(Linux)、Apple Silicon M1 以上與 Strix Halo。
它要解的問題是:顯卡的 VRAM 放不下 24,576 個 expert。
Strata 的文件把分工寫得很具體 [8]。顯卡放每個 token 都會用到的部分(attention、router、shared expert,以及 KV,也就是 attention 的 key-value 快取)和一塊會自行調整的熱門 expert 快取。系統 RAM 放全部 24,576 個 expert,顯卡沒有的 expert 由 CPU 就地算出來,與顯卡並行。SSD 只放 28.8 GB 的 n-gram 表,每個 token 讀幾列。
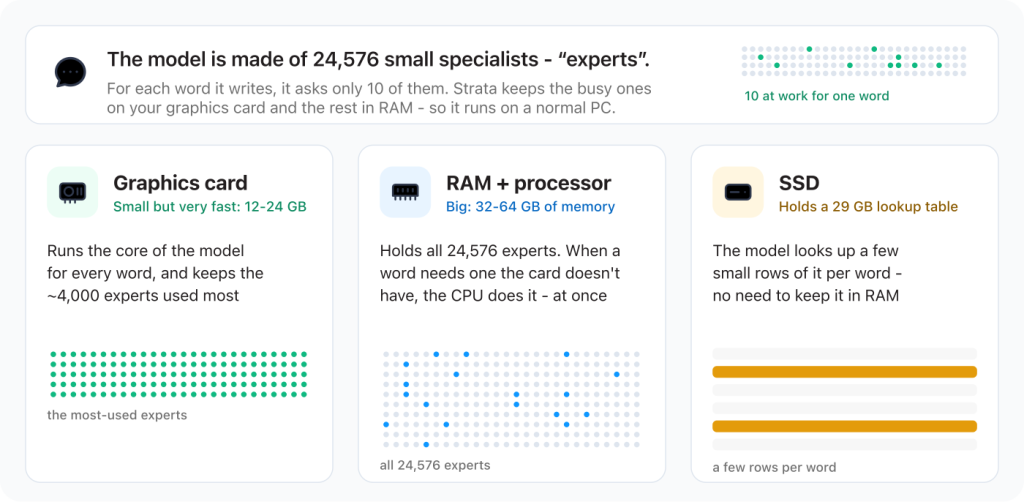
圖 1:Strata 官方示意圖。來源:Strata 專案的 docs/media/how-it-works.svg [22],MIT 授權,圖中文字為原文。
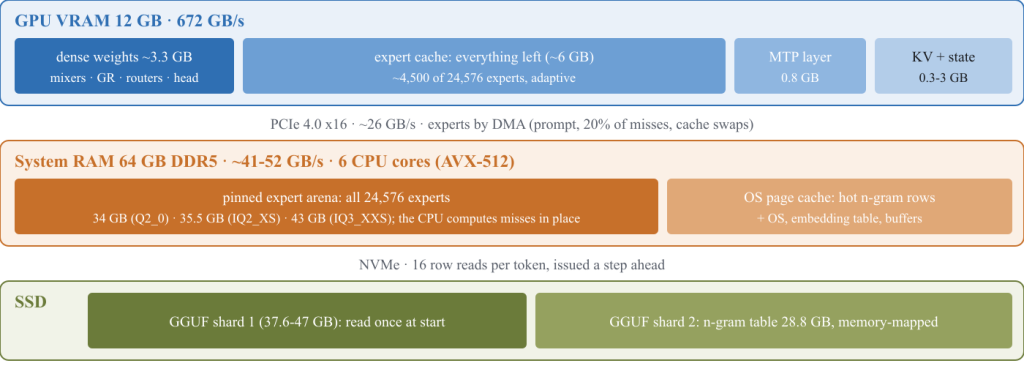
圖 2:12GB 顯卡、64GB DDR5 RAM 的配置示例。來源:Strata 論文附圖 docs/paper/tiers.svg [23],MIT 授權。數字只對應這一組硬體;圖 1 的「約 4,000 個」是概數。
圖 2 的數字值得細看:12GB 顯卡裡,密集權重約 3.3 GB,剩下約 6 GB 給 expert 快取,只裝得下約 4,500 個 expert;其餘的 expert 全在 RAM 裡,Q2_0 版約 34 GB [23]。
判定:Strata 把瓶頸從 VRAM 搬到系統 RAM 的容量與頻寬,再加上 CPU 的算力。RAM 夠大時速度最好:文件寫明,RAM 放得下全部 expert 再加約 10 GB 就能整個放進記憶體;64GB RAM 放得下所有尺寸,48GB 放得下 Q2_0 與 IQ2_XS。RAM 不夠時 expert 會改從 SSD 讀,文件的說法是 "works and is much slower" [9],也就是仍然能跑。
CPU 的角色也要算進去:顯卡沒有的 expert 由 CPU 就地計算,用的是 AVX2 或 AVX-512 的 kernel [8],所以速度除了看 RAM,也看 CPU 的核心數與指令集。這是依設計做的推論;MODELS.md 對 12GB 顯卡的說明也提到每個 token 的時間大多花在等 SSD 和 CPU,不過該段針對的是 DeepSeek 模型 [9]。
Splash 走的是另一條路:它假設你的硬體只有一池記憶體,然後讓 SSD 去補不夠的部分。
Splash 是 Inco AI 的 Apple Silicon 專用引擎,Apache-2.0 授權,repo 於 2026-09-18 建立。它要求 Apple M3 以上、macOS 26.4 以上,用 Homebrew 安裝 [4]。1.4.0 在 2026-10-20 發布,加入對 Qwen3.8-Flash-Next 的支援 [5]。
它要解的問題是:Mac 的 CPU 與 GPU 共用同一池統一記憶體(unified memory),沒有「顯卡 VRAM 加系統 RAM」兩層可以分工。而 Q2_0 的模型檔就有 66.4 GB [2],超過許多 Mac 的容量。
1.4.0 的 release notes 說明了規劃方式 [5]。規劃器把一份記憶體預算分給權重、context 與串流快取。expert 放得下就常駐,放不下就從 SSD 串流,RAM 額度由 --expert-memory 調整。Flash-Next 的 n-gram 表(release notes 稱 PLE)放不下時也會串流,預設保留 512 MiB 的 row cache。Flash-Next 進行中請求的 KV 可以溢出到 SSD,熱的部分留在記憶體(27B 與 35B 的 KV 則維持常駐)。--max-memory 讓你替其他應用程式留空間,並縮小這些自動分配的快取。
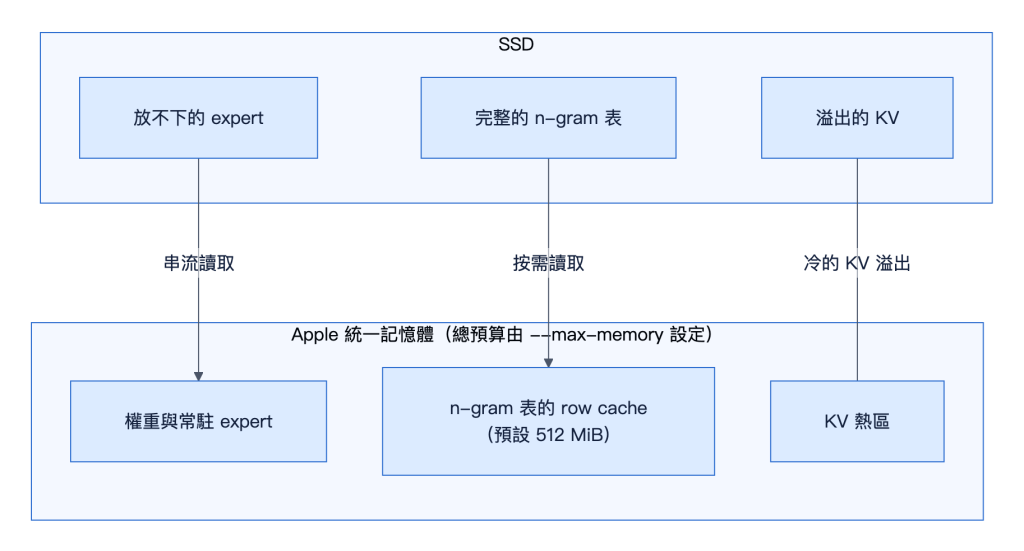
圖 3:依 Splash 1.4.0 release notes [5] 整理的記憶體與 SSD 分工,作者自繪。
判定:release notes 把這套機制形容為用 SSD 讀取換 RAM [5],所以它的上限由 SSD 讀取速度與你設定的記憶體預算決定。官方在 M5 Pro(20-core GPU、64GB)上用 Q2_0 量到 95 tok/s 的 decode 速度 [5](decode 指逐個生成 token,prefill 指一次讀入整段 prompt,tok/s 是每秒 token 數)。
量化(quantization)是用較少的 bit 儲存權重。兩個引擎跑的是同一組 GGUF(llama.cpp 生態的模型檔格式)量化檔,由 ISTA-DASLab(奧地利科學技術研究院 ISTA 的 Alistarh 實驗室)發布 [2][12]。
這組量化要解的問題很直接:BF16 原檔 354 GB,沒有一般硬體放得下,壓到 66.4 GB 才有討論空間 [2]。
製作流程是兩步:GSQ(Gumbel-Softmax Quantization)學習每個權重的量化 grid 與每組的 scale [12],RCO(Riemannian Constrained Optimization)再在總 bit 預算下替每個 tensor 選一種量化型別 [13],最後組成一個標準 GGUF [2]。下表的 bpw(bits per weight)就是這樣搜出來的平均值。
其中的 Q2_0 是新的均勻型別:每 64 個權重一塊、共用一個 fp16 scale,每個權重 2 bit,值域是 {-1, 0, +1, +2} [16]。它沒有 lookup table;官方卡的說法是這讓 decode 比 i-quant 系列快,在 llama.cpp 上的對照是 93.8 對 70.3 tok/s [2]。
| 型別 | 平均 bpw | 檔案大小 | 任務平均 |
|---|---|---|---|
| BF16(原檔) | 16 | 354 GB | 93.12 |
| Q2_0 | 2.40 | 66.4 GB | 89.07 |
| IQ2_XS | 2.50 | 68.0 GB | 89.16 |
| IQ3_XXS | 3.00 | 75.8 GB | 92.57 |
| IQ3_S | 3.50 | 83.6 GB | 93.26 |
表 1:ISTA-DASLab 官方卡自測 [2]。任務平均為 AIME25、GPQA-Diamond、LiveCodeBench v6 的平均,據維護者說明是在 xhigh 推理強度下量測 [17]。bpw 是 transformer 權重的平均,不含以固定 4.5 bpw 儲存的 n-gram 表;Q2_0 單一區塊的名目值為 2.25 bpw [16]。量化檔的大小含 28.8 GB 的 n-gram 表。
判定:兩個 2-bit 版本比原檔低約 4 分,IQ3_S 與原檔幾乎打平(卡片自己說超過 100% 的部分是 benchmark variance)[2]。但這是廠商自測,且只量了 xhigh 推理強度 [17]。
校準資料用的就是 xhigh 的推理軌跡,維護者在 Hugging Face 討論串裡承認,推理強度調低時差距「可能明顯變大」,並稱這是目前方法的限制之一 [17]。查證範圍內,我沒有找到獨立第三方的評測。
推測解碼(speculative decoding)讓一個便宜的草稿端先猜出多個 token,再由目標模型一次驗證,這樣每一輪就能產出不只一個 token。
它要解的問題是:decode 一次只生一個 token,每個 token 都得把用到的權重讀過一遍,所以常受記憶體頻寬限制。
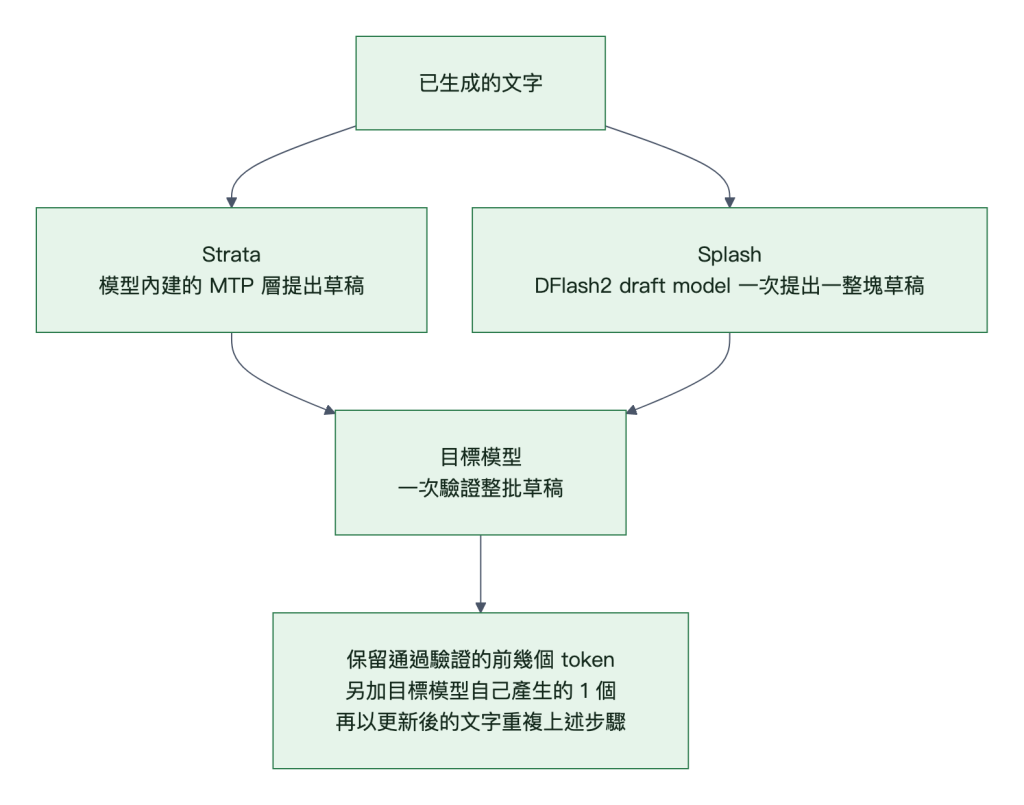
圖 4:推測解碼的流程,以及兩個引擎各自的草稿來源。作者自繪,依據 [3][8]。
Strata 用模型內建的 MTP(multi-token prediction)層最多提出 3 個草稿 token,文件給的加速是 1.6 到 1.8 倍 [8]。Splash 則自動選用 DFlash2:一個約 0.6B 的 block-diffusion 草稿模型,一次 forward 就提出一整塊 token [3][4]。
DFlash2 的卡片標示它是無損的 speculative decoding,block size 為 4,加速比 1.63 到 1.82 倍 [3]。這組數字量測於 SGLang、單張 GB300、concurrency 1,是資料中心環境,不能直接當成 Mac 上的預期。DFlash 的原理見論文 [14],Inco AI 的 DFlash 2 在其上加入 path selector [15]。
判定:兩者的草稿來源不同,流程一樣。草稿端的加速比不能跨平台換算;各引擎的整體 decode 數字見下一節,只能在各自的條件下解讀。
下表的數字都來自各自的官方文件或具名的社群實測,欄位照原文列出硬體、量化與版本。
| 來源 | 硬體 | 量化 | 結果 | 出處 |
|---|---|---|---|---|
| Splash 1.4.0 | M5 Pro(20-core GPU)、64GB | Q2_0+DFlash2 | decode 95 tok/s;32K prompt 的 prefill 1,312 tok/s | [5] |
| Strata 引擎 0.1.36(舊版量測) | RTX 5070 12GB、Ryzen 5 7600、64GB RAM | Q2_0 | decode 94 tok/s(短對話);128K context 下 76 tok/s | [9] |
| Strata(版本未記錄) | M5 Max 128GB、macOS 27.2 | Q2_0,預設設定(MTP+suffix drafter) | decode 119.5(短問題)/108.2(寫故事)tok/s;不含 MTP 為 87.4/87.3 | [10] |
| Strata(版本未記錄) | M4 Mac mini 32GB,expert 從 SSD 串流 | Q2_0 | decode 約 14.1/13.5 tok/s | [10] |
| 社群實測(eth-lab) | RTX 5060 Ti 16GB、i7-11700、64GB DDR4-3200 | IQ3_XXS | decode 中位數 51.30 tok/s(九次) | [19] |
表 2:各自條件下的實測數字,不可跨列比較。
這張表不能當排行榜讀。硬體、量化、引擎版本和 prompt 都不同,同一個引擎在不同 context 長度下也差了近兩成。
Splash 的 README 另有一組與 Strata 在同一台 M5 Pro 上跑同一個 GGUF 的比較,標示 decode 快 1.3 倍 [4]。這是競品的自家比較,建議用你自己的 prompt 重跑一次再下結論。
這兩個專案都很新,下面這些是查證時找到、會影響你決策的事。
install.sh 再執行,Windows 的 PowerShell 安裝則直接把腳本 pipe 給 iex [7]。有用戶回報防毒軟體對 Windows 安裝檔的啟發式偵測,成因我無法驗證 [18]。Windows 那條建議先把腳本下載下來讀過再執行。--max-cache-disk-writes 限制 [6]。qwen-community-1.0 [1];ISTA 的 GGUF 卡片標籤寫 Apache-2.0,內文卻說權重承襲基礎模型的授權,已有人在討論串指出這個不一致 [2][17]。商用前請自己讀授權原文。要選哪一個,看你的機器。
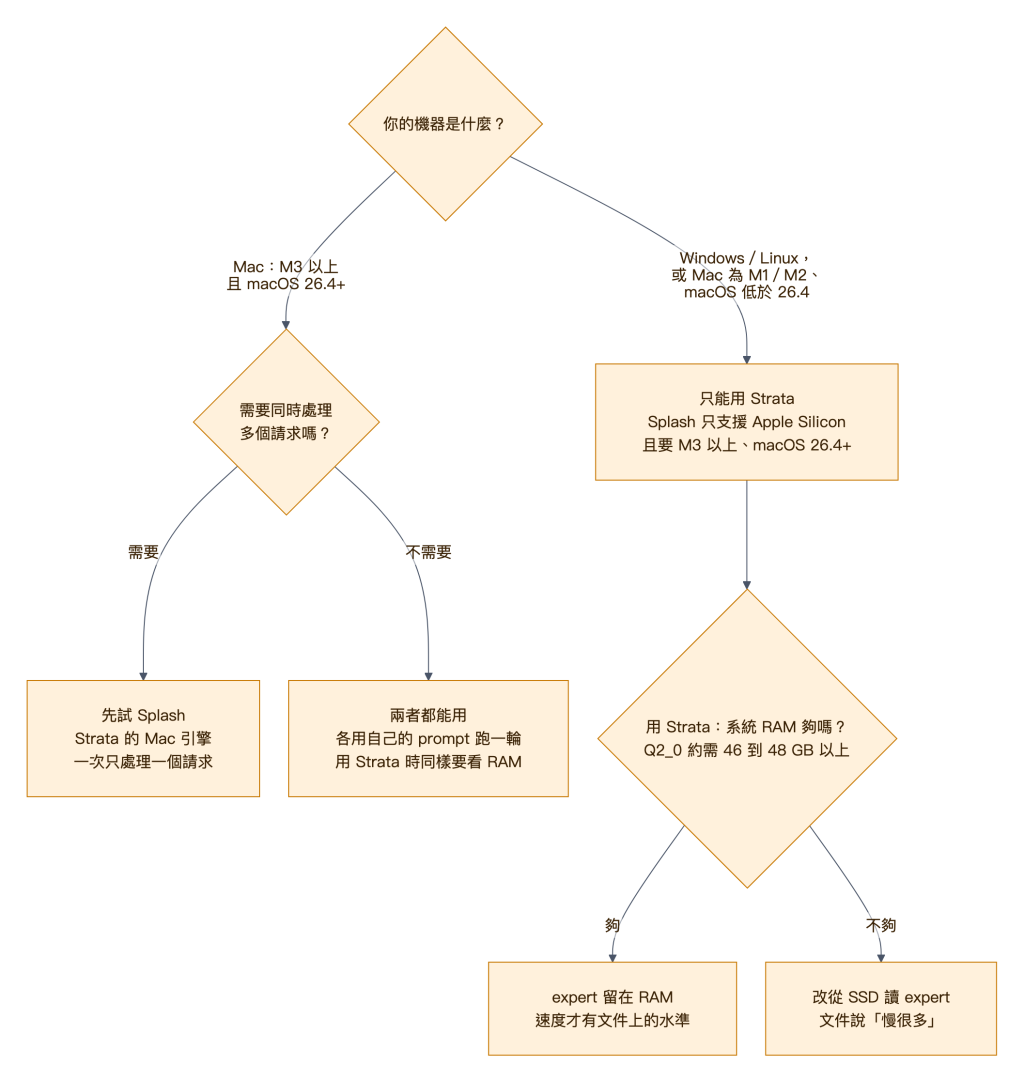
圖 5:選擇流程,作者依 [4][7][9][10] 整理。
Windows 與 Linux 只能用 Strata,因為 Splash 只支援 Apple Silicon [4]。Mac 若是 M1/M2 或 macOS 低於 26.4,同樣只能用 Strata。
用 Strata 時,系統 RAM 決定速度落在哪一檔。放得下的情況:PC 上 Q2_0 在 48GB 放得下,IQ3 系列建議 64GB [9];Mac 上 Q2_0 約需 46GB,IQ3_XXS 約 55GB,IQ3_S 約 63GB,文件建議值分別是 64GB、74GB、96GB [10]。放不下也能跑,改從 SSD 讀 expert,速度會降;表 2 中 32GB 的 M4 Mac mini 約 14 tok/s [10]。Splash 沒有這組門檻,它會把放不下的 expert 串流;release notes 提到過在 36GB 的 M5 Max 上以 12G 的 expert store 跑 Flash-Next Q2_0 [5]。
如果你有 M3 以上、macOS 26.4 以上的 Mac,而且需要同時處理多個請求,就先試 Splash:Strata 的 Mac 引擎一次只處理一個請求,Splash 的 README 則說它會自動批次處理併發請求 [4][10]。不需要併發的話,兩者都值得拿自己的 prompt 跑一輪。Strata 的 Mac 引擎在文件中仍標為 new,只測過三台 Mac [10]。這個判斷來自文件的差異,不是我在兩者之間跑出的比較。
接下來有幾件事可以觀察:Splash 是否納入 M1/M2 的原生 Metal kernel 提案(issue #131,目前仍 open [21]);ISTA 是否針對 medium 推理強度推出修正版 GGUF [17];Strata 的 Mac 引擎何時移除 new 標示。
本文的事實查證於 2026-10-27 完成,涵蓋兩個專案的 repo 與文件、Hugging Face 模型卡與討論串、相關論文,以及中文社群文章;Reddit、Hacker News 與獨立 benchmark 部落格未在範圍內,所以「沒找到獨立評測」只代表本次範圍內沒有。文中的 [n] 對應下列來源,「L1」為官方文件或原始碼,「L2」為論文與作者一手文章,「L3」為社群觀點,不代表官方說法。

 useKevin('front-end')

 iThome鐵人賽
 看影片追技術