
偵測到攻擊只是開始——真正的考驗是告警響起後的前 15 分鐘。
完成本日實作後,你將能夠:
本篇會實作完整的事件回應流程。建議的最低閱讀量:
| 等級 | 天數 | 內容 |
|---|---|---|
| 必備 | Day 1 | ATT&CK 概念 + 靶場部署 |
| 必備 | Day 25 | Falco 規則設計(IR 的告警來源) |
| 建議 | Day 24 | Kill Chain(理解攻擊鏈重建的背景) |
| 建議 | Day 14–15 | Stealth + Defense Impairment(攻擊者如何隱藏痕跡) |
| 可跳過 | Day 27–28 | 策略引擎 + 攻防矩陣(預防層,與 IR 流程獨立) |
快速路徑:如果時間有限,至少讀完 Day 1 → 25 → 本篇。
Day 25–27 我們建立了完整的偵測堆疊:Falco、Audit Log、Tetragon。但偵測只回答一個問題:「有攻擊正在發生。」
接下來的問題才是關鍵:
沒有 SOP(Standard Operating Procedure)的團隊,收到 Falco 告警後的典型反應是:先慌、再猜、最後 kubectl delete pod 刪掉了唯一的證據。
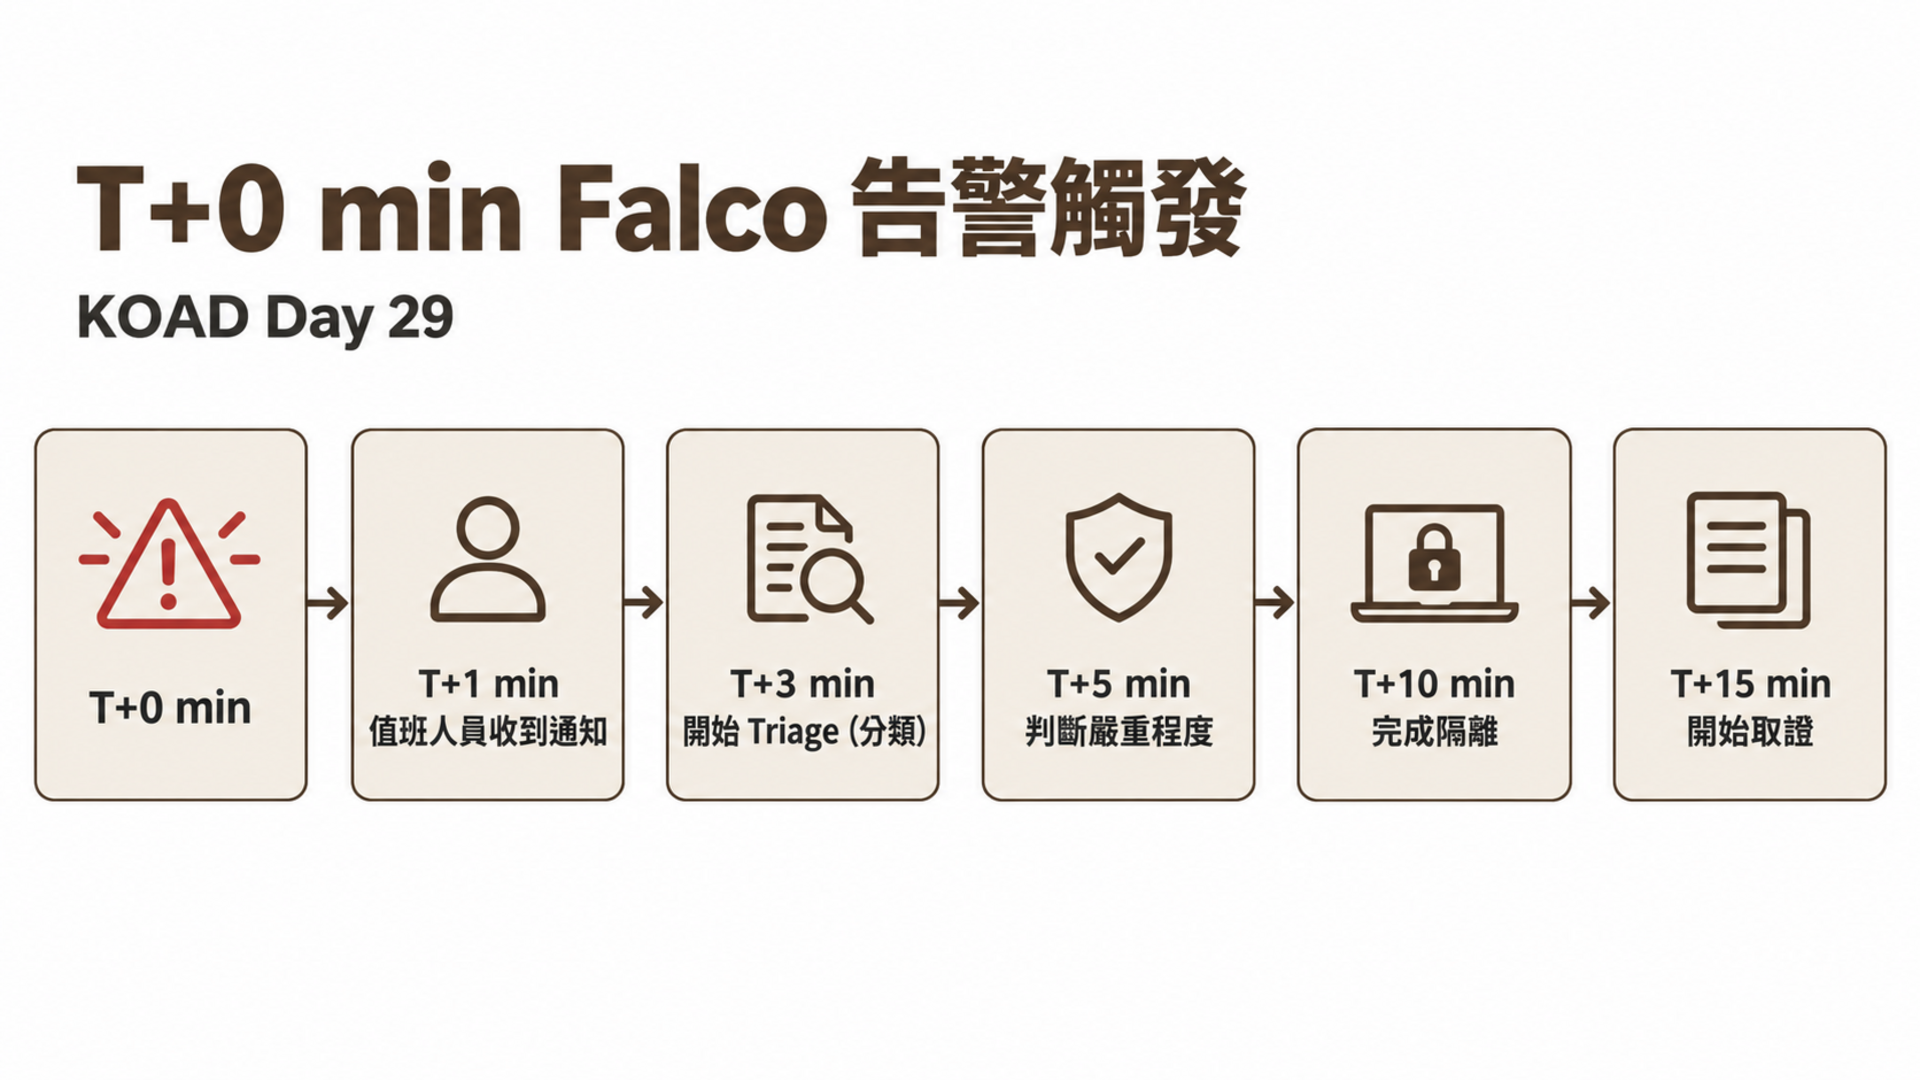
在 KOAD 攻擊鏈中,從 S01(SSRF)到 S35(挖礦)只需要 10 分鐘。如果 IR 慢於攻擊鏈的速度,攻擊者就已經完成整條鏈了。
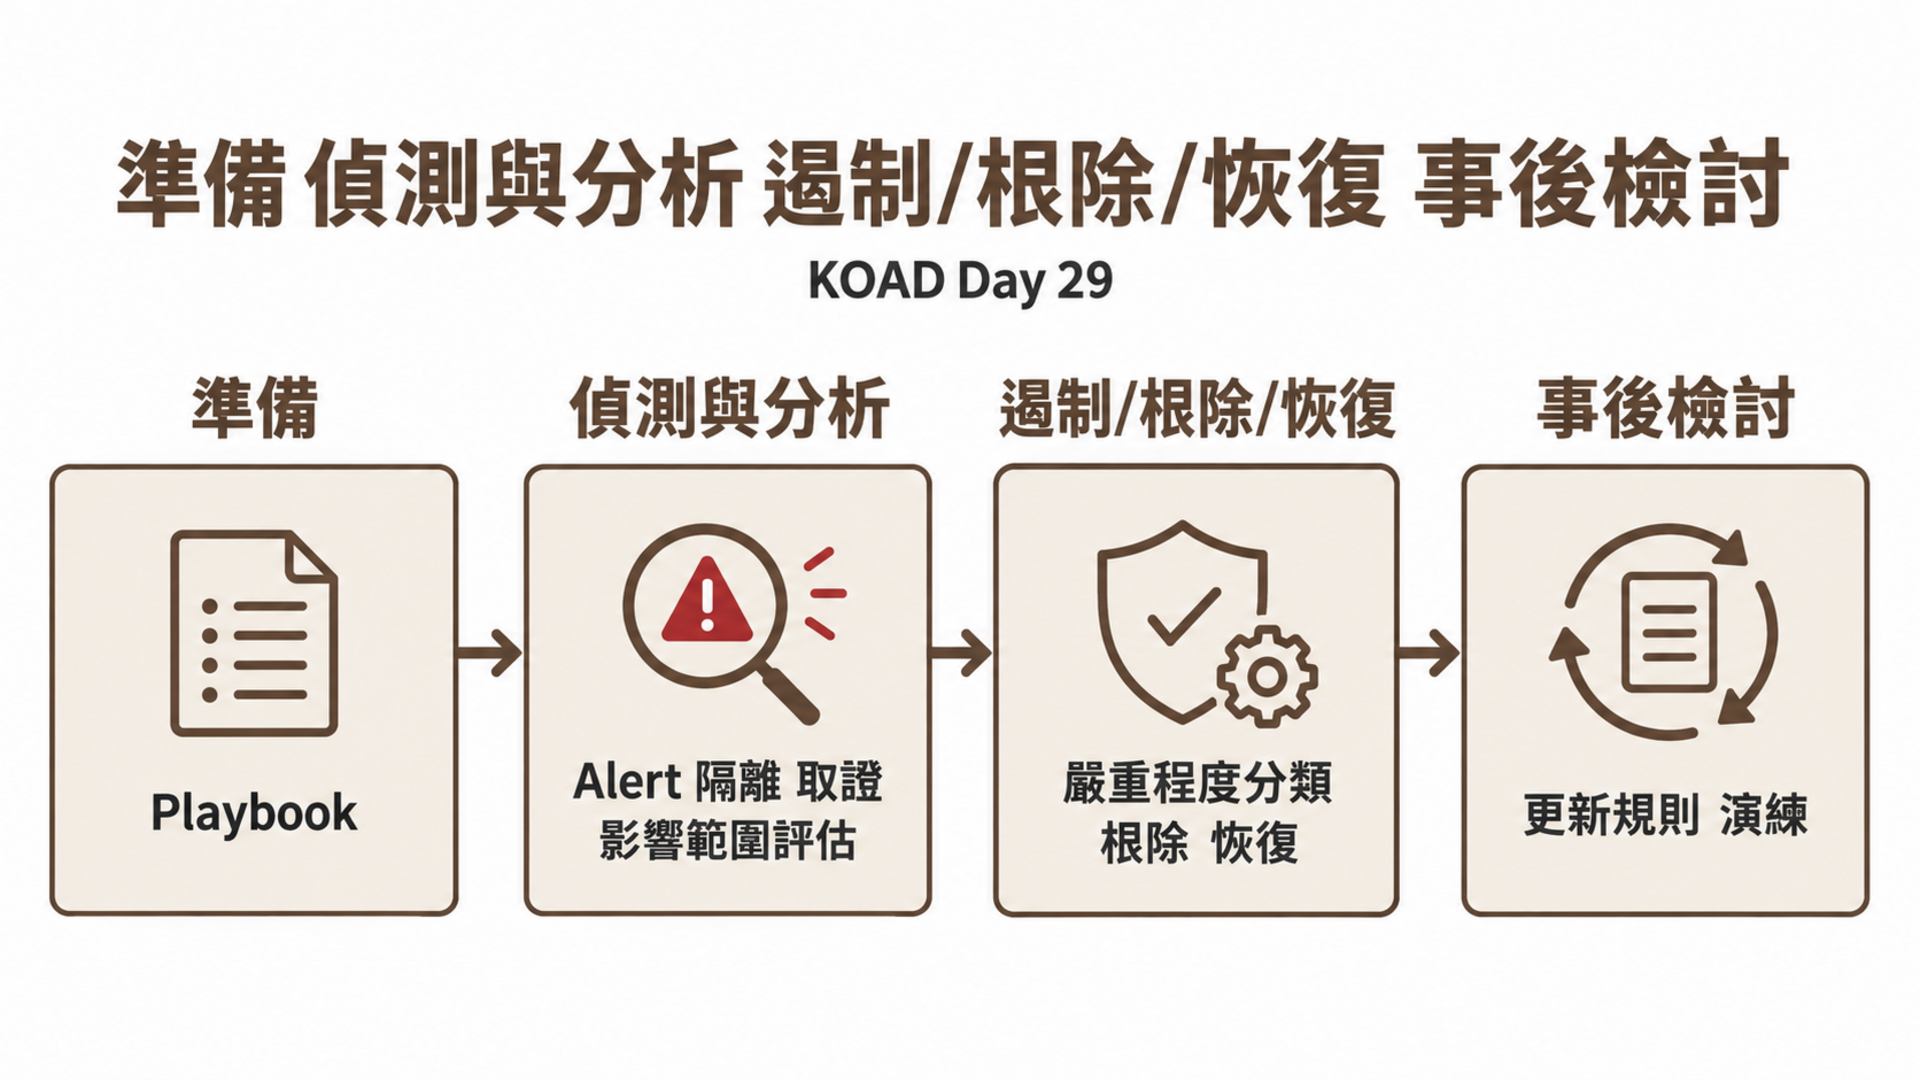
NIST SP 800-61 定義的 IR 四階段框架,套用到 K8s 環境:
在叢集內預先部署一個 IR 用的 Namespace 和工具 Pod:
apiVersion: v1
kind: Namespace
metadata:
  name: ir-toolkit
  labels:
    pod-security.kubernetes.io/enforce: privileged
---
apiVersion: v1
kind: Pod
metadata:
  name: ir-pod
  namespace: ir-toolkit
spec:
  serviceAccountName: ir-sa
  containers:
    - name: toolkit
      image: nicolaka/netshoot:latest
      command: ["sleep", "infinity"]
      securityContext:
        capabilities:
          add: ["NET_ADMIN", "SYS_PTRACE"]
      resources:
        limits:
          cpu: "500m"
          memory: "512Mi"
部署 IR 工具箱:
# 主機終端 — 部署 IR Namespace 和工具 Pod
kubectl apply -f ir-toolkit.yaml
預期結果:
namespace/ir-toolkit created
pod/ir-pod created
# 確認 IR Pod 運行中
kubectl get pod -n ir-toolkit
預期結果:
NAME     READY   STATUS    RESTARTS   AGE
ir-pod   1/1     Running   0          30s
IR 人員需要足夠的權限來調查,但不需要 cluster-admin:
apiVersion: v1
kind: ServiceAccount
metadata:
  name: ir-sa
  namespace: ir-toolkit
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: ir-investigator
rules:
  # 讀取 Pod 和相關資源
  - apiGroups: [""]
    resources: ["pods", "pods/log", "events", "secrets", "configmaps", "serviceaccounts"]
    verbs: ["get", "list", "watch"]
  # 在 Pod 內執行命令(取證)
  - apiGroups: [""]
    resources: ["pods/exec"]
    verbs: ["create"]
  # 讀取 Deployment 和相關資源
  - apiGroups: ["apps"]
    resources: ["deployments", "daemonsets", "replicasets"]
    verbs: ["get", "list"]
  # 讀取和建立 RBAC(調查 + 隔離)
  - apiGroups: ["rbac.authorization.k8s.io"]
    resources: ["*"]
    verbs: ["get", "list"]
  # 建立和管理 NetworkPolicy(隔離)
  - apiGroups: ["networking.k8s.io"]
    resources: ["networkpolicies"]
    verbs: ["get", "list", "create", "update"]
  # 讀取 Node 資訊
  - apiGroups: [""]
    resources: ["nodes"]
    verbs: ["get", "list"]
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata:
  name: ir-investigator
subjects:
  - kind: ServiceAccount
    name: ir-sa
    namespace: ir-toolkit
roleRef:
  kind: ClusterRole
  name: ir-investigator
  apiGroup: rbac.authorization.k8s.io
每個 Falco 規則對應一個 Playbook:
| Falco 規則 | 嚴重程度 | Playbook |
|---|---|---|
| Shell in Container | WARNING | 確認是否合法維護 → 不是 → 隔離 Pod |
| kubectl in Container | ALERT | 立即隔離 → 檢查 SA 權限 → 審計操作 |
| Privileged Container | CRITICAL | 立即隔離 → 檢查逃逸跡象 → 檢查 Node |
| SA Token Read | NOTICE | 記錄 → 比對是否正常讀取 |
| Cryptominer | CRITICAL | 立即隔離 → 刪除 Pod → 檢查映像來源 |
| RBAC Change | ALERT | 確認變更者身份 → 審計變更內容 → 必要時回滾 |
| Cross-NS Access | ALERT | 檢查 SA 權限 → 確認是否授權存取 → 隔離 |
□ IR Namespace 和工具 Pod 已部署
□ IR ServiceAccount RBAC 已配置
□ 每個 Falco 規則都有對應的 Playbook
□ 通知管道已設定(Slack / PagerDuty / Email)
□ 證據存放位置已準備(S3 bucket / NFS share)
□ 團隊成員知道 on-call 流程
□ 季度 IR 演練已排程
收到 Falco 告警後的前 5 分鐘流程:
# 主機終端 — 告警分類
# 1. 查看告警詳情
kubectl logs -n falco -l app.kubernetes.io/name=falco --tail=20 | \
  jq 'select(.rule | contains("KOAD"))' | \
  jq '{rule, priority, output, time}'

# 輸出範例:
{
  "rule": "KOAD S13 Privileged Container Started",
  "priority": "Critical",
  "output": "Privileged container started (user=root pod=attacker ns=koad image=koad/attacker)",
  "time": "2026-08-19T14:35:22.123456789Z"
}

# 2. 確認受影響的 Pod
SUSPECT_POD="attacker"
SUSPECT_NS="koad"

# 3. 取得 Pod 詳細資訊
kubectl get pod $SUSPECT_POD -n $SUSPECT_NS -o yaml

# 4. 確認 Pod 的 ServiceAccount 和權限
SA=$(kubectl get pod $SUSPECT_POD -n $SUSPECT_NS -o jsonpath='{.spec.serviceAccountName}')
echo "ServiceAccount: $SA"
kubectl auth can-i --list --as=system:serviceaccount:${SUSPECT_NS}:${SA}

# 5. 檢查近期 Events
kubectl get events -n $SUSPECT_NS --sort-by='.lastTimestamp' | tail -20
| 信號 | 嚴重程度 | 行動 | 回應時間 |
|---|---|---|---|
| Shell in known app pod | 低 | 記錄,確認是否正常 | 4 小時 |
| kubectl in any container | 高 | 立即調查 | 30 分鐘 |
| Privileged + mount 操作 | 危急 | 立即隔離,可能已逃逸 | 5 分鐘 |
| SA Token read + API 呼叫異常 | 高 | 檢查 Audit Log | 30 分鐘 |
| 跨 Namespace 存取 | 高 | 檢查橫向移動 | 15 分鐘 |
| 挖礦程式 / stress 工具 | 危急 | 立即隔離並刪除 | 5 分鐘 |
# 主機終端 — 影響範圍評估
# 攻擊者用了哪個 SA?能做什麼?
kubectl auth can-i --list \
  --as=system:serviceaccount:${SUSPECT_NS}:${SA} | head -30

# 這個 SA 有 cluster-admin 嗎?
kubectl get clusterrolebindings -o json | \
  jq -r '.items[] | select(.subjects[]?.name == "'$SA'" and
  .subjects[]?.namespace == "'$SUSPECT_NS'") | .roleRef.name'

# 最近有什麼 RBAC 變更?
kubectl get clusterrolebindings -o json | \
  jq '.items[] | select(.metadata.creationTimestamp > "2026-08-19T00:00:00Z") |
  {name: .metadata.name, role: .roleRef.name, subjects: .subjects}'

# 有沒有新建的 ServiceAccount?
kubectl get sa -A --sort-by='.metadata.creationTimestamp' | tail -10

# 有沒有新建的 Pod?
kubectl get pods -A --sort-by='.metadata.creationTimestamp' | tail -10

# 攻擊者建了哪些資源?(用 Audit Log)
grep "$SA" /var/log/kubernetes/audit/audit.log | \
  jq '{verb, resource: .objectRef.resource, name: .objectRef.name}' | \
  sort -u
# 主機終端 — 容器內部快速檢查
# 檢查可疑程式
kubectl exec -n $SUSPECT_NS $SUSPECT_POD -- ps aux

# 檢查網路連線
kubectl exec -n $SUSPECT_NS $SUSPECT_POD -- ss -tnp

# 檢查最近修改的檔案
kubectl exec -n $SUSPECT_NS $SUSPECT_POD -- \
  find / -newer /proc -type f 2>/dev/null | head -30

# 檢查已安裝的工具
kubectl exec -n $SUSPECT_NS $SUSPECT_POD -- \
  which nmap hydra curl wget kubectl 2>/dev/null
第一步不是刪除 Pod,而是隔離——保留證據的同時切斷攻擊者的通訊:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: isolate-suspect
  namespace: koad
  labels:
    purpose: incident-response
    incident-id: "IR-2026-0819-001"
spec:
  podSelector:
    matchLabels:
      app: attacker
  policyTypes:
    - Ingress
    - Egress
  # 完全隔離:不允許任何進出流量
# 主機終端 — 隔離受感染 Pod
# 套用隔離策略
kubectl apply -f isolate-suspect.yaml

# 驗證隔離生效
kubectl exec -n koad attacker -- curl -s --max-time 3 http://kubernetes.default.svc
# 應該超時——隔離成功

# 也可以用 label 快速隔離
kubectl label pod -n koad attacker quarantine=true
# 前提是已有 NetworkPolicy 選擇 quarantine=true 的 Pod
在刪除任何東西之前,先保留證據:
# 主機終端 — 證據保全(10 步取證)
# 建立證據目錄
INCIDENT_ID="IR-2026-0819-001"
EVIDENCE_DIR="/tmp/evidence/${INCIDENT_ID}"
mkdir -p ${EVIDENCE_DIR}

# 1. 匯出 Pod 完整 YAML
kubectl get pod $SUSPECT_POD -n $SUSPECT_NS -o yaml > ${EVIDENCE_DIR}/pod-spec.yaml

# 2. 匯出 Pod 日誌
kubectl logs $SUSPECT_POD -n $SUSPECT_NS --all-containers > ${EVIDENCE_DIR}/pod-logs.txt

# 3. 匯出容器內的檔案系統快照
kubectl exec $SUSPECT_POD -n $SUSPECT_NS -- \
  find / -newer /proc -type f 2>/dev/null > ${EVIDENCE_DIR}/modified-files.txt

# 4. 匯出 bash_history(如果還在)
kubectl exec $SUSPECT_POD -n $SUSPECT_NS -- \
  cat /root/.bash_history 2>/dev/null > ${EVIDENCE_DIR}/bash-history.txt

# 5. 匯出網路連線
kubectl exec $SUSPECT_POD -n $SUSPECT_NS -- ss -tnp > ${EVIDENCE_DIR}/network.txt

# 6. 匯出程式列表
kubectl exec $SUSPECT_POD -n $SUSPECT_NS -- ps auxef > ${EVIDENCE_DIR}/processes.txt

# 7. 匯出環境變數(可能包含 Token)
kubectl exec $SUSPECT_POD -n $SUSPECT_NS -- env > ${EVIDENCE_DIR}/env-vars.txt

# 8. 匯出 Audit Log 相關條目
grep "$SUSPECT_POD" /var/log/kubernetes/audit/audit.log > ${EVIDENCE_DIR}/audit-entries.json

# 9. 匯出 Falco 告警
kubectl logs -n falco -l app.kubernetes.io/name=falco | \
  grep "$SUSPECT_POD" > ${EVIDENCE_DIR}/falco-alerts.json

# 10. 保存時間戳和調查人
echo "Investigation started: $(date -u)" > ${EVIDENCE_DIR}/investigation-meta.txt
echo "Investigator: $(whoami)" >> ${EVIDENCE_DIR}/investigation-meta.txt
echo "Incident ID: ${INCIDENT_ID}" >> ${EVIDENCE_DIR}/investigation-meta.txt
驗證證據保全結果:
ls -la ${EVIDENCE_DIR}/
預期結果:
total 48
-rw-r--r-- 1 user user  2341 Aug 19 15:02 pod-spec.yaml
-rw-r--r-- 1 user user  8192 Aug 19 15:02 pod-logs.txt
-rw-r--r-- 1 user user   456 Aug 19 15:02 modified-files.txt
-rw-r--r-- 1 user user   234 Aug 19 15:02 bash-history.txt
-rw-r--r-- 1 user user   128 Aug 19 15:02 network.txt
-rw-r--r-- 1 user user   512 Aug 19 15:02 processes.txt
-rw-r--r-- 1 user user   384 Aug 19 15:02 env-vars.txt
-rw-r--r-- 1 user user 12800 Aug 19 15:02 audit-entries.json
-rw-r--r-- 1 user user  4096 Aug 19 15:02 falco-alerts.json
-rw-r--r-- 1 user user   128 Aug 19 15:02 investigation-meta.txt
10 個檔案全部到齊表示取證完成。如果某個檔案為空(例如 bash-history.txt),表示攻擊者已清除痕跡——這本身也是重要的證據。
如果需要更深入的取證,可以用 crictl 對容器做完整快照:
# Node 上(SSH 或 nsenter)
# 找到容器 ID
CONTAINER_ID=$(crictl ps | grep attacker | awk '{print $1}')

# 匯出容器的完整 rootfs
crictl export $CONTAINER_ID > ${EVIDENCE_DIR}/container-rootfs.tar

# 匯出容器的 checkpoint(包含記憶體狀態)
crictl checkpoint --export=${EVIDENCE_DIR}/checkpoint.tar $CONTAINER_ID
# 主機終端 — 根除攻擊
# 1. 刪除可疑 Pod
kubectl delete pod $SUSPECT_POD -n $SUSPECT_NS --grace-period=0 --force

# 2. 移除攻擊者建立的 RBAC
kubectl get clusterrolebindings -o json | \
  jq -r '.items[] | select(.subjects[]?.name == "backdoor-sa") | .metadata.name' | \
  xargs -I{} kubectl delete clusterrolebinding {}

# 3. 刪除後門 ServiceAccount
kubectl delete sa backdoor-sa -n $SUSPECT_NS

# 4. 刪除攻擊者建立的 CronJob
kubectl delete cronjob -n $SUSPECT_NS -l koad-scenario=attacker-chain

# 5. 檢查並移除惡意 MutatingWebhookConfiguration
kubectl get mutatingwebhookconfigurations | grep -v kyverno

# 6. 檢查是否有惡意映像在叢集中
kubectl get pods -A -o jsonpath='{range .items[*]}{.metadata.namespace}/{.metadata.name}: {.spec.containers[*].image}{"\n"}{end}' | \
  grep -v -E '(registry\.k8s\.io|docker\.io/library|quay\.io)'
# 主機終端 — 恢復服務
# 1. 確認安全工具仍在運行
kubectl get pods -n falco
kubectl get pods -n kyverno
預期結果:
NAME                     READY   STATUS    RESTARTS   AGE
falco-xxxxx              2/2     Running   0          3h
kyverno-xxxxx            1/1     Running   0          3h
# 2. 將 Kyverno 從 Audit 切換到 Enforce(如果確認安全)
kubectl patch cpol koad-block-privileged -p \
  '{"spec":{"validationFailureAction":"Enforce"}}'
預期結果:
clusterpolicy.kyverno.io/koad-block-privileged patched
# 3. 確認 NetworkPolicy 正常
kubectl get networkpolicies -n koad

# 4. 移除 IR 用的臨時 NetworkPolicy
kubectl delete networkpolicy isolate-suspect -n koad
預期結果:
networkpolicy.networking.k8s.io "isolate-suspect" deleted
# 5. 檢查受影響 Namespace 的服務恢復
kubectl get pods -n koad
kubectl get svc -n koad

# 6. 運行 kube-bench 確認叢集安全基線
kubectl apply -f kube-bench-job.yaml
| 時間 | 事件 | 來源 |
|------|------|------|
| 14:30 | SSRF 漏洞被利用 | Web 日誌 |
| 14:31 | Metadata API 憑證洩漏 | Falco S01 |
| 14:32 | kubectl 在容器內執行 | Falco S05 |
| 14:33 | ClusterRoleBinding 建立 | Audit Log |
| 14:35 | 特權 Pod 部署 | Falco S13 + Kyverno |
| 14:37 | 容器逃逸成功 | Falco S13 |
| 14:40 | 挖礦程式啟動 | Falco S35 + Prometheus |
| 14:45 | IR 團隊收到告警 | PagerDuty |
| 14:50 | Pod 隔離 | NetworkPolicy |
| 15:00 | 證據保全完成 | 手動 |
| 15:10 | 攻擊清除完成 | 手動 |
| 發現 | 改善 | 負責人 | 時限 |
|---|---|---|---|
| SSRF 漏洞未修補 | 修補 + WAF 規則 | 開發團隊 | 1 天 |
| SA 權限過大 | 最小權限 RBAC 重構 | 平台團隊 | 1 週 |
| Kyverno 在 Audit 模式 | 切到 Enforce | 安全團隊 | 3 天 |
| 無自動隔離 | 部署 Falco Talon | 安全團隊 | 2 週 |
| IR 流程靠人工 | 自動化 Runbook | 安全團隊 | 1 個月 |
# Incident Report: IR-2026-0819-001

## 摘要
攻擊者利用 SSRF 漏洞取得雲端 Metadata API 的 ServiceAccount Token,
透過 kubectl 提權到 cluster-admin,部署特權容器逃逸至宿主機,
最終部署挖礦程式。

## 時間軸
(如上表)

## 影響
- 1 個 Node 被逃逸控制
- 估計挖礦消耗 40 分鐘 × 4 CPU = 2.67 CPU-hours
- 無資料外洩(Metadata API 的 Token 已過期)

## 根因
1. Web 應用存在 SSRF 漏洞
2. ServiceAccount 權限過大(可 create clusterrolebindings)
3. Kyverno 在 Audit 模式,未阻擋特權容器

## 改善措施
(如上表)

## 教訓
- 偵測到告警後 5 分鐘內應完成隔離
- NetworkPolicy default-deny 應優先部署
- Kyverno 應儘快從 Audit 切到 Enforce
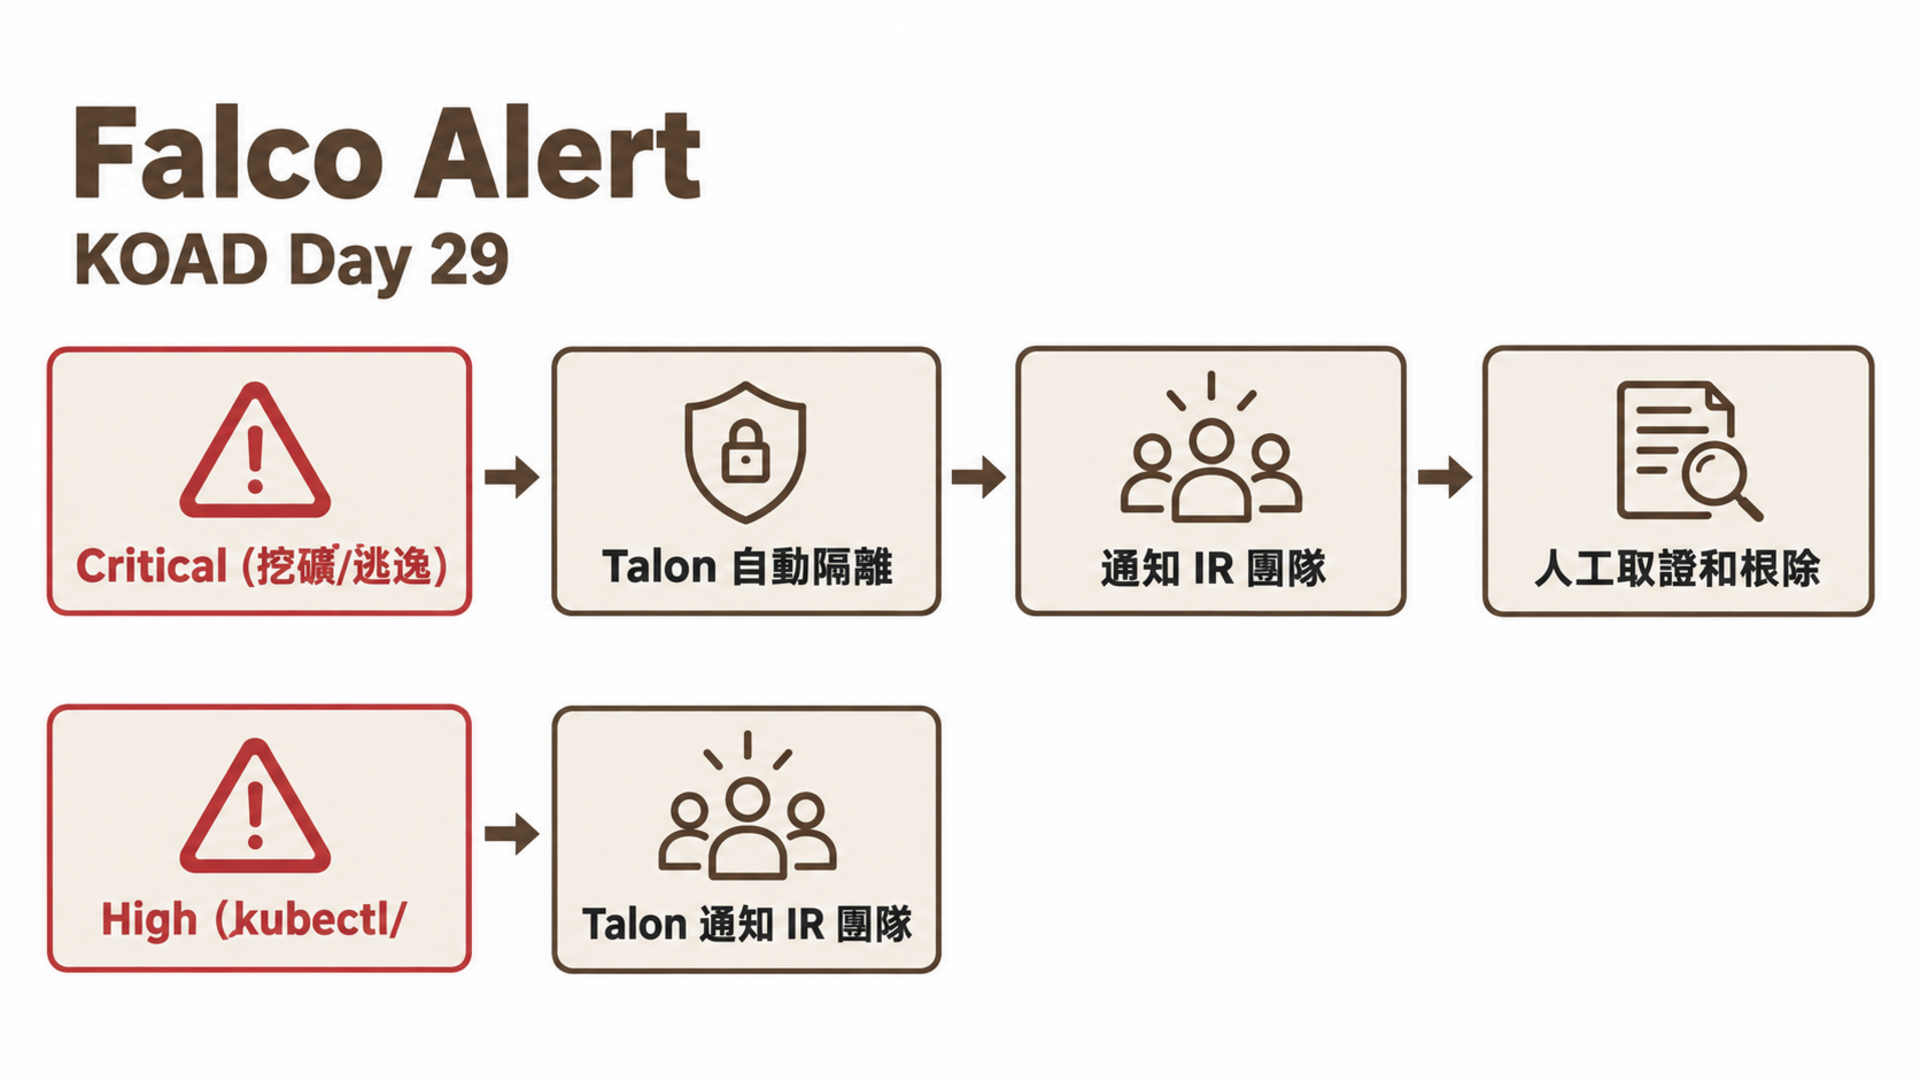
手動 IR 太慢——Falco Talon 可以在告警觸發的瞬間自動執行回應動作:
# falco-talon/ir-auto-response.yaml
- name: Auto-isolate critical threats
  match:
    rules:
      - KOAD S13 Privileged Container Activity
      - KOAD S35 Cryptocurrency Miner Detected
    priority: critical
  actions:
    - action: NetworkPolicy isolation
      parameters:
        allow: ["dns"]
    - action: Label pod
      parameters:
        labels:
          security.koad/isolated: "true"
          security.koad/reason: "auto-response"
          security.koad/timestamp: "{{.Timestamp}}"
| 場景 | 建議 | 原因 |
|---|---|---|
| 挖礦偵測 | 自動隔離 | 確定是惡意,延遲 = 浪費資源 |
| 特權容器 | 自動隔離 | 逃逸風險太高 |
| Shell in container | 手動確認 | 可能是合法維護 |
| SA Token 讀取 | 記錄 | 誤報率高 |
| RBAC 變更 | 告警 + 手動 | 可能是正常操作 |
KOAD 的攻擊鏈就是最好的 IR 演練工具:
# 主機終端 — IR 演練
# 1. 執行攻擊鏈
kubectl exec -n koad attacker -- bash /attack/attack-chain.sh

# 2. 假裝你不知道攻擊發生——只從 Falco 告警開始調查
kubectl logs -n falco -l app.kubernetes.io/name=falco --tail=50

# 3. 按 IR SOP 執行:Triage → 隔離 → 取證 → 根除 → 恢復

# 4. 寫事後檢討報告

# 5. 計時:從告警到完成隔離花了多久?
| 指標 | 目標 | 說明 |
|---|---|---|
| MTTD(偵測時間) | < 1 分鐘 | 從攻擊發生到收到告警 |
| MTTR(回應時間) | < 15 分鐘 | 從告警到完成隔離 |
| 證據完整度 | 8/10 項 | 10 項取證步驟完成幾項 |
| 根因識別 | 正確 | 是否正確識別攻擊入口和路徑 |
| 改善行動 | ≥ 3 項 | 提出多少可執行的改善措施 |
每季度做一次這樣的演練,IR 能力會顯著提升。
| 考點 | 本日內容 | 權重 |
|---|---|---|
| Audit Log 分析 | 從 Audit Log 追蹤攻擊 | Monitoring 20% |
| Runtime 偵測 | Falco 告警分析 | Monitoring 20% |
| NetworkPolicy | 隔離策略 | Cluster Setup 15% |
| RBAC 審計 | 檢查異常 RBAC 變更 | Cluster Hardening 15% |
kubectl auth can-i --list --as=... 是常考命令| 問題 | 原因 | 解法 |
|---|---|---|
kubectl get events 無輸出 |
Events 預設保留 1 小時,已過期 | 改用 Falco 日誌或 Audit Log,它們有持久儲存 |
kubectl cordon 後 Pod 仍在運行 |
cordon 只阻止新 Pod 排程到該 Node | 需另外 kubectl drain <node> 或手動刪除 Pod |
kubectl exec 進入隔離 Pod 失敗 |
NetworkPolicy 也阻擋了 API Server 到 Pod 的流量 | 在 NetworkPolicy 中加入允許 API Server CIDR 的 Ingress 規則 |
| Audit Log 檔案為空或不存在 | API Server 未啟用 Audit 或路徑配置錯誤 | 檢查 --audit-policy-file 和 --audit-log-path 參數是否正確掛載 |
jq 解析 Falco 日誌出錯 |
Falco 輸出混合了 JSON 和純文字行 | 加上 grep "^{" | jq ... 先過濾非 JSON 行 |
| IR Pod 無法存取其他 Namespace | ir-sa 的 ClusterRoleBinding 未建立 | 確認 kubectl get clusterrolebinding ir-investigator 存在 |
crictl checkpoint 失敗 |
容器 runtime 不支援 checkpoint(如 Docker) | 使用 containerd 1.6+ 或改用 crictl export 匯出 rootfs |
| 面向 | KOAD 靶場 | 真實生產環境 |
|---|---|---|
| 證據保存 | 可以隨時重建環境 | 必須保存證據鏈(Chain of Custody),不能隨意重啟 |
| 影響範圍 | 僅影響本機 Lab | 可能影響客戶資料、營運、法規遵循 |
| 團隊協作 | 一個人練習 | 需要 SOC + IR Team + 法務 + 管理層協作 |
| 時間壓力 | 無 | 法規可能要求 72 小時內通報(如 GDPR) |
KOAD 的 IR 練習讓你熟悉技術流程。真實事件中,技術只是一部分——溝通、證據保存和法規遵循同樣重要。
明天 Day 30 是最後一篇——KOAD 開源、30 天技術總回顧、以及「資安這條路」的下一站。


 iThome鐵人賽
 看影片追技術