

回頭看這套便當系統,很容易得到一個過度簡單的答案:早知道就把身份、帳務、歷史、測試與部署全部先做好。
但這和系列前半段真正發生的事不符。很多需求只有在系統被使用後才看得見,第一版若先預建所有可能性,反而會失去快速驗證的價值。
所以這篇不再逐項重講前面的機制,只留一個重做時最想提早問的問題:
現在不留下來,未來還能不能可靠地重建?
前面的案例可以縮成兩類。
| 類型 | 代表例 | 為什麼要早留 |
|---|---|---|
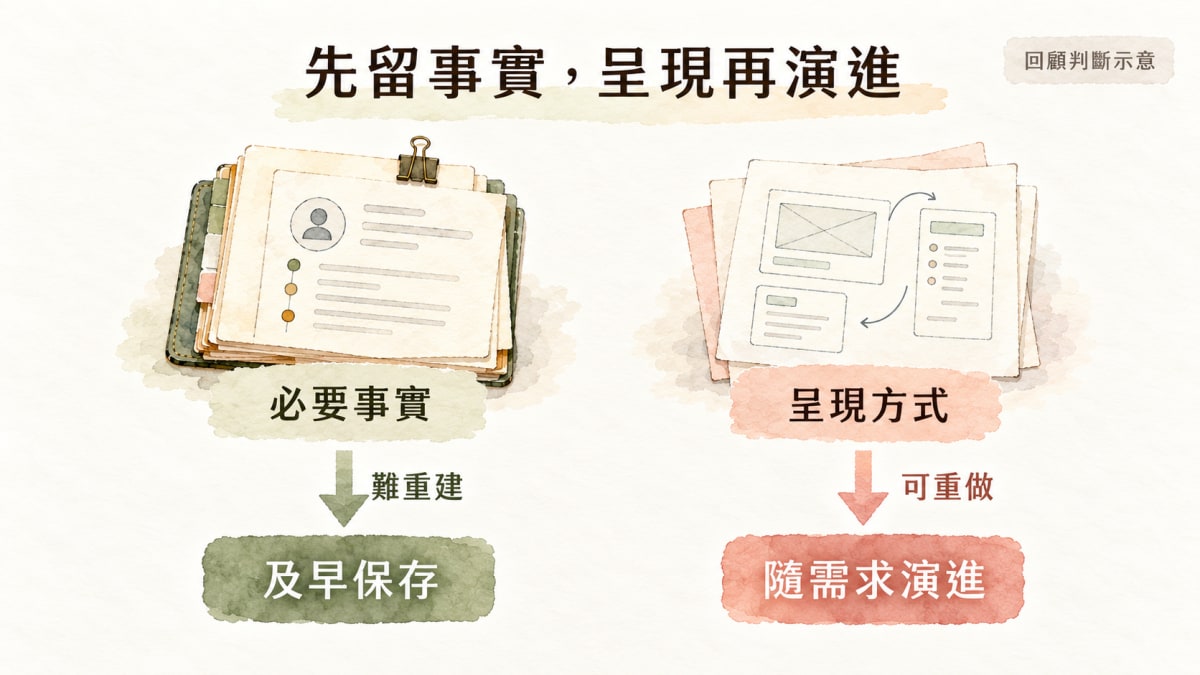
| 歸屬與事件事實 | 訂單屬於誰、誰執行代點、哪筆金額異動真的發生 | 事後只看畫面或目前值,很難可靠還原 |
| 當時未知的歷史 | 舊交易沒有收款方式、歷史菜單沒有原圖 | 後來可以新增欄位,卻不能把今天的推論寫成昨天的事實 |
Day 27 的 topup_method migration 就是一個很乾淨的例子:新交易開始要求結構化收款方式,舊資料不知道的部分仍保留 NULL。儲值方式 migration
這裡真正值得提早設計的,不是完整付款系統,而是不要把日後無法重建的事實丟掉。
另一類東西則不同。
Vendor Hub 長什麼樣、訂單管理要不要三個分頁、菜單圖片要不要點開放大,這些都可以在資料與責任已存在的前提下重新設計。
它們很重要,但通常不是「今天不決定,明天就永遠不知道」的資訊。
因此重做時,我會把優先順序放在:
先保存難以重建的事實與歸屬
↓
再讓可逆的呈現方式隨真實需求演進
這不是叫所有專案先做大型 Domain Model;只是把不可逆資訊和可逆介面分開看。
測試、環境辨識與部署邊界前面都已經完整談過,這裡只保留同一個判斷方式。
某條規則一旦出錯會傷到訂單、金額、歷史或正式資料,就值得留下可重跑的檢查或明確操作邊界。反過來,還沒有真實風險的自動化與抽象,不需要因為「以後可能用到」就一次建滿。
這能避免兩個極端:
AI 能很快補畫面、加欄位、改流程,因此「做得到」越來越不是稀缺資源。
比較值得提早留下的是判斷:
如果答案是「很難重建」,就早一點保存;如果答案是「資料還在,呈現可以重做」,就讓它隨使用演進。
這才是我從前面二十多天真正想帶回第一天的東西。
這是一套持續開發中的便當訂購系統。文章著重「為什麼」,GitHub 保留實際程式碼、文件與演進紀錄。
GitHub:https://github.com/henryfir456/bento-order-app
最後一天會回到最初那個生活需求:想讓訂便當方便一些,最後究竟留下了哪些能持續使用的工程判斷?


 iThome鐵人賽
 看影片追技術