

整理這個 Repository 的文章流程時,問題很容易被描述成「執行模型需要更會讀規則」。
但 2026-09-27 的架構提案指出更具體的摩擦:寫作入口還會再轉去強化或審稿;不同階段重複要求上下文與系列盤點;必要的獨立審查,和不必要的重複讀取,混在同一條工作路徑裡。
提案比較了三個方向:
| 方案 | 想處理什麼 | 當時保留的限制 |
|---|---|---|
| 縮短、拆分既有文件 | 減少部分重複 | 執行者仍須自行找來源與選路 |
| 產生可查核的任務工作包 | 先解析任務,再交付適用規則與證據 | 必須另建來源有效性、範圍與狀態契約 |
| 完整流程引擎與資料庫 | 管理大量任務和併發 | 尚無證據支持新增這麼大的系統 |
提案選擇先試一個小範圍的工作包方案。Repo 也留下編譯與驗證原型,但狀態仍是影子試行(shadow),沒有取代正式文章流程,更沒有證明總成本已下降。
這個選擇比「再加一個 Agent 讀文件」更值得保留:先辨認是哪種責任缺口,再選一個能直接處理它的層級。
架構決策階梯(Architecture Decision Ladder)用來選擇最小合適的介入,不是要求專案一路升到 Multi-Agent。
| 層級 | 什麼情況值得考慮 | 不足以解決什麼 |
|---|---|---|
| Prompt | 一次性任務的目標或輸出不清楚 | 不能長期保存跨 Session 的有效狀態 |
| Context | 所需事實、狀態或決策無法重新取得 | 資料齊全仍不代表檢查會穩定執行 |
| Tool | 問題有明確、可重複檢查的答案 | 不能只靠欄位完整就判斷證據真實 |
| Skill | 同一套有界能力反覆使用且可驗收 | 不替每個產品決定本地政策 |
| Workflow | 步驟與分支已足夠穩定 | 不把未知狀態硬塞進成功路徑 |
| Evaluator | 需要對照原始要求,判斷語意與品質 | 另一份沒有依據的同意不增加證據 |
| Multi-Agent | 工作可分開、獨立上下文有必要,且值得協調 | 無法補出不存在的來源或授權 |
這張表是診斷順序,不是必裝清單。也不必先建滿六層,才有資格平行工作;選擇應由具體失效、依賴與現有能力決定。
工作包原型把一些檢查寫成程式:系列與 Day 是否符合、輸出路徑是否在允許範圍、來源的內容雜湊是否仍相同、編譯時的狀態是否已過期。
測試原始碼也定義了一個反例:建立工作包後改變來源,再要求驗證器拒絕那份過期工作包。這是 Repo 中可查核的檢查契約;本輪沒有執行測試,因此不報 fresh PASS。
但原型程式開頭就限制了自己的責任:文章主論點、證據是否足夠、前後篇是否越界,仍須獨立審查。欄位與雜湊通過,不能讓尚待重查的事件變成已驗證事實。
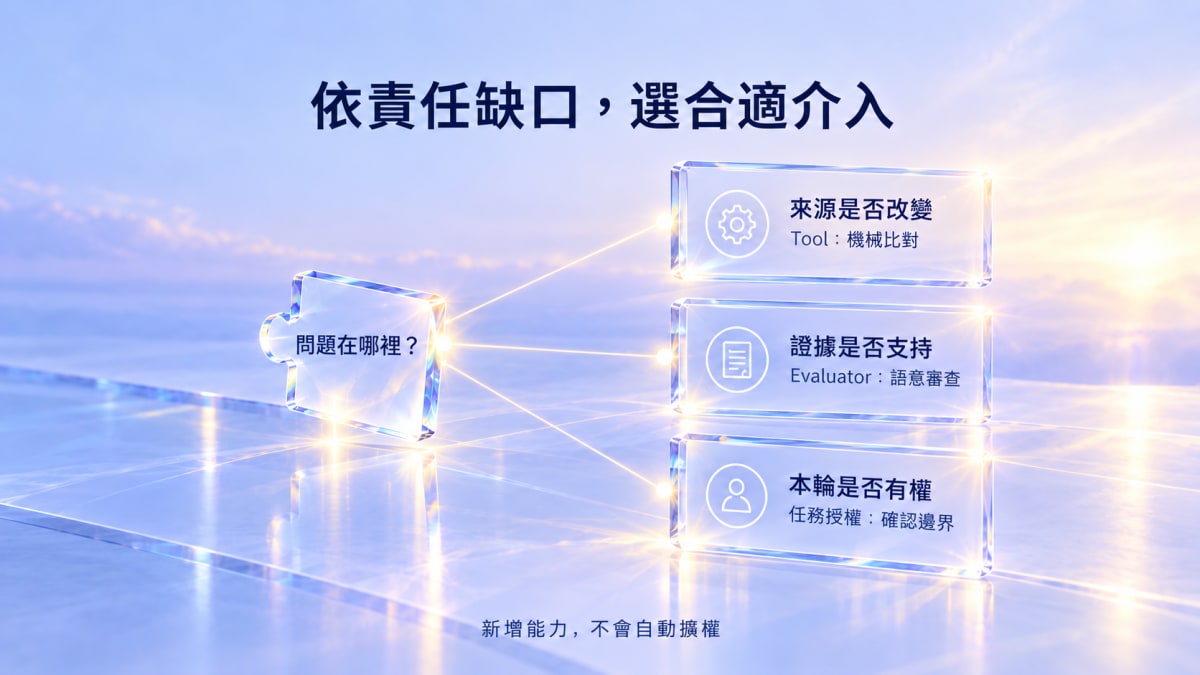
這個切分沒有把所有問題交給同一種工具:
來源是否改變 → 可機械比對
證據能否支持文章判斷 → 需要帶來源的語意審查
本輪是否有權改文章 → 仍由任務授權決定
如果只是缺少來源檔案,增加評估者不會讓資料憑空出現。若是文章論證不成立,重跑雜湊檢查也不會把它修好。
每增加一層,先留下四個答案:
在上述提案裡,完整引擎沒有被當成預設終點;先以限定任務檢查工作包契約。這不是已證明最省錢的架構,只是把尚未證明必要的複雜度留在外面。
Day 25、Day 26 還有未完成的成本量測,也提醒這裡不能把「用了較少層」直接換成「端到端一定更快」。
GPT‑6 系列指南把 model、reasoning effort、tool、Skill 與工作流程都視為可按 workload 調整的選擇。這能替 Architecture Decision Ladder 增加一個重要限制:同一個責任層,也可能只需要換執行配置,而不是再升一層架構。
例如:
問題:小幅編輯太慢
→ 先看 model / reasoning / speed

問題:重複檢查每次都靠模型猜
→ 再看 deterministic tool

問題:同一能力跨任務重複出現
→ 再看 Skill

問題:步驟與分支穩定、需要可靠收尾
→ 再看 Workflow

問題:工作真的能獨立切分,而且協調成本值得
→ 才看 Multi-Agent
所以 Ladder 回答的是「哪一種工程責任最適合處理失效」;model / reasoning routing 回答的是「在這個責任裡,用什麼執行配置比較合適」。兩者正交,不應該把換模型誤寫成治理升級,也不應該因為最強模型能做更多,就跳過 Tool、Skill 或 Workflow 的責任判斷。
有些問題用一段清楚的要求就能解決;有些產品權限需要正式決策,不能因為 Prompt 看似比較輕,就省略授權。
因此,這張階梯只選擇處理問題的方法,不提高 Agent 的權限。升級工具、增加評估者或多開 worker,都不會自動取得 commit、部署或資料修改的許可。
反方向也一樣。Day 28 的文件合併顯示,可以在保留受查控制的前提下縮短入口;它沒有要求把正本規則或必要審查一起撤掉。若新工具能承擔既有責任,可以重新評估重複步驟,但要保留對照證據。
這個系列的架構不必固定在某一層。比較值得固定的,是每次選擇都有可查的理由:問題在哪裡、既有方法少了什麼、新方法要證明什麼,以及失敗時停在哪裡。
最後一篇不再增加工具或層級,而是把這些選擇收成一個問題:人憑什麼逐步把更多工作交出去,同時仍知道什麼時候需要介入?


 iThome鐵人賽
 看影片追技術