

這個系列一路遇到的問題看起來不同:驗證只跑到較窄的 fallback、工具有部署能力但當次沒有部署授權、單一步驟成功卻沒有把後續狀態一起收尾。
它們最後都指向同一件事:
不能因為 Agent「會做」或「做過一次」,就把信任擴張到另一個情境、動作或完成聲明。
所以最後一天不再逐篇重講 Context、Authority、Evidence 與 Attention,而是把它們收成一份可以交付的信任契約。
| 面向 | 交付時要回答什麼 |
|---|---|
| Context | 這次依據哪個狀態、版本與目標?什麼變化會讓它失效? |
| Authority | 這次允許哪些動作與副作用?哪些仍需新授權? |
| Evidence | 哪些結果已被支持?哪些檢查沒跑或只跑到較窄範圍? |
| Attention | 哪個缺口可以先補事實,哪個真的需要人做政策或風險決定? |
把四個答案放在一起,才有資格談「下一次能不能少問一點、做多一點」。
它們不是四套獨立治理流程,而是一筆交付紀錄的四個欄位。
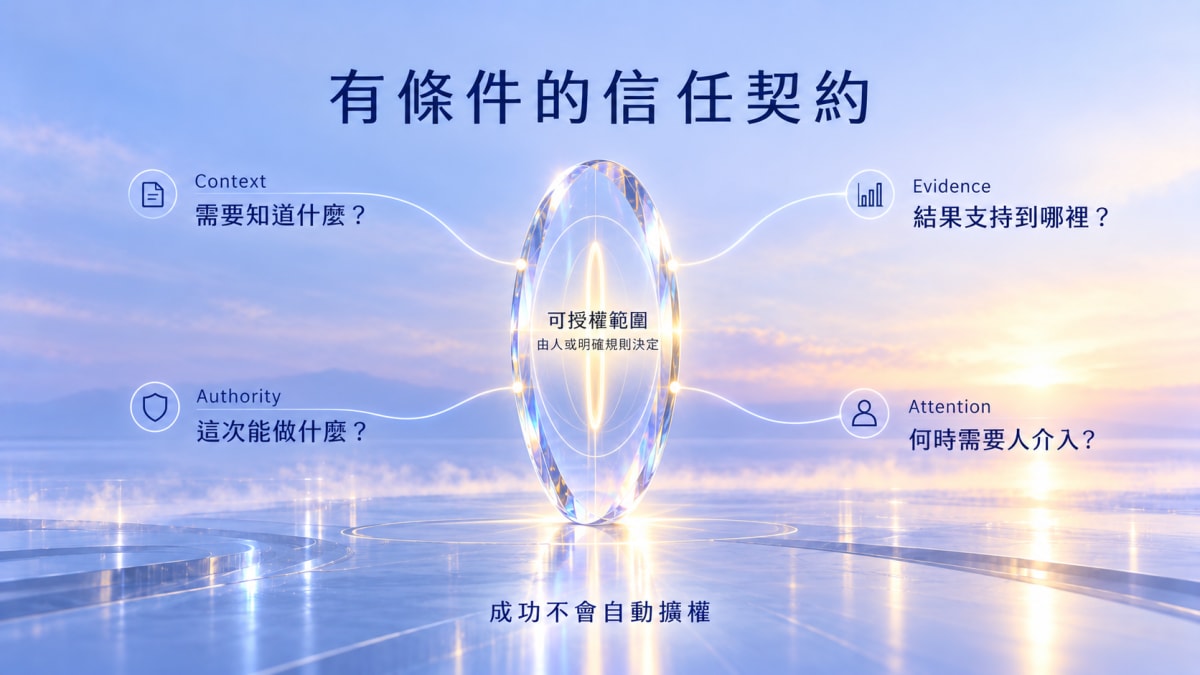
一個可操作的信任紀錄可以很小:
依據狀態:哪個版本、來源、環境與目標
允許動作:這次可做什麼,排除什麼
完成證據:實際驗證與未驗證部分
介入條件:何時繼續、補證、詢問或停止
如果下一次任務的狀態、目標與風險都沒有改變,這份紀錄可以減少重建成本。
但只要條件變了,就必須重新判斷。成功不會自動把 local authority 變成 production authority,也不會把 targeted PASS 變成 full verification。
這也是 Progressive Trust 的限制:信任擴大的不是 Agent 身分,而是某一類條件已經穩定、可重建、可驗證的工作。
OpenAI 的 GPT‑6 系列指南把完成寫成持續動作:實作、執行、檢查、修正,並把需要人決定的邊界另外標出。
在這個系列裡,可以把它收成:
Implement
→ Run
→ Inspect
→ Fix
→ 若出現新的產品/權限/不可逆決策,Ask Human
→ 否則在既有授權內繼續
這不是要求 Agent 永遠少問,而是要求「何時問」有理由。
D25 的 multi-agent 效率與 D26 的 human reconstruction cost 目前仍缺實測;D28 的治理文件縮減也只證明文字責任被重新定位,沒有證明完整行為等價。最後一篇仍保留這些未知,不把系列收尾寫成全部成果已通過。
公開的 Agent Governance Bootstrap 可以作為實作入口:先盤點 Repository 的現況、規則與未知,再提出最小方案;需要修改時,再進入實作與驗證。
它不是自動授權引擎,也不證明任何 Repository 採用後就更快或更安全。
真正能帶走的只有一個判斷循環:
知道目前依據什麼
→ 在明確授權內行動
→ 用證據限制完成聲明
→ 只把真正需要決策的缺口交給人
→ 條件改變時重新判斷
模型、工具與流程都可以換;這個循環的價值,是讓「信任」不再只是 Yes / No。
最後留下的問題也很簡單:
它知道什麼?這次能做什麼?憑什麼相信結果?什麼時候需要我介入?


 iThome鐵人賽
 看影片追技術