

終於來到第 30 天了。
第一天開始這個系列時,我想做的事情其實很簡單:有時候讀教材,明明每個字都看得懂,公式也知道怎麼代,但還是不太清楚它到底在描述什麼。如果能直接看到變化,甚至自己去調整條件,理解起來是不是會比較容易?
現在有 ChatGPT,遇到看不懂的東西可以直接問,也可以要求它舉例或畫圖。但我在意的是另一件事:能不能讓 AI 不只解釋一個概念,而是幫我們建立一個可以反覆探索的學習環境?
這就是 Visual Learning Lab 最初的想法。
前面 29 天,我從簡單的 PDF 分析頁面開始,慢慢加入概念關係、來源追溯、數學模型、互動操作,再處理 AI 產生錯誤資料、使用者操作不直覺、公開部署與成本控制等問題。
今天不再增加功能,想把這 30 天真正做出的東西整理一次,也談談哪些地方還沒有做到。
Visual Learning Lab 的核心流程是:
上傳教材 → AI 理解內容 → 建立視覺化模型 → 操作與探索 → 回到原始教材。
跟第一天相比,現在的系統已經有四個主要工作區:
| 工作區 | 功能 |
|---|---|
| Learn | 教材重點、概念解釋與學習引導 |
| Source | 查看原始 PDF、來源位置與相關概念 |
| Explore | 操作圖形、模型和參數,觀察變化 |
| Practice | 練習題、回答檢查與複習 |
這四個區域不是各自獨立的網頁,而是盡可能圍繞同一份教材及其概念建立關聯。
例如,我們可以先在 Source 找到一個物理概念,再開啟 Explore 裡已經建立好的互動模型,修改參數,最後回到原本那一頁,確認模型究竟對應教材中的哪個內容。
以目前準備好的簡諧運動教材為例。
教材裡有一個原始條件,振幅為 3。系統會保留這個來源資訊,同時提供可以調整的探索參數。
當我們把探索中的振幅改成 2.90,相關的數值與圖形會跟著變化。重新返回 Source 時,原本教材的內容仍然保持不變。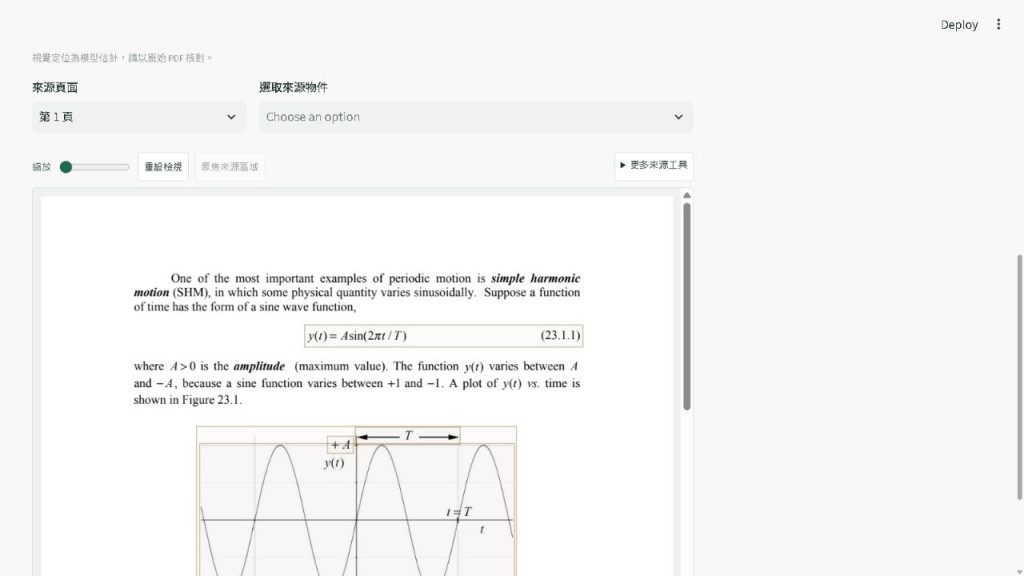
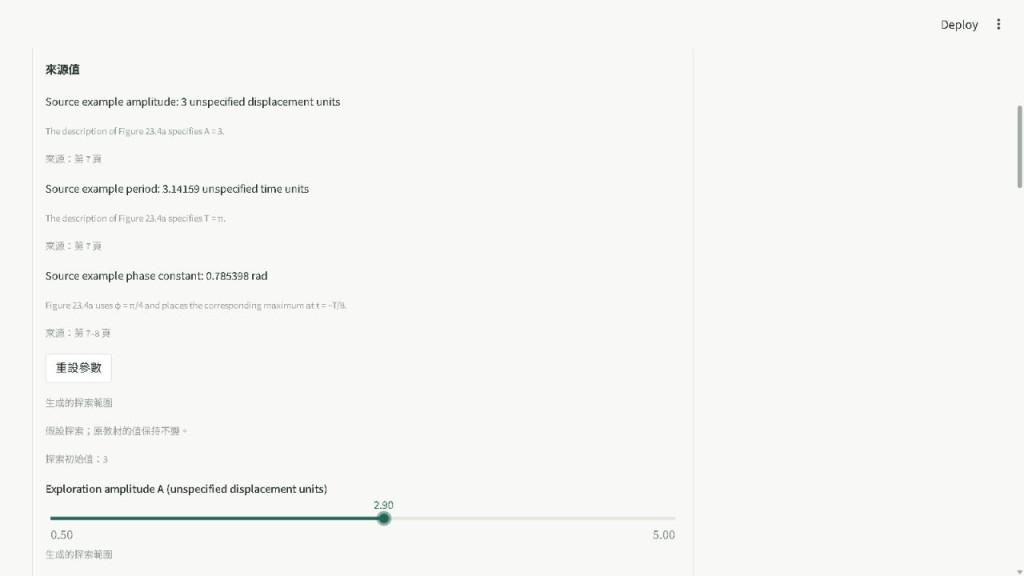
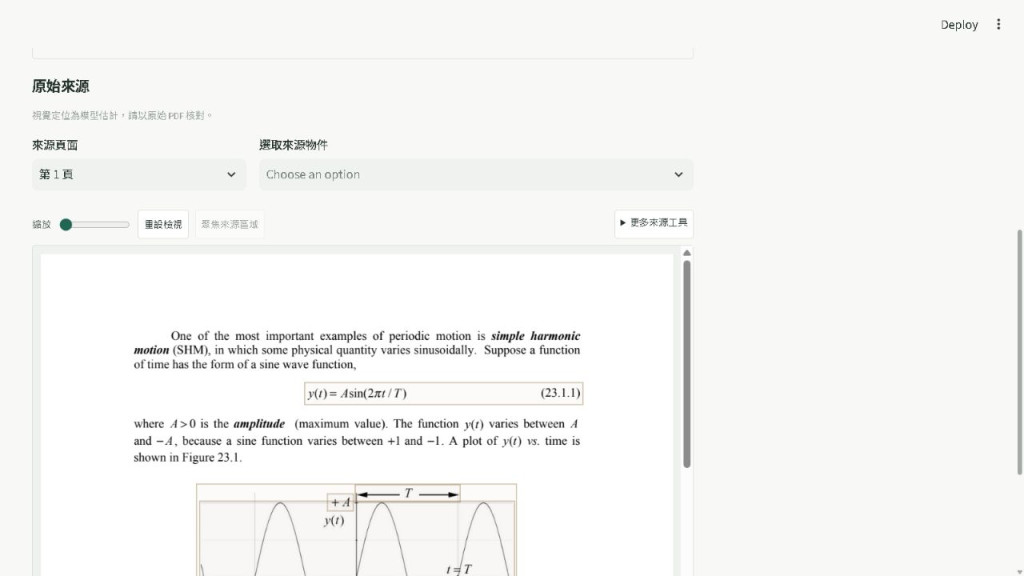
這個小小的操作,其實代表了我後期最在意的設計。
「教材原本寫了什麼」和「我現在想試什麼」應該是兩件不同的事。
如果 AI 把教材中的固定數字直接當成任意可調的參數,雖然畫面可能會動,卻容易讓使用者誤以為那就是作者原本的意思。
而且,上面這個操作是在模型已經建立好的前提下進行。調整振幅、切換檢視及返回來源,不需要每次都重新向 OpenAI 發送請求。
這不代表初次分析沒有等待時間,而是把「建立模型」和「操作模型」分成兩個階段。
回頭看前面的開發紀錄,Visual Learning Lab 大概經歷了四個階段。
最開始使用 Python、Streamlit 和 OpenAI Responses API,做出可以貼文字、上傳 PDF、摘要重點和整理概念關係的工具。
那時候最大的成果,是把 AI 的文字回覆整理成比較穩定的結構化資料,再轉成 Concept Map、Flow 等表示方式。
Day 6 開始把 PDF 原始檔案交給模型分析,而不是只擷取文字。後來也逐漸加入對圖片、圖表和來源頁面的處理。
但這個階段有個明顯問題:即使圖畫得很漂亮,很多時候它仍然只是一張圖。使用者看完之後,沒有太多可以操作的事情。
於是後來加入了引導式學習、複習、數學圖形、動態模擬和不同類型的 Learning Scene。
這時候開始遇到比較像工程問題的困難。
例如,AI 生成一個物理模型時,如果把不合理的數值直接交給渲染器,可能產生錯誤甚至讓介面出問題。因此不能只要求模型「盡量輸出正確格式」,而是需要程式自己檢查哪些規格允許執行。
這也是為什麼後來逐漸採用 Structured Outputs、驗證器和受限制的執行環境。
AI 負責提出它理解到的概念與模型候選,程式則負責確認資料是否符合規格,並決定能不能執行。
Day 19~20 也開始建立 Source Atlas 和來源幾何處理,希望模型產生的概念不要跟原始教材完全斷開。
這一段算是整個專案方向最明確的時候。
我們把 Learn、Source、Explore 和 Practice 整合進同一個工作區,加入表示方式規劃、語意驗證和直接操作,最後形成 Grounded Semantic Twin 的設計。
我希望它不只是「AI 看完 PDF 幫我畫圖」,而是可以回答:
最後一點特別重要。
系統不應該為了看起來厲害,就幫每個概念硬加一個可以拖動的控制點。沒有經過驗證的操作關係,寧可不要提供。
Day 26 把功能收斂成一條比較完整的展示路線:Source → Interactive Twin → Manipulation → Source。
我們使用真實的 MIT OpenCourseWare 物理教材,而不是專門為系統編寫的範例。在拋體運動案例中,從來源圖選取水平初速,開啟互動模型,拖動速度向量,觀察軌跡和計算數值改變,再返回原始 PDF。
這次操作也暴露了一些問題。例如來源中的概念選擇入口不夠明顯,返回來源後還可能找不到先前的 Atlas。後來把這些問題修正,才完成那條真正可重複操作的流程。
Day 27 則開始測試陌生教材,而不是只拿熟悉的成功案例展示。Day 28 檢查操作體驗,Day 29 處理安全、授權和 API 成本。最後則把系統推到 Streamlit Cloud,進行部署與登入驗證。
到了這個階段,我已經比較少在問「還能增加什麼功能」,反而開始問「哪些功能真的有證據支持」。
這次開發大量使用 ChatGPT 和 Codex。很多程式不是我一行一行從頭寫出來的,但這不代表可以不理解它在做什麼。
我必須知道自己要解決什麼問題、模型的假設是什麼、測試究竟驗證了哪些事情,以及什麼結果不能接受。
其中一個印象很深的例子,是參數驗證器。
曾經有一個情況,系統把高度為 0 的情境判定成不合法。問題在於我們把「某些物理量必須大於 0」寫得太粗略,導致合理的零高度被拒絕。
但反過來,如果為了讓高度 0 通過,直接把所有長度類參數改成可以等於 0,也會產生另一種錯誤,例如把半徑或波長為 0 當成合法情況。
最後必須把參數的物理種類,和它真正允許的數值範圍分開處理。
另一個例子出現在 Day 27。
模型有時會把來源中用來描述結果的數字,誤認成可以調整的參數。例如迴歸分析裡的相關係數,或機率教材中的特定機率值。
從畫面上看,這些數值確實可以做成滑桿;但從教材語意來看,不能把作者已經給定的觀察結果直接改掉。
後來我們加入來源固定值、來源變數、假設性探索值和推導值等不同類別,讓探索模型可以產生變化,卻不會因此冒充原始教材。
這類問題是我覺得 AI 開發很容易忽略的地方:程式執行成功,不一定代表它在表達正確的意思。
如果只有展示成功畫面,其實很難知道系統碰到不同教材會怎麼樣。因此後期留下了不少測試紀錄,也刻意把工程測試、語意審查和使用者測試分開。
Day 27 使用十份陌生的真實教材。第一次工程契約檢查有 8 份通過、2 份失敗;在另外進行的人工語意審查中,初次結果是 4 PASS、4 PARTIAL、2 FAIL。
修正系統性問題後,後續檢視的結果是 5 PASS、5 PARTIAL、0 FAIL,但這不是新的一批獨立測試,因此不能把它寫成模型突然有了 100% 的正確率。
Day 28 使用五種 Codex 模擬的瀏覽器操作情境,找到了控制入口不明顯、離線範例與付費生成入口容易混淆、來源頁面範圍不直觀等問題。這些是 AI 模擬操作,不是五位真人參與者,更不能拿來證明學習成效提升。
Day 29 的完整回歸為 515/515 通過。後續加入受限公開 AI 功能後,另一階段的完整回歸達到 548/548 通過。
截至最後一輪雲端修正,Codex 回報 53 項 focused tests 和 553 項完整回歸通過,且沒有執行新的真實付費 API 請求。
這些數字分別來自不同開發階段,不能直接加在一起,也不表示所有真實使用情境都已經得到驗證。
最重要的限制依然存在:模型不保證理解任何 PDF 都正確,來源位置與概念對應也可能不完整。系統需要在不確定的地方提供 fallback,而不是假裝每份文件都能生成完美的互動世界。
這是一個我自己也反覆想過的問題。
如果只是把 PDF 上傳,讓 AI 摘要、解釋、舉例,那其實直接使用 ChatGPT 就已經很好了,沒必要另外做一個網站。
所以 Visual Learning Lab 不打算靠「比 ChatGPT 更會回答問題」來證明價值。
我想嘗試的是把 AI 分析結果保留下來,轉成受限制、可操作、可回溯的學習物件。
使用者不必每次都重新描述「請把振幅改小一點,再畫一次」。當某個互動模型已經建立好,後續就可以直接調整參數、看到變化,再回到教材中的支持來源。
而且修改的是探索狀態,不是偷偷修改 PDF 中的原始敘述。
當然,這不代表 Visual Learning Lab 已經被證明比 ChatGPT 更能提升學習成效。要回答那個問題,需要公平的比較任務、真正的參與者,以及合理的學習前後測。
目前能說的是:它提供了一種不同的互動流程。至於這種方式對不同類型的學生到底有多大幫助,還需要更多實際測試。
Day 29 之後,我也嘗試把作品真正放到線上。
最開始還覺得只要 GitHub Push、Streamlit Deploy 就結束了。結果接著遇到 Google OAuth 的 callback 設定、Client Secret、Neon 資料庫、API 費用,以及不同環境下的部署問題。
這讓我第一次比較完整地理解:自己電腦上能跑的作品,和能讓陌生人使用的網站,中間其實還隔著一整段工作。
目前 Visual Learning Lab 已經部署到 Streamlit Cloud,Prepared Demo、Source、Explore、Practice 的雲端測試流程已經通過,Google 登入與登出也完成了實際驗證。
但受限付費 AI 雖然已經實作帳號額度、每日次數、全站並行和 USD 10 的應用程式帳本控制,真正的 Neon 帳本初始化、應用程式持久化與付費請求驗收仍未完成。因此目前保持付費生成關閉,不把它當成已經正式公開的服務。
這是刻意保留的限制,不是把尚未完成的部分藏起來。
專案連結:
網站目前已部署,Prepared Demo 可在已驗證的雲端環境操作;是否開放所有匿名訪客,仍以網站實際分享權限為準。受限付費 AI 尚未開放。
展示所使用的 MIT OpenCourseWare 教材保留原始來源與授權標示,相關內容依 CC BY-NC-SA 4.0 條件使用。
一開始使用 AI 寫程式,最大的感覺是快。把需求告訴 Codex,就能很快看到畫面和功能。以前可能需要花很多時間研究的事情,現在可以先做出一個版本,再從實際結果開始學習。
但做到後面,我反而覺得 AI 開發最困難的部分,不是讓它把程式寫出來。
它可以產生看起來很合理的模型,也可以替自己的程式寫測試,甚至給出一份漂亮的完成報告。真正麻煩的,是我必須回頭問:這個模型有沒有違反教材原意?這個測試是不是只證明它通過了自己設計的情境?如果使用者不照預期操作,系統又會怎樣?
有時候一個小小的質疑,會迫使整套驗證規則重新整理。這些修正未必能讓畫面變漂亮,但會讓作品慢慢變得比較可靠。
回顧整個過程,ChatGPT 幫我釐清問題、討論設計與分析結果;Codex 負責大量程式實作、測試和工程整理;而我自己必須決定到底要做什麼、哪些結果可以接受,以及什麼地方還需要繼續追問。
對我而言,這比單純完成一個 AI 網站更有收穫。
30 天前,它只是一個希望讓教材更容易理解的想法。現在,至少已經有一個能從來源進入互動模型、修改狀態,再返回原始教材的實際系統。
它還不夠完整,也還沒有證明自己能改善多少學習成果。但我已經知道下一步應該補的是什麼:更可靠的跨教材理解、更清楚的操作引導,以及真正有對照組的使用者學習測試,而不是一直增加更多功能卡片。
這 30 天先寫到這裡。
謝謝一路看下來的人,也謝謝曾經提出意見、指出問題的人。如果你有看過這個專案,覺得某些地方難用,或者有特別希望它能處理的教材類型,也歡迎告訴我。
我會繼續做下去。


 iThome鐵人賽
 看影片追技術