
Ep22 讓我先用 Spark UI 將「job 很慢」拆成 Job、Stage、task 與 Executor 層次。當我在 Tasks table 發現少數 task 明顯落後,第一個值得驗證的方向是 data skew:是不是某些 key 將遠多於其他資料送進同一個 shuffle partition?
這次我用同一個 Spark application 跑兩組對照。兩組的資料量、Executors、task slots、shuffle partitions,以及每列資料要做的 CPU work 都固定;唯一改變的是 shuffle key 的分布。我要看的不是「某個設定能不能讓 job 更快」,而是 key 集中如何一路變成 UI 上的一個 straggler task。
Ep22:Jobs → Stages → Tasks → Executors
先找到慢的範圍
        ↓
Ep23:data skew
key 集中 → shuffle partition 不均 → straggler task → Stage 等待
        ↓
Ep24:join 策略與 shuffle 成本
找出 query 為何建立這些資料交換
這集刻意只驗證 skew 的證據鏈。salting、AQE skew join 與其他修正方式都需要回到真實 query、資料量與 join 條件判斷,不會在這裡先當成萬用答案。
shuffle 會依 key 將資料送往下游 partitions;一個下游 partition 對應一個 task。若大量 rows 使用同一個 key,它們會一起進入同一個 partition,讓其中一個 task 接到大部分工作。
均勻的 key 分布
rows → 8 個 shuffle partitions → 8 個 task 的工作量接近
                                      ↓
                                  Stage 很快收斂

集中的 hot key
大部分 rows → 同一個 shuffle partition → 1 個 task 特別重
其他 tasks 已完成 ──────────────────────→ Stage 仍等待這個 task
這裡的關鍵是 Stage 的完成條件:所有 task 都必須完成。七個 task 很快結束,不會抵銷最後一個 task 所花的時間。
data skew 先是資料分布問題;在 Spark UI 裡,它會呈現為少數 task 的資料量和執行時間異常突出。
實驗沿用兩個 2-core Workers,共四個 task slots。每個 phase 都建立 600,000 rows,要求八個 shuffle partitions,並在 shuffle 後對每列資料跑相同、固定的 Python CPU loop。這段 CPU work 只是讓筆電上的 task duration 隨 rows 數拉開,並不代表真實業務轉換。
兩組的差別只在 key:
| phase | key 分布 | 預期的下游 task 形狀 |
|---|---|---|
| baseline | 64 個 key 反覆出現 | 每個 partition 都取得數萬 rows。 |
| skew | 約 90% rows 使用 key 0 |
承接 key 0 的 partition 取得絕大多數 rows。 |
核心 pipeline 很短:先依 key 建立 shuffle,再讓每個 post-shuffle partition 對收到的資料做一樣的工作,最後只回傳一個小型結果。
(
    events.select(F.col(key_column).alias("key"), F.col("value"))
    .repartition(8, "key")
    .rdd.mapPartitions(fixed_cpu_work)
    .collect()
)
若只用 groupBy().count() 來做這個實驗,map-side aggregation 可能先把大量相同 key 合併,使下游看不到預期的 rows 差異;因此我讓每個 row 都穿過 shuffle 後的 mapPartitions。
另外,我將 AQE 關閉,保留程式明確指定的八個 shuffle partitions。這是為了穩定觀察,不是一般 job 的預設建議。
baseline Job 有兩個 Stages、16 個 tasks,Jobs 頁顯示 duration 為 4 秒。DAG 中第一個 Stage 將資料依 uniform_key 寫入 shuffle;下游 Stage 再讀回這些 shuffle blocks,執行每列固定的 CPU work。
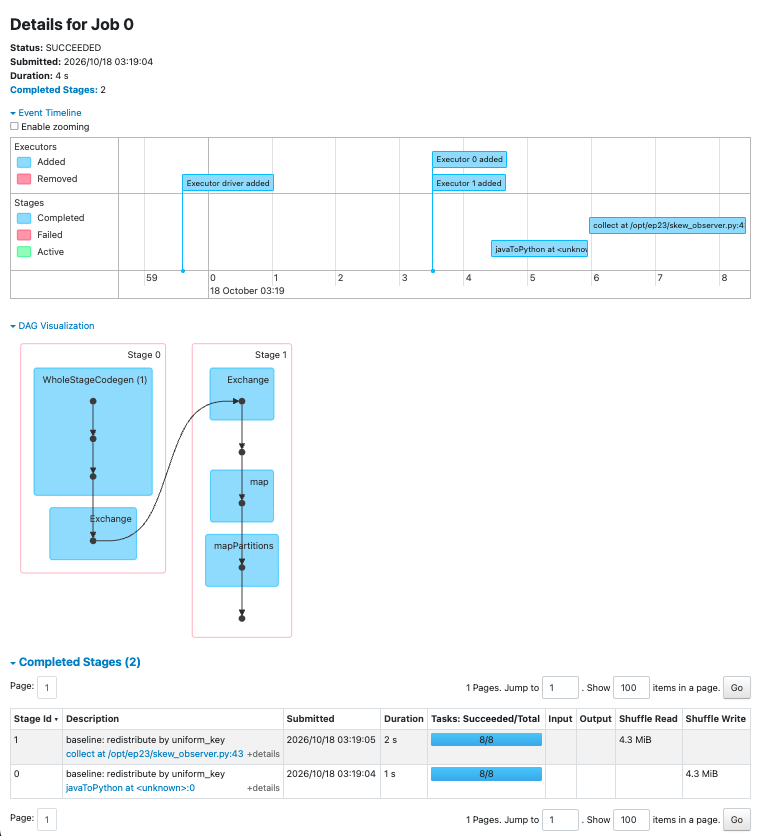
下游 Stage 有八個 tasks。Event Timeline 顯示前四個先取得四個 task slots,空出 slot 後其餘 tasks 才開始;這是 Ep16 看過的正常排程節奏。
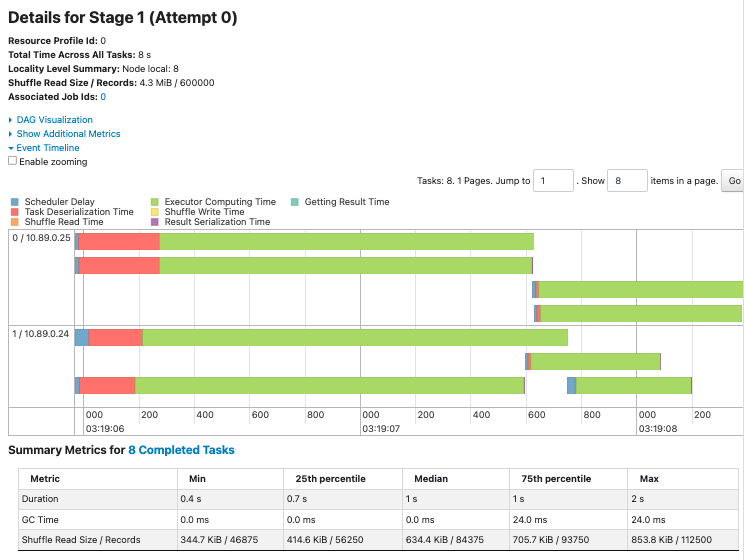
Tasks table 顯示它們各讀到 46,875–112,500 records,Shuffle Read 約 345–854 KiB,duration 約 0.4–2 秒。
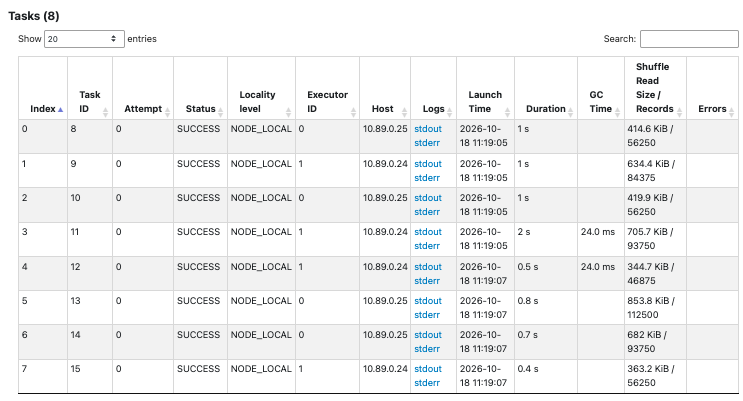
我原先把「64 個 key 均勻出現」直覺地想成八個 partition 會完全相等;畫面修正了這個想法。repartition(8, "key") 是 hash partitioning,64 個有限 key 映射到八個 partitions 時仍會有碰撞數量差異,所以這裡落在約 4.7 萬到 11.3 萬筆。它們都仍是數萬筆等級,沒有任何一個 task 壟斷資料或拖住 Stage。
第二個 phase 只將 key 分布改成約 90% rows 使用 key 0。Jobs 頁上 baseline 與 skew 都顯示 4 秒;這個小型實驗的 whole-job 時間不足以支持細緻比較,因此我回到同一個診斷順序:看下游 Stage 和它的 tasks。
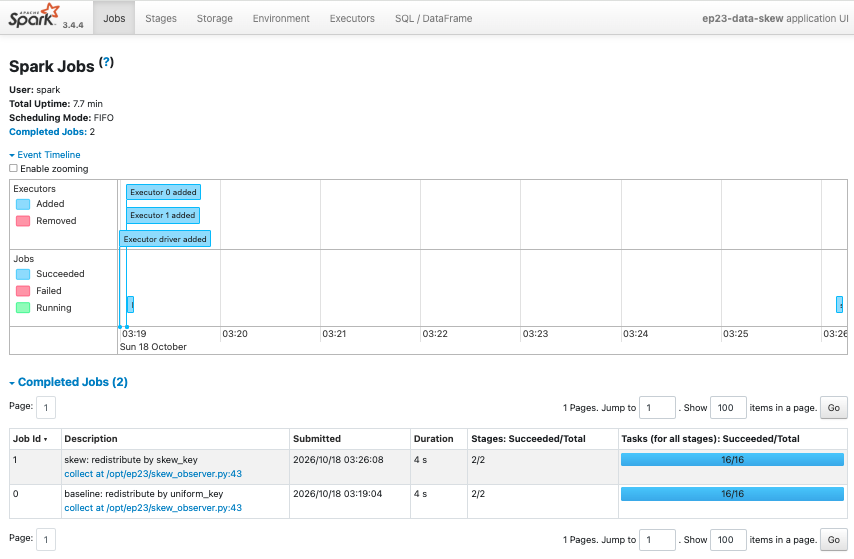
skew Job 的 DAG 仍是同樣的兩個 Stages,並沒有突然多出新的 transformation。差異只出現在資料進入 Exchange 後如何被分配。
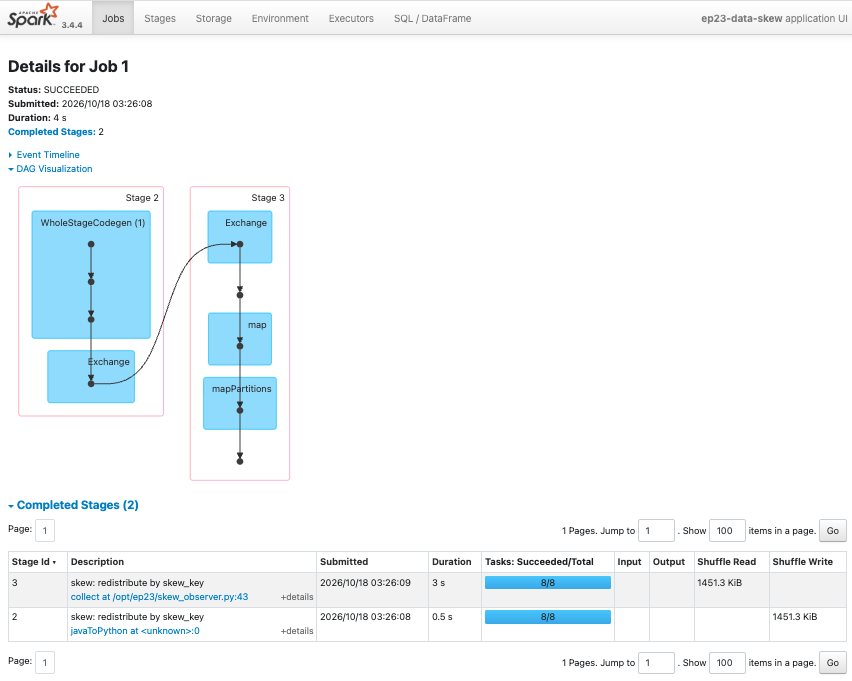
這次下游 Stage 的 Event Timeline 明顯不同:大多數 task 很快完成,但一個 task 在其他 tasks 都結束後還持續運算。
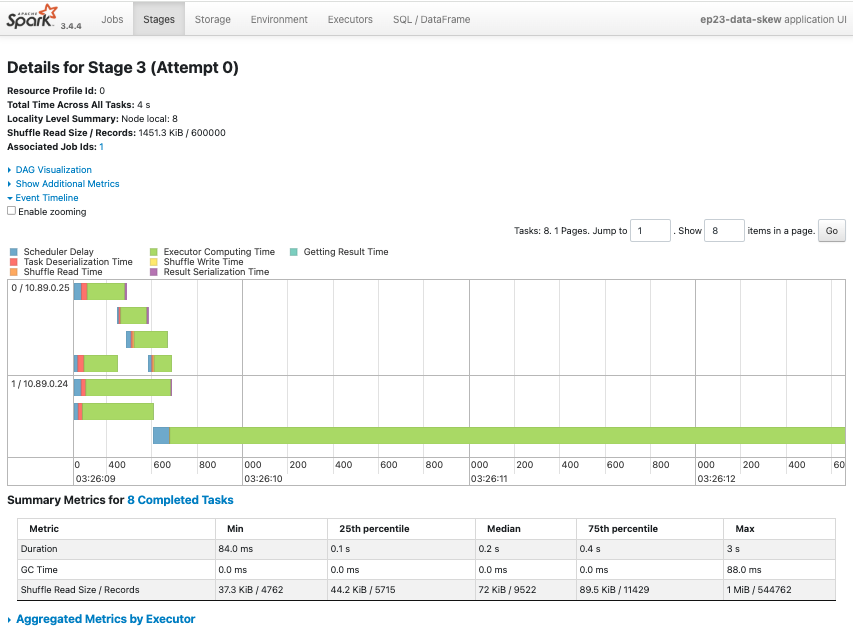
Tasks table 將原因量化了:最慢的 task 讀到 544,762 records、1 MiB Shuffle Read,duration 是 3 秒;其他七個 task 各只有 4,762–11,429 records、約 37–90 KiB,duration 只有 84 ms–0.4 秒。
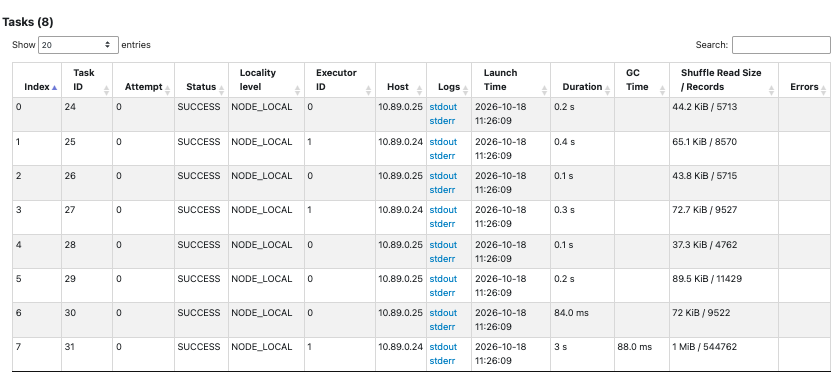
最慢 task 接到約 544,762 / 600,000 ≈ 91% 的資料。它比其他 task 慢,並不是因為 Spark 隨機把同一份工作拖慢,而是它真的拿到了遠多於其他 task 的 rows,於是固定 CPU work 也跟著集中。這讓我能從 UI 的三組數字把因果鏈接起來:
hot key 集中
    ↓
一個 shuffle partition 收到 544,762 records
    ↓
對應 task 的 Shuffle Read 最大、CPU work 最多、Duration 最長
    ↓
Stage 等它完成
baseline 的 Executors 頁顯示 application 使用四個 cores、完成 16 個 tasks,並彙總整個 application 的 Shuffle Read/Write 與 GC time。
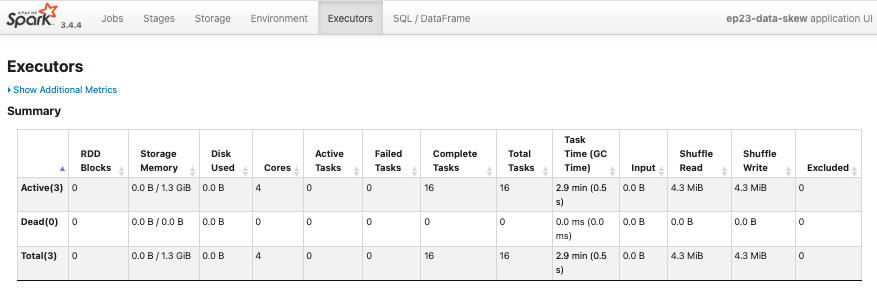
這頁很適合確認 Executors 是否存在、是否有 task 集中到特定 Executor,或是否有 GC、spill、failed tasks 等另一條線索。但它把多個 tasks 彙總在一起;單看某個 Executor 的 task time 較高,無法知道是資料 skew、Node 狀態、GC,還是 task 剛好被排到它。因此我會先從 Stage 的 Tasks table 找出落後 task,再用 Executor 資訊交叉檢查。
這個實驗刻意把原因直接寫進 key 分布;真實 job 沒有這麼直接。當我看到「少數 task 的 records、shuffle read 和 duration 同時很高」時,下一步會回到那個 Stage 的 lineage、DAG 和 SQL/DataFrame 程式:
groupBy、repartition 或 join 建立了這次 shuffle?NULL、default value、熱門使用者、熱門商品或其他集中值?這個順序讓我先驗證資料分布,再決定是否需要討論調整方式。只增加 Executor 數量或 cores 可能讓部分工作更快開始,但不會自動把同一個 hot key 拆給多個 hash partitions。
看到一個長尾 task 時,先比對它的資料量與 shuffle 指標;它若明顯大於同 Stage 的其他 task,data skew 是一個有證據的假設。
data skew 不只是「有些 key 比較多」的抽象描述。Spark 將資料依 key shuffle 後,這個不均會具體變成某個 partition、某個 task 和一段 Stage 尾端等待時間。
這次 baseline 也提醒我,hash partition 不保證有限 key 集合完全均分;我真正該找的是是否存在像 544,762 對數千筆這樣的極端差異。下一篇會把焦點放在常常引入這種 shuffle 的 join:Spark 何時能 broadcast 小表,何時需要交換兩邊資料,以及該如何從 plan 和 UI 辨識成本。
🚀 GitHub:
Ep23|為什麼只有一個 task 特別慢?從 data skew 看懂 Stage 為何卡住
🚀 spark-learning-lab 系列文章與實作:
https://github.com/jeffery5bai/spark-learning-lab
Apache Spark 3.4.4 — Web UI:
https://archive.apache.org/dist/spark/docs/3.4.4/web-ui.html
Apache Spark 3.4.4 — Performance Tuning:
https://archive.apache.org/dist/spark/docs/3.4.4/sql-performance-tuning.html

 jeffery5bai

 iThome鐵人賽
 看影片追技術