
封面為本次對比主題示意,非產品介面截圖。
結論先講:程式碼修復、從零實作和工具編排共9題,兩個模型都通過。V4-Pro平均每題總耗時11.7秒,M3為29.1秒;M3本輪總花費低約17.6%。M3會把思考文本混入正文,19道題每題至少有一個回合出現。依原始輸出判分,M3加權通過率為0.850,V4-Pro為0.950。這些結果只代表本次題目與接入方式。
這個結論和我一開始的判斷並不一樣。中間我改過兩次看法,原因寫在下面。
一開始我的想法很簡單:找一份公開排行榜,挑分數高的那個用就好。
實際測試前我先做了預演,發現行不通。公開榜單量的是廠商最佳配置下的通用能力,回答不了我真正想知道的三件事:在我自己的呼叫方式下它多久回一次、跑完一輪任務要花多少錢、它的輸出能不能直接餵給下游程式。
這三件事都跟接入方式綁在一起。同一個模型換一家服務商,延遲、限流和計費方式都會變。於是我改成自己測,只用自己跑出來的資料。
預演階段我犯了一個錯:兩個模型分別在不同時間、不同腳本裡跑,然後拿兩份結果相比。
後來意識到這根本不成立。時段不同、腳本不同、重試策略不同,任何一項差異都會被記成「模型差異」。我全部重來,改成兩個模型掛在同一個入口、同一套參數、同一支腳本裡交替執行。
修正之後的設定是這樣:19道題分七類,掛在同一個入口(https://api.crazyrouter.com/v1的 /chat/completions),模型分別是MiniMax-M3和deepseek-v4-pro,輸出上限8192。工程題允許模型自己讀檔案、寫檔案、執行Python,改到測試通過為止。
判定方式不是我看它說得像不像,而是真的去執行那個測試檔案,看退出碼。
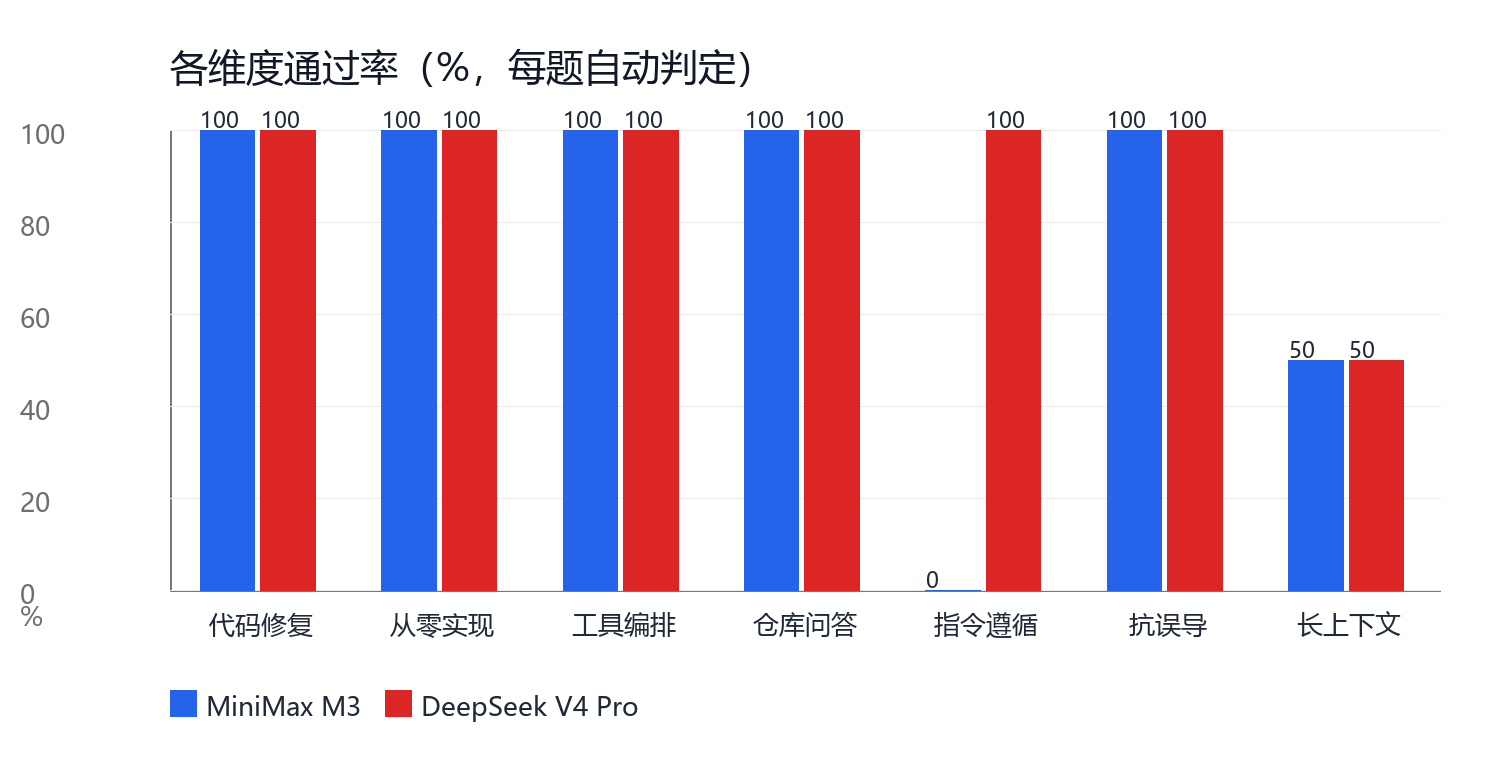
19道題逐題自動判定,2026年10月20日實測。
| 維度 | 權重 | MiniMax M3 | DeepSeek V4-Pro |
|---|---|---|---|
| 程式碼修復 | 20% | 3/3 | 3/3 |
| 從零實作 | 20% | 3/3 | 3/3 |
| 工具調度 | 20% | 3/3 | 3/3 |
| 儲存庫問答 | 10% | 3/3 | 3/3 |
| 指令遵循 | 10% | 0/3 | 3/3 |
| 抗誤導 | 10% | 2/2 | 2/2 |
| 長上下文 | 10% | 1/2 | 1/2 |
程式類9道題,兩個模型一道都沒掉。差的是「指令遵循」那一行,0比3。
看起來像能力差距,但輸出格式也影響了判定。M3的思考過程和最終答案共用同一個欄位,<think>標籤直接混在正文裡。按執行時逐回合記錄,19道題每一道都至少有一個回合出現這種混流;V4-Pro是0道。
影響最直接的是三道固定格式題。按原始輸出,三題都未通過。復核未截斷的記錄後,前兩題答案內容符合要求,但前面混入思考文本;第三題的答案仍在未閉合的思考區塊中,無法直接提取為正文。因此不能說三題剝除思考後全部通過。
這裡要交代一件事。我原本還算過一個「剝掉思考後M3能漲多少分」的數字,後來撤掉了。原因是結果檔把答覆截斷在600字元,而思考排在答覆前面,所以思考長的題目,落盤的600字元可能全是思考,真正的回答根本沒被存下來。剝掉思考當然什麼都不剩——這不是模型沒回答,是我的樣本在儲存環節被截斷了。
判分用的是記憶體裡的完整文本,截斷只發生在寫記錄那一步,所以0.850對0.950這兩個總分是可靠的。但這類二次統計,必須存全文才成立。
長上下文那組有一道題:一份400行的維運日誌,金鑰藏在第288行。
M3翻到了,直接回傳正確的值。V4-Pro六輪全在呼叫工具讀檔案,累計讀了42766個輸入token,從頭到尾沒有輸出任何正文。
它不是答錯,它是沒有停下來。
這種失敗方式在任何排行榜上都看不見,因為它連一個錯誤答案都沒交出來。但它會實實在在變成帳單和等待時間——你付了四萬多個輸入token,換到一個空字串。
也是這一題讓我改變判斷:原本我以為V4-Pro全面佔優,實際上在「在一大堆資料裡翻出某個東西」這件事上,M3這次表現更好。
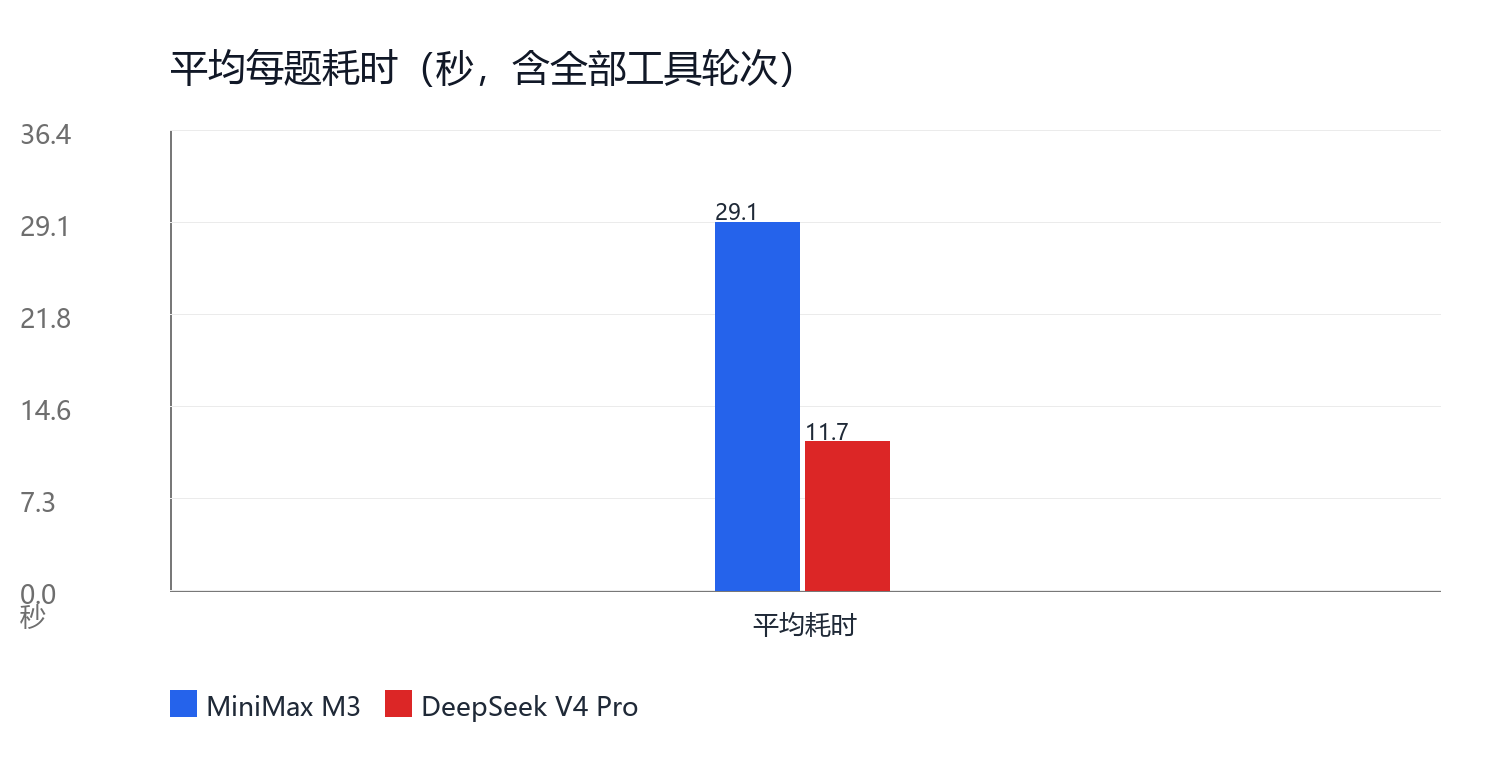
含該題全部工具輪次的總耗時,不是單次請求延遲。
| 指標 | MiniMax M3 | DeepSeek V4-Pro |
|---|---|---|
| 平均每題耗時 | 29.1秒 | 11.7秒 |
| 平均每題輪數 | 4.1 | 2.9 |
| 平均每題輸出token | 908 | 470 |
| 19道題總花費 | 0.061美元 | 0.074美元 |
速度差在輪數上,M3平均要磨4.1輪才收工。成本差距沒有單價看起來那麼大:M3雖然單價較低,但消耗的token更多;本輪合計仍比V4-Pro低約17.6%。
這裡也要修正一個判斷。預演時我單獨測了一道小bug題,V4-Pro在一句話就能說清的題目上燒了1600多個思考token,換算下來貴10.6倍。我一度以為找到重點了,但放大到19道題就不成立。單題的極端值不能外推。
| 你是哪類使用者 | 建議 | 理由與限制 |
|---|---|---|
| API工程師:輸出要接JSON解析器或自動化流程 | 優先試DeepSeek V4-Pro | 本輪三道固定格式題都通過;接入前仍要拿自己的提示詞驗證完整輸出協定 |
| 做客服、助理等互動產品的團隊 | 先試DeepSeek V4-Pro | 本輪平均每題總耗時11.7秒,M3為29.1秒;不是單次請求延遲 |
| 維運批次工作的團隊,優先考慮帳單 | 將M3放進自己的小流量測試 | 本輪總花費低約17.6%,但換成真實工作負載後比例可能不同 |
| 主要做程式修復、實作和工具編排的開發者 | 兩者都值得試 | 這9題雙方都通過,這個小樣本無法說明哪家普遍更強 |
| 經常查長日誌、長文件的人 | 暫無明確勝者 | 雙方各通過1/2,通過的是不同題,需用自家資料再測 |
| 已在使用M3、要把答案交給程式的團隊 | 先驗證輸出協定與失敗處理 | 確認思考欄位、正文格式及區塊閉合;未閉合時把答案視為不可用,不要直接剝標籤 |
換模型的成本很低,同一把金鑰可以呼叫目錄內全部模型,改一個模型名稱就行,接入說明見DeepSeek V4 Pro模型頁。
如果你要直接把答案送進程式,先試V4-Pro並用真實請求做格式驗證;如果你更在意批次成本,讓M3跑一小批自家任務,再看每個有效結果的實際花費。長文件與一般聊天使用者,這19題還不足以替你做決定。
這是OpenAI相容接口、每題一次的結果。它能幫你縮小候選範圍,不能代替你的工作負載測試。

 18924485322

 iThome鐵人賽
 看影片追技術